问题背景
场可编程量子阵列执行电路时,两比特门要求把原子搬到彼此邻近处(阻塞 CZ 门),搬运由 AOD 动态镊子完成。以往编译研究(OLSQ-DPQA 的 SAT/LSQ 框架、DasAtom 的分治穿梭、PowerMove 的分区调度等)大多优化”给定布局序列下执行门块的代价”,或按预设规则在门执行后调整布局以缩短移动距离;Nakaji 等人提出换个视角:布局本身就是一个可以边执行边控制的博弈状态——模仿电子游戏这类强化学习测试床,把”寻找最大化电路保真度的器件操作序列”命名为量子电路博弈(QC-Game),其求解器称为量子电路守护进程(QC-Daemon)Nakaji 2025。
QC-Game 与通常所说的”量子编译”目标不同且互补:编译在软件层把目标电路化简为更短等价电路,QC-Game 则控制器件状态、让同一电路在特定处理器上以最高保真度实现;它与布局综合(layout synthesis)相关,但大多数布局综合只逐层优化 内部的约束,QC-Game 以全局信息约束整个剩余序列。本路线也把 RL 引入此前由启发式主导的中性原子编译,是首个面向中性原子的 AI 编译器方案 Nakaji 2025。
具体实例化是”原子博弈”(Atom Game):采用带存储区/纠缠区的分区架构,电路先分解为可并行两比特门块序列 (每块内各门作用在不相交的量子比特上,可在一步内实现;单比特门可局域高保真执行,暂不纳入搬运综合),每个时间步重复四步——存储区内重排到 、把参与门块的原子在纠缠区搬到相邻位置、整批并行 CZ、全部搬回原位进入下一块 Nakaji 2025。
理论模型:MDP 与代价结构
QC-Game 是四元组 :状态 记录 个原子的格点位置( 为行列坐标);转移 依赖于具体器件(仿真中取确定性);策略 显式接收当前时刻与未来全部剩余门块——这是 QC-Daemon 的”前瞻”特征。目标即折扣回报最大化
其中 是布局变更 的搬运代价, 是布局 下执行门块 的门代价,末项是以初始布局为参照的基线(保证”不重排”是奖励零点)。所有代价共享线性模型
为搬运时长( 为比特总数,系数 是每比特相干时间的倒数——对应搁置退相干误差), 为被”触碰”(拾起/放下)的原子数( 为单次触碰的固定保真度损失)。数值实验取 、 Nakaji 2025。
冲突图与搬运次数估计
与以往显式构造 AOD 移动序列来计算重排代价不同,QC-Daemon 只需估计代价上界,从而把逐比特决策与底层运动学解耦。给定布局变更,把处于活跃行/列的原子标记为活跃参与者 (包括被”顺带带走”的不动原子),构建冲突图 :两个移动若不能并行则连边。边对应两类 AOD 硬约束——“多对一”约束(一条 AOD 行不能分裂为多行、多行不能并成一行)与”次序”约束(行/列移动中不得交叉换序)。一次并行移动对应冲突图的一个独立集,故最小移动轮数即图色数(NP 完全问题);由 Brooks 定理(色数上界为最大连通度),贪心着色给出估计
为冲突图最大连通度;若配合交换区的分治 MaxCut 启发式不断拆分冲突图,轮数还可降至对数深度 ( 为分割指数)。单步特征时间取恒定加速度下的 ( 为加速度量纲常数),触碰数按 (,即每步约移动一半原子)估计;门代价 则按两步近似——先在存储区内把门对搬到相邻(中间态 )、再并行移入纠缠区执行 Nakaji 2025。
方法与实现
QC-Daemon 按”逐原子自回归”分解动作:对 步的可玩原子集 ——由未来 个门块(Window Size 超参数)涉及的全部量子比特组成——策略分解为
每个动作只指定该原子的下一格点,且前序原子的动作进入后续原子的条件。网络分两路提取特征 Nakaji 2025:
- 静态特征(与电路和已规划动作无关):用 MLP-Mixer 把布局独热编码当作”图像块”处理(空间混合 + 通道混合两类 MLP),输出每个格点对当前原子的先验吸引力 ——哪些阱位”天然宜居”;
- 动态特征(依赖电路与已规划动作):两个结构相同的 Transformer——Gates Transformer 编码前瞻 层(Horizon-Length 超参数)门块内非 PA 门与当前原子 PA 门的耦合关系,Moves Transformer 编码已规划移动与候选移动的关联;两者的原子/格点嵌入均以”目标位置减当前原子位置”的相对编码给出,注意力掩码屏蔽非法信息流(如从零嵌入位置、跨位流限制)。
两路输出经平均池化 聚合后,逐格点打分 ,按 softmax 采样(已占格点屏蔽);价值头对未屏蔽格点取平均后过 MLP、与静态特征分别输出再求和,供 actor–critic 算法使用。训练算法为 PPO;“从零训练”实验在 8 块 NVIDIA H100 上进行,可迁移实验用 6 块 Nakaji 2025。
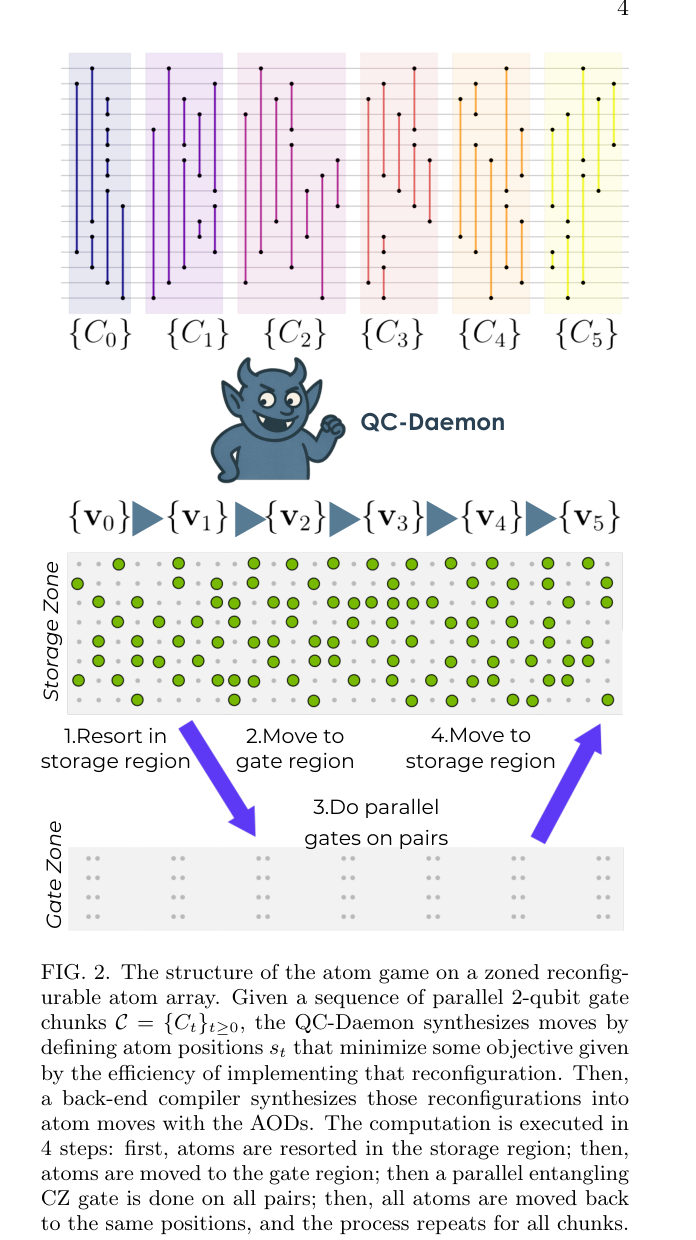
分区阵列上的原子博弈四步循环:存储区重排→搬运→并行 CZ→搬回(图源:Nakaji 2025 Fig. 2)
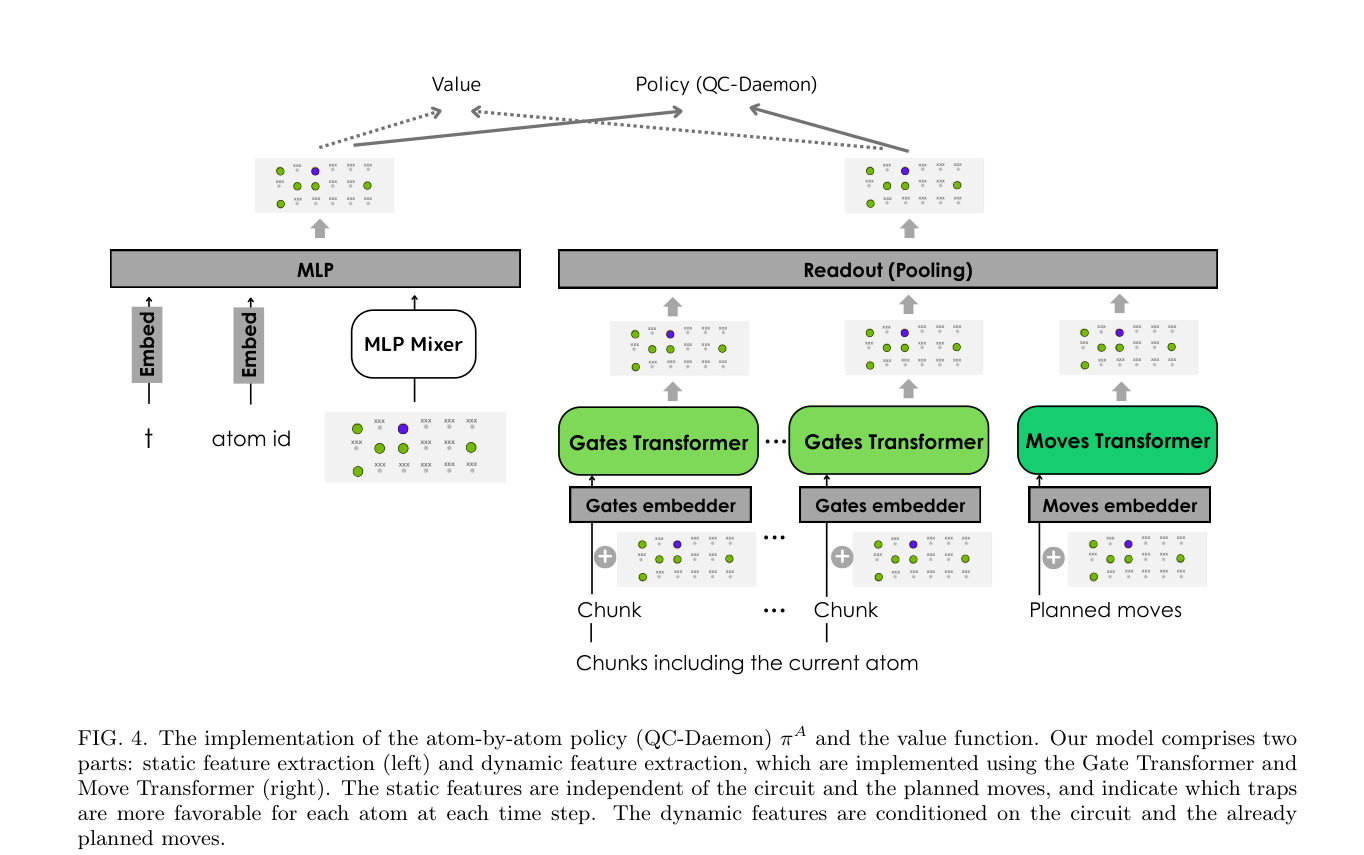
QC-Daemon 架构:静态 MLP-Mixer 特征 + Gates/Moves 双 Transformer 动态特征(图源:Nakaji 2025 Fig. 4)
实验结果与对比
从零训练(每个电路单独训练、再用于原电路):基准取 MQT Bench 的 qaoa/groundstate(14 比特)、random(30 比特)、qnn(50 比特)与 hubbard/qft(100 比特,Fermi–Hubbard 一阶 Lie–Trotter 分解、重复两次、)。训练初期代价上升(无谓搬运),数千次迭代后转为正值,论文报告相对”不重排”基线的代价(对数不保真度代理)下降最高约 20%;同时改变布局的动作数量随训练锐减——智能体学会少动、动得准 Nakaji 2025。
可迁移性:只保留动态特征通路(注意力机制天然接受变长输入),训练集为 30 个哈密顿量(各含 40 项局域随机 Pauli 算符、40–50 比特、4 步 Trotter 化),每轮随机抽取一个、随机初始布局执行并更新;测试集为同法新造的 3 个未见电路。未训练模型使代价恶化 57%–92%(无谓搬运反而增加代价),训练后模型 1-shot 即稳定降低约 7%–10%:
| 测试规模 | 未训练(1-shot) | 已训练(1-shot) | 已训练(100-shot) |
|---|---|---|---|
| 48 比特(seed 0) | |||
| 46 比特(seed 2) | |||
| 97 比特(seed 0) | |||
| 92 比特(seed 2) |
对更大的 60 项哈密顿量、80–100 比特数据集重复同样流程,结论一致。推理开销:97 比特、436 个门块的测试电路在单块 H100 上生成全部动作耗时 12.83 s(1-shot)、18.32 s(10-shot)、87.02 s(100-shot)——多 shot 低于线性增长(大部分时间花在 GPU 上的动作生成;若奖励需要密集 CPU 计算,扩展性会变差)。这种免训练生成物理操作的能力对实用场景尤为关键 Nakaji 2025。
边界与展望:本文刻意只优化重排步骤以简化问题结构,编译管线的其他环节在特定电路上可能更重要——例如稀疏而重复结构的电路里,初始布局优化比动态重排更关键;把初始化等其他操作纳入 RL 编译器是留待后续的方向。原子博弈的操作本体(重排与门执行)被刻意抽象化,因此与任何重排/门执行协议兼容;但针对逻辑处理器的完整方案还需计入非横向门实现等额外交互,它们会改变 QC-Daemon 的优势幅度。作者亦展望:在多样电路上预训练的”布局变更基础模型”可以把可迁移性再推一层 Nakaji 2025。
与其他概念的关系
- QC-Game 是 强化学习量子控制的”编译层”推广:MDP/奖励设计与量子控制同构,只是状态从脉冲波形变为原子布局;其先驱是 RL 线路优化(深度 RL 优化门序列的开端)与 Quarl(RL+搜索的线路代价模型)。
- 博弈环境建立在分区架构与原子搬运与相干输运之上:冲突图的”多对一/不可交叉”两类约束正是 AOD 行列规则的形式化;对数深度重排启发式与最优重排与置换路由的置换视角互补。
- 应用可自然延伸到逻辑量子处理器:把原子组作为整体粗粒度移动(每组对应一个逻辑比特)可提升横向逻辑门的并行度;同一框架还可迁移到表面码编译——逻辑比特在拓扑码网格上”刻出”的区域随线路演化移动,其移动代价恰是 Atom Game 的抽象版本(braiding 或 lattice surgery 指令)。
- 与 ARGON 的 GNN 预测式编译同属”学习 + 原子阵列”:一个做布局选择(监督式预测)、一个做布局序列规划(RL),二者共同可进入编译器公平评测的对照框架。
- 门块执行本体是并行纠缠门;重排与门执行代价的加权结构,本质上把误差预算与真实建模中的搁置退相干与搬运误差折算成了单一标量。
参考文献
- K. Nakaji, J. Wurtz, H. Huang, L. M. Calderón, K. Panicker, E. Kyoseva, A. Aspuru-Guzik, “Quantum circuits as a game: A reinforcement learning agent for quantum compilation and its application to reconfigurable neutral atom arrays”, arXiv:2506.05536 (2025). NA132 · arXiv:2506.05536
- Z. Li, J. Peng, Y. Mei, S. Lin, Y. Wu, O. Padon, Z. Jia, “Quarl: A Learning-Based Quantum Circuit Optimizer”, Proc. ACM Program. Lang. (2024). NA130
- M. Nägele, F. Marquardt, “Optimizing ZX-diagrams with deep reinforcement learning”, Mach. Learn.: Sci. Technol. (2024). NA129
- J. Ruan, X. Fang, H. Zhang, A. Li, T. Humble, Y. Ding, “PowerMove: Optimizing Compilation for Neutral Atom Quantum Computers with Zoned Architecture”, Proc. 30th ACM ASPLOS (2025). NA031