问题背景
基于变换的线路优化沿着两条线展开:规则从哪来,以及规则怎么调度。Quartz 超优化解决了前者——自动枚举海量等价保持变换(Nam 门集 6206 条、IBM 门集 6881 条);调度的经典答案是代价回溯搜索:从当前线路出发穷举变换序列,丢弃代价超过阈值的中途线路。Quarl 的动机来自一个看似反直觉的事实:最优序列必须经过”代价上升”的变换 Li 2024。
以 58 个门的 barenco_tof_3(Nam 门集 )为例,在 6206 条规则、7 步以内可达的约 条线路中随机抽 200 条做广度优先搜索:超过一半的线路需要至少 4 次变换才能降低门数,6% 甚至需要 6 次以上;若禁止代价上升的变换,能找到的最好结果只有 46 个门,允许后可到 36——“先变差才能变好”的陷阱让贪心与浅层搜索双双失灵,也正是 RL(擅长延迟回报)的切入点 Li 2024。
理论模型
MDP 与目标函数
固定门集、变换集与代价函数后,线路优化形式化为 MDP Li 2024:
- 状态空间 :给定门集上的全部线路;
- 动作空间 :线路 上所有合法的变换应用;
- 转移 :确定性——,其余为零;
- 奖励:变换前后的代价差
训练目标即策略梯度标准型 ,。Quarl 用 PPO 的裁剪代理目标
其中 为裁剪参数。代价函数在全部实验中取总门数(也可换成 CNOT 数或保真度),理由是逻辑层优化不应绑定具体器件标定 Li 2024。
挑战一:百万级动作空间的分解
对千门线路直接学习”选变换 + 选子线路”的联合策略,动作数可达百万量级,且动作集随图结构每步都在变。Quarl 把 分解为位置空间 × 变换空间:, 是线路中的门(位置), 是全部变换。由于一条变换的匹配可由单个门定位,先选门 、再在 处的合法变换里选一条即可唯一确定动作,两个子空间都远小于乘积空间 Li 2024。
挑战二:变尺寸状态与分层网络
RL 通常把状态编码为固定维向量,但线路的大小与拓扑随优化不断变化,直接展平学到的表示无法泛化。Quarl 的关键假设是决策的局域性:在某处施加什么变换,主要由该门的邻域决定。于是用 层图神经网络(GraphSAGE 式消息传递)为每个门生成其 跳邻域的表示 ——单条表示只看局部,全部门的表示拼起来仍覆盖整条线路,且表示维数与线路规模无关 Li 2024。
由此得到三层架构:
- 门表示生成器:GNN 读线路图(节点特征为门类型嵌入,边特征为方向与所连比特),输出每个门的 跳邻域向量;
- 门选择器 :在所有门上给出分布,选一个”优化机会最大”的门;
- 变换选择器 :在所选门处的合法变换上给出分布。
训练采用单一演员–评论家架构的分层优势估计(hierarchical advantage estimation, HAE):只有变换选择器 被梯度上升更新(演员);评论家网络估计”在此门邻域施加最优变换”的价值,而门选择器直接复用评论家的估值——估值高意味着优化机会大。相比”演员同时学 、评论家估计整条线路价值”的朴素 PPO,这套设计让演员与评论家都面对固定尺寸( 跳邻域)的输入,训练显著更稳 Li 2024。联合损失为
是鼓励探索的策略熵正则(实验取熵系数 )。
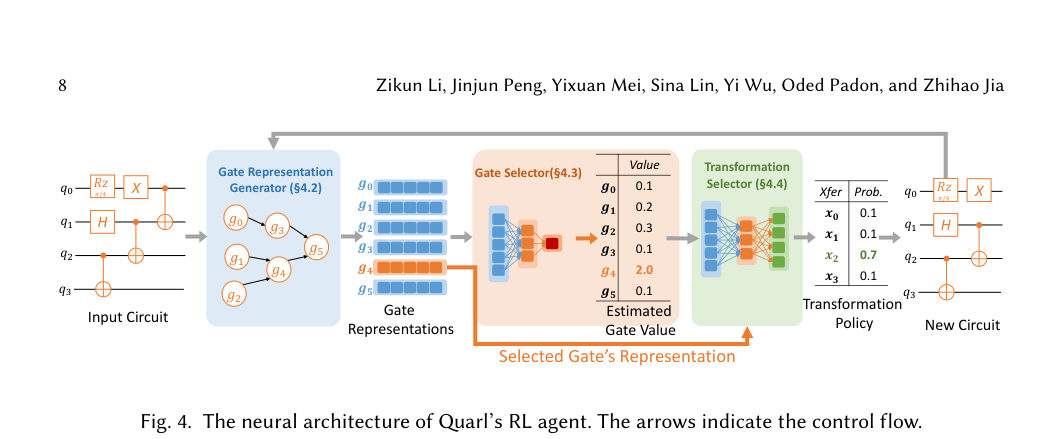
Quarl 的神经网络架构:GNN 门表示生成器 → 门选择器 → 变换选择器,评论家估值同时驱动门选择(图源:Li 2024 Fig. 4)
方法与实现
工作流分三段 Li 2024:
- 预训练:在 6 个拓扑各异的小线路(
barenco_tof_3、gf2^4_mult、mod5_4、mod_mult_55、tof_5、vbe_adder_3)上训练 8 小时(4 块 A100,数据并行,每 GPU 一个独立智能体采轨迹、同步梯度),初始线路缓存按等价类聚类采样,防止过拟合单一拓扑; - 微调:对新线路继续训练,让 GNN 权重与门估值适配该线路的局域结构;
- 策略引导搜索(policy-guided search):微调后的模型做确定性搜索——选门后不再采样而是取概率最大的变换;对触发停止条件的门加硬掩码、访问过的门加软掩码,保证整条线路被系统性扫过;一旦发现更低代价的线路,就清空初始缓存、以它为起点重启搜索。微调与搜索两进程并行、互通”新最低代价”消息。
超参数:轨迹长度 600、折扣 、演员/GNN 学习率 、评论家 、128(预训练)/64(微调)个并行演员;对每个输入线路总预算 6 小时(搜索超时 20 分钟,微调提前 5 分钟启动)。实现基于 PyTorch + DGL,图匹配复用 Quartz API(Cython 封装)。大线路用子线路划分把采样代价从 降为常数,代价是可能漏掉跨划分的优化机会 Li 2024。
保真度评估采用乘积模型 ,用 IBM Washington 的标定数据:CNOT 错误率 、 为 0、其余单比特门 ——两比特门比单比特门贵约两个数量级,这正是 CNOT 计数单独成列的原因 Li 2024。
实验结果与对比
| 指标(几何平均降幅) | Quarl | 现有最优 | 场景 | 来源 |
|---|---|---|---|---|
| 总门数(Nam 门集) | 对比 Nam/VOQC/Qiskit/TKet/Quartz | Li 2024 | ||
| CNOT 数(Nam 门集) | 同上 | Li 2024 | ||
| 总门数(IBM 门集) | 对比 Qiskit/TKet/Quartz | Li 2024 | ||
| CNOT 数(IBM 门集) | 同上 | Li 2024 | ||
| 线路深度(Nam 门集) | 同上 | Li 2024 | ||
| 保真度提升(IBM 门集) | 最高 ,平均 | 最高 | 乘积保真度模型 | Li 2024 |
两点尤其值得注意。其一,Quarl 在所有 Nam 门集基准线路上超过 Quartz,包括小线路——回溯搜索把代价超阈值的中途线路直接丢弃,因而系统性错过”先升后降”的优化序列,而学习式调度天然接受延迟回报。其二,旋转合并(rotation merging,合并相位多项式相同的 门)本是远距离的非局域优化,通常要手工集成进优化器;Quarl 从自己的探索中自动发现了等价于旋转合并的局部变换序列。关掉旋转合并插件后,Quarl 性能只下降 3.2%,Quartz 则下降 15.4%(总门数)/9.7%(CNOT 数)——学习式调度对”非局域技巧”的依赖更低 Li 2024。
与其他概念的关系
- 与RL 线路优化一脉相承:那里用 CNN 三维网格读一维链上的随机线路,这里用 GNN 处理任意拓扑,并用 Quartz 的完整规则库与真实基准评测,是同一思路的成熟化。
- 规则库来自Quartz 超优化的自动枚举——“自动发现规则 + 学习调度规则”构成完整的自举链路;代价模型的取舍与编译器公平评测直接相关。
- 图神经网络同款思路见ZX 图的深度强化学习优化(在 ZX 图上选重写动作)与ARGON:GNN 编译框架(GNN 赋能中性原子编译);“优化即博弈”的另一种 RL 形式化见电路即博弈。
- “先升后降”的变换序列与 PyZX 图论化简、T 计数约简中的策略问题同构;学习型方法与 LLM 智能体的分工见智能体工作流。
- 面向中性原子:门数与 CNOT 数的下降直接转化为里德堡门(阻塞 CZ 门)的串行时间与误差预算的节省。
参考文献
- Z. Li, J. Peng, Y. Mei, S. Lin, Y. Wu, O. Padon, Z. Jia, “Quarl: A Learning-Based Quantum Circuit Optimizer”, Proceedings of the ACM on Programming Languages (2024). NA130 · DOI 10.1145/3649831 · arXiv:2307.10120