问题背景
量子线路优化(quantum circuit optimization, QCO)要在保持功能等价的前提下压缩线路的深度 与门数 ,从而压缩退相干误差积累。现有做法分两派:一派是手工规则与固定流程(Qiskit、TKet、Nam 优化器等),可靠但对上下文敏感的特殊情形束手无策;另一派是搜索(如 Quartz 的代价回溯搜索),完备但组合爆炸。变换规则的收益强烈依赖上下文——例如两个对易门的先后顺序要看周围线路才能定——因此”何时何地施加哪条规则”本身就是个序贯决策问题,这恰是强化学习的语言 Fösel 2021。
还有一个实际障碍:验证两线路等价一般很难,但对只涉及少量门的初等变换,用 ZX 演算类的工具可以在多项式时间内给出肯定或否定的等价判定,这使”施加一条变换”可以被廉价地约束在等价类之内 Fösel 2021。Fösel、Niu、Marquardt 与 Li 的工作是深度强化学习做线路优化的开端:他们不发明新规则,而是学习一个调度已有规则的策略,并让它在随机线路的大数据集上训练、再外推到更大的线路 Fösel 2021。
理论模型
MDP:状态是线路,动作是变换
智能体与环境(线路)交互:在每一步,智能体观察当前线路 ,施加一个变换(动作 )得到 。变换分两类:硬规则(hard rules)总是有利,如相邻两个相互抵消的门,可以在预处理中自动全部施加(即”修剪”,pruning);软规则(soft rules)是否有利取决于上下文,如交换两个对易门的顺序。智能体的决策被限制为”下一步施加哪条软规则”,硬规则自动跟随 Fösel 2021。环境是确定性的:固定变换作用于固定线路,结果唯一。
奖励:从出错概率模型导出代价函数
奖励设计的目标是让”逐点改进”与”最终线路更不易出错”一致。假设每个比特空闲时以速率 丢失信息、第 个门相对空闲衰减的劣化因子为 ,则无错执行整个线路的概率为
其中 为比特数、 为总时长。最大化 等价于最小化 。取每个门相同的执行时间 与相同的劣化 ,得到可用 表达的代价函数
实验中取 、(两比特门更贵的物理直觉通过门集合的选择体现)。智能体收到即时奖励
这比”只在结尾给一次奖励”有更好的时间分辨率、学习更高效;由于采用模型无关的 RL 算法, 本身可以换成任何用户定义的线路函数 Fösel 2021。
状态与动作的网络表示
观察:为每个可能出现的操作保留一个输入神经元,按三维网格排布——三个轴分别是比特指标、时刻(执行顺序)与门类;门类作为卷积的输入通道(连续参数门按特殊参数值分立类,如 旋转按 归类,其余归入一类,从而能表示任意连续参数)。卷积层把”比特指标 × 时刻”当空间维处理,这与人读线路图的方式同构 Fösel 2021。
动作:变换由”规则 + 受影响门的位置”共同定义,若为每个可能动作保留一个输出神经元,动作空间会随线路组合爆炸。受国际象棋走法表示启发,作者把变换与线路中的位置一一对应:单门变换用(时刻,最小比特指标)标记,双门变换用(第一门的时刻,两门共享的最小比特指标)标记——由此得到从变换到输出神经元的单射映射,策略输出 与状态价值 各自排布在同型三维网格上,并用动作掩码(action mask)屏蔽非法动作。 的语义是”该线路还剩多少优化潜力” Fösel 2021。
网络用优势演员–评论家(advantage actor-critic, AAC)训练:动作按优势 超过平均的程度被强化。门集合为 旋转、Phased-X 与 CNOT(一维链上仅近邻 CNOT),二者构成通用门集 Fösel 2021。
为什么不用 Q-learning
作者明确讨论过替代方案。其一,把所有变换排序后依次分配给一队输出神经元——但每个输出神经元的语义会随线路(乃至相距很远的局部)改变,网络几乎无法学习。其二,改用 Q-learning 的状态–状态变体 (输入线路、输出线路),绕开动作枚举;但这类变体使用较少、研究不充分,且限于 Q-learning 框架。相比之下,“变换绑定到线路位置”的演员–评论家方案让动作空间离散、状态相关、且语义稳定,是三者中唯一可行的折中 Fösel 2021。
方法与实现
训练数据不是现成基准,而是随机线路——这在当时是无奈之举(各应用线路分散、无联合数据集),事后看却保证了策略的通用性。生成流程:12 比特排在一维链上,随机组合 150 个门(类型与位置受近邻约束)得到 、;先施加全部硬规则修剪到 、;再做 500 次随机软变换把线路”撑大”到 、——随机扩展迫使智能体同时应付低效与高效线路,是泛化能力的关键训练技巧。每个 episode 从一条扩展线路出发优化到底,一次完整训练(约 1000 个 epoch)在 32 核节点上耗时 6–7 天 Fösel 2021。
学习过程分两段:前约 50 个 epoch 迅速把平均深度和门数压到 、(已明显优于修剪基线),之后缓慢稳步改进,在约 1000 epoch 处达到 、。逐回合看,智能体在前 150–200 步快速改进,随后曲线基本持平,偶有例外:一是短暂”绕道”进入更差状态后迅速返回;二是有时它真的穿过中间更差的线路继续优化——即越过奖励势垒,抵达更优线路。这一行为正是软规则价值的直接体现 Fösel 2021。
两个实现细节值得记录。由于每回合都换一条新线路,训练集与验证集表现没有差别(不存在过拟合特定线路的问题);另外作者没有给智能体”终止 episode”的能力——它只能被动跑满固定步数,这既是简化,也留出了后续工作(如 Quarl 的停止条件与策略引导搜索)的改进空间 Fösel 2021。
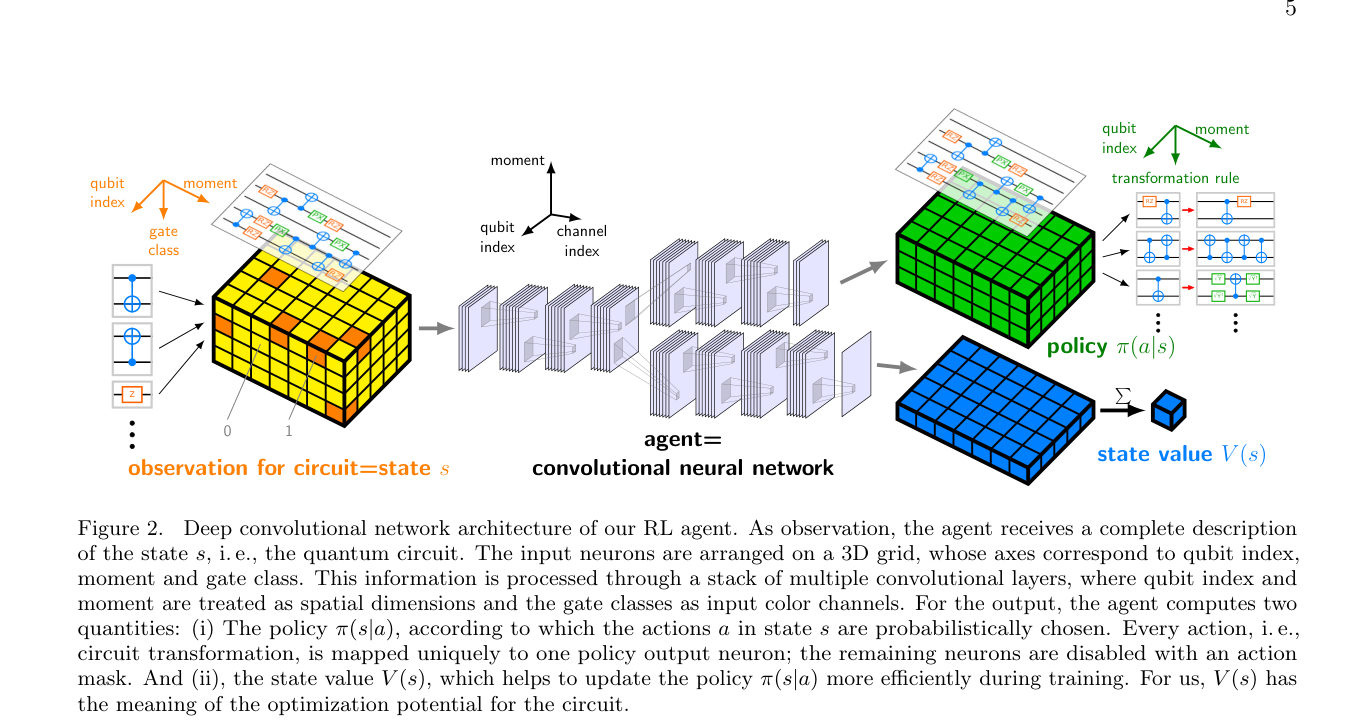
RL 线路优化的网络架构:线路编码为(比特指标 × 时刻 × 门类)三维网格,经卷积层输出策略 π(s|a) 与状态价值 V(s)(图源:Fösel 2021 Fig. 2)
实验结果与对比
| 任务 | 方法 | 深度 | 门数 | 来源 |
|---|---|---|---|---|
| 12 比特随机线路(修剪后基线) | — | Fösel 2021 | ||
| 同上,RL 智能体 | AAC + CNN | Fösel 2021 | ||
| 同上,模拟退火( 步) | Metropolis + 指数降温 | 约达修剪水平 | 约达修剪水平 | Fösel 2021 |
| 同上,模拟退火( 步) | 同上 | Fösel 2021 | ||
| 外推:50 比特、2500 门(修剪后) | — | Fösel 2021 | ||
| 同上,RL(2500 次变换内) | 同一训练好的智能体 | Fösel 2021 | ||
| QAOA MaxCut 实例 | 训练于随机线路的智能体 | Fösel 2021 |
评测协议说明代表性:随机线路上的对比在训练末期(约 1000 个 epoch)的 3200 条线路上进行,逐条与修剪后基线比较——绝大多数线路深度与门数双双下降,单条线路的改进最高超过 50%;逐回合统计中智能体对约 0.4% 的线路无能为力。与模拟退火的对比则采用同一数据集与计算预算,并对退火的 Metropolis 规则与指数降温调度做了适配 Fösel 2021。
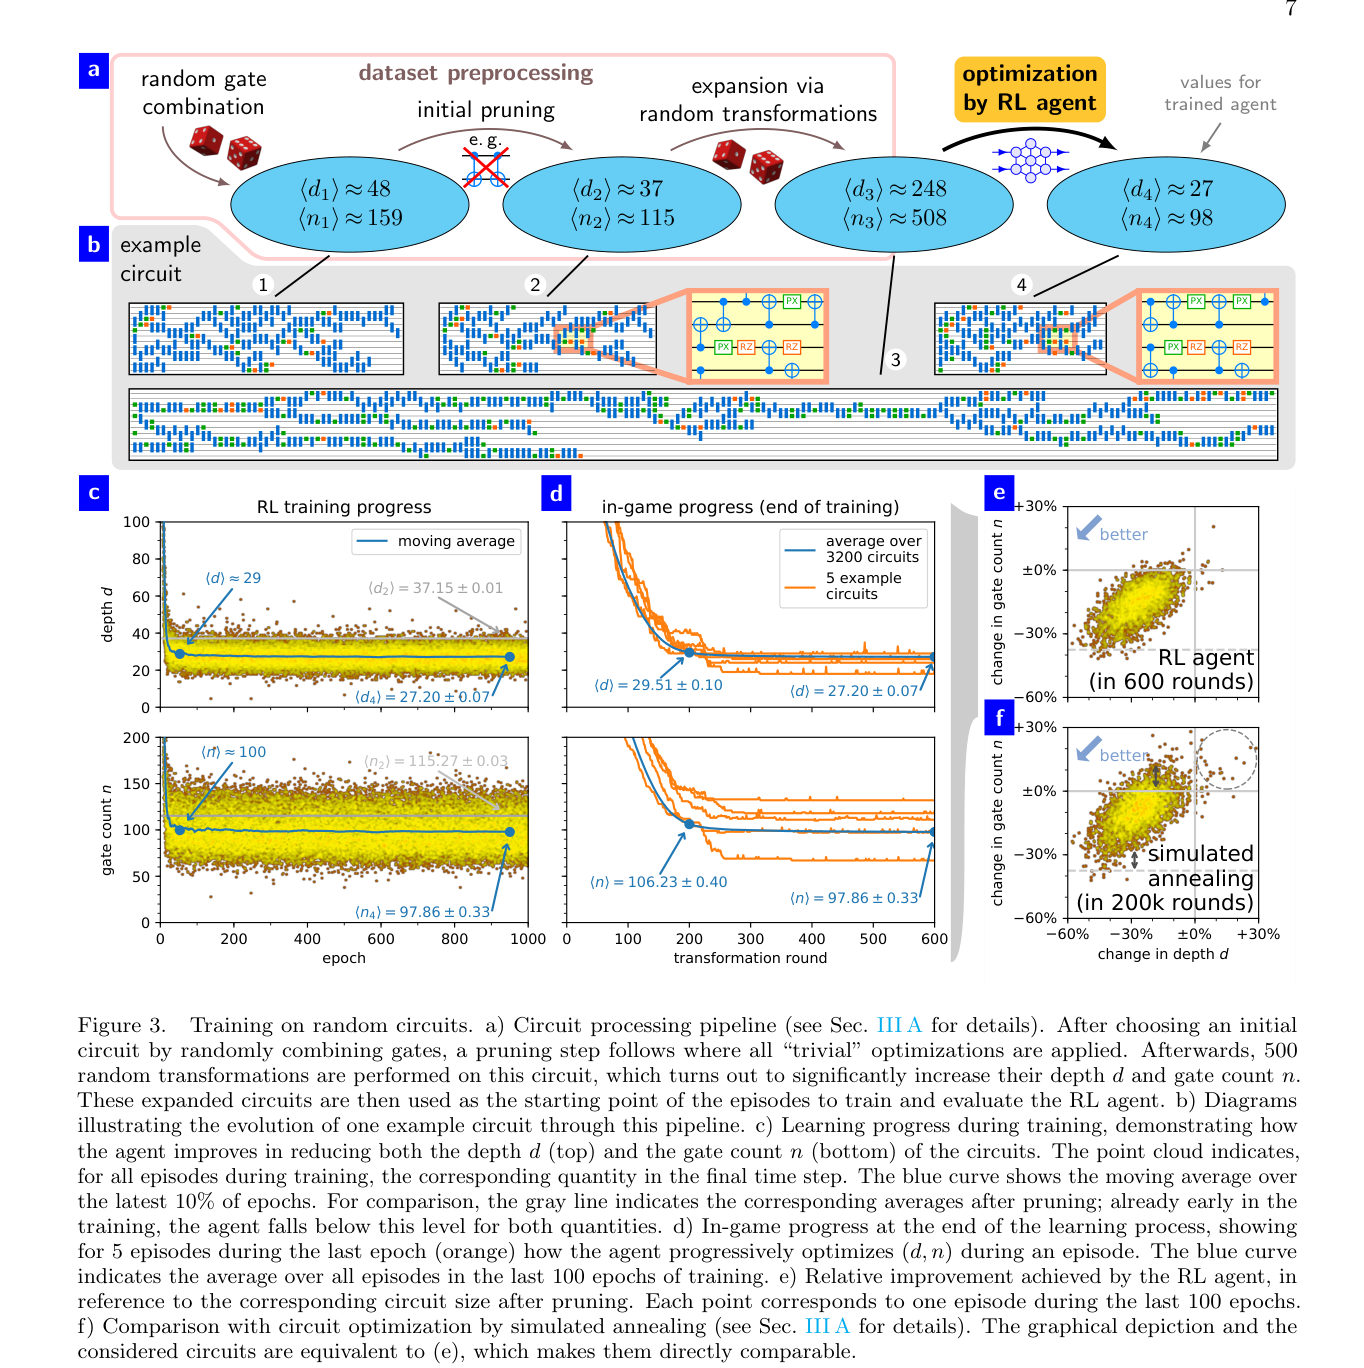
RL 训练进度与逐回合优化轨迹:平均深度/门数随 epoch 下降曲线,及单回合内 d、n 随变换步数的演化(图源:Fösel 2021 Fig. 3)
要点有四。其一,深度降低 27%、门数降低 15% 是相对修剪后基线的平均结果;RL 相对模拟退火的优势主要体现在门数上( vs )——退火 20 万步里仅约 15%–20% 的提议被接受,1 万步内平均只够回到修剪水平。其二,同一个在 12 比特线路上训练的智能体(得益于全卷积结构)可直接用于大一个数量级的 50 比特线路,压缩比例基本保持。其三,对真实应用线路(QAOA 电路)也有正收益,尽管幅值小于随机线路。其四,成功率并非百分之百:3200 条线路中仅 12 条(约 0.4%)智能体未能超过修剪后的代价——偶尔绕道时若陷入低质量吸引子,它也可能空手而归 Fösel 2021。
与其他概念的关系
- 本文是学习型线路优化的起点:后续 Quarl 把动作空间分解 + 图神经网络 + PPO 引入,在与 Quartz 同一套变换规则上全面超越本工作的设置;两者共同构成”学调度”路线。
- 变换规则本身来自 Quartz 超优化的自动枚举;“学规则”与”学调度”分工明确。等价性约束的思想与 电路等价性验证同源。
- 图形化 rewrite 的另一大分支在 ZX 演算与 PyZX 图论化简:那里动作是图重写,见ZX 图的深度强化学习优化;ZX 化简也是 T 计数约简的主力。
- 面向中性原子:门数/深度直接决定里德堡门(阻塞 CZ 门)的误差与并行度;RL 编译智能体在可重构阵列上的延伸见电路即博弈,GNN 编译框架见ARGON:GNN 编译框架。
- 评测方法论:随机线路与基准套件(通用量子基准套件)的选择会显著影响结论,公平对比见编译器公平评测与可视化。
- 从控制到编译,RL 的接口是一致的——MDP、奖励、策略网络;脉冲层的应用回到量子最优控制框架与强化学习量子控制,两层的联合优化(波形 + 线路)目前仍是开放问题。
参考文献
- T. Fösel, M. Y. Niu, F. Marquardt, L. Li, “Quantum circuit optimization with deep reinforcement learning” (2021). NA127 · arXiv:2103.07585