问题背景
梯度类最优控制(量子最优控制框架中的 GRAPE 与 Krotov/GOAT)收敛性好,但有两个先天依赖:一是完整的系统模型与梯度(或自动微分),二是把每个时间片当作自由变量的参数化方式。前者带来模型偏差(model bias)——在仿真里优化出的脉冲搬到实验上性能显著退化;后者让实验闭环代价高昂。当系统存在无序、缺陷或未标定的相互作用时,“构造可靠的有效模型”本身就不可行,这正是 RL 的用武之地:智能体对底层哈密顿量一无所知,只从单次试验得到的标量奖励(如末态保真度)中学习 Bukov 2018。
量子控制中的 RL 有三座里程碑:Bukov 等在 2018 年用 Q-learning 扫描了单比特与多体态制备问题的整个”控制相图”,划定了 RL 的用武之地 Bukov 2018;Zhang 等在 2019 年做了迄今最系统的横向对比,回答”RL 何时胜过 SGD/Krotov” Zhang 2019;Sivak 等在 2022 年针对量子环境的随机性与最小可观性设计了”模型自由 + 奖励电路”框架,把 RL 推到真实超导量子比特可实现的形态 Sivak 2022。此前的量子态感知方案依赖层析获取量子态,学习一个仅 16 参数的单比特门就需要约 次测量 Sivak 2022。
理论模型:把控制问题写成 MDP
状态、动作与奖励
一个 RL 问题形式化为马尔可夫决策过程 :智能体在状态 依策略 选动作 ,环境按转移核 演化并给出奖励 。Bukov 等对自旋 在横向场中的态制备问题 给出了教科书式的选择 Bukov 2018:
其中 、协议为分段常数(bang-bang);奖励只在 episode 末端给出
关键设计是:状态里不含任何量子态信息——智能体只看”当前时刻 + 当前场强”,因此算法是严格模型自由的;把时间 显式放入状态,是为了让智能体估计自己离终点还有多远。值得强调的是,这个选择也使”学习部分”的计算量不随系统尺寸 增长(每步只记录 和一个标量奖励),瓶颈只在动作-状态空间的组合规模与薛定谔演化的模拟代价上 Bukov 2018。
Q-learning 与控制相图
Q-learning 直接逼近最优动作值函数 (从 出发先做 、之后按最优策略行动的期望总回报),它满足 Bellman 最优方程,用时间差分迭代求解:
学习率 。Bukov 等用带资格迹的 Watkins 延伸 Q-learning 配线性函数逼近,跑 个 episode,以序参量 (与 Edwards–Anderson 序参量相关的协议自重叠)刻画出三个控制相 Bukov 2018:
- I 过约束相():时间不够,最好保真度也低(图示点 ),不保真度景观是凸的,优化容易;
- II 玻璃相():最优协议呈”回声型”多脉冲结构(图示点 ),不保真度景观出现大量亚稳态——对最优协议做单次”翻转”得到的 28 个低保真激发态被约 个态包围(过约束相仅 ),错过基态后几乎不可能到达全局最优,优化呈指数困难;
- III 可控相():存在无穷多单位保真度协议(图示点 ),多起点局部优化即可。
对 的非可积自旋链,玻璃相还呈现多吸引子结构:吸引子内协议平均形状相同但彼此重叠很小,需要高度非局域的移动才能互相转换——这解释了为何做全局更新的 GRAPE 在该相表现同样好,而单比特结论不能简单外推 Bukov 2018。补充材料显示 Q-learning 与多个主流最优控制算法表现相当;其价值在于”顺便”给出了控制问题的统计力学描述,并指出 (见量子速度极限)时探索本身就是替代多起点局部优化的范式。
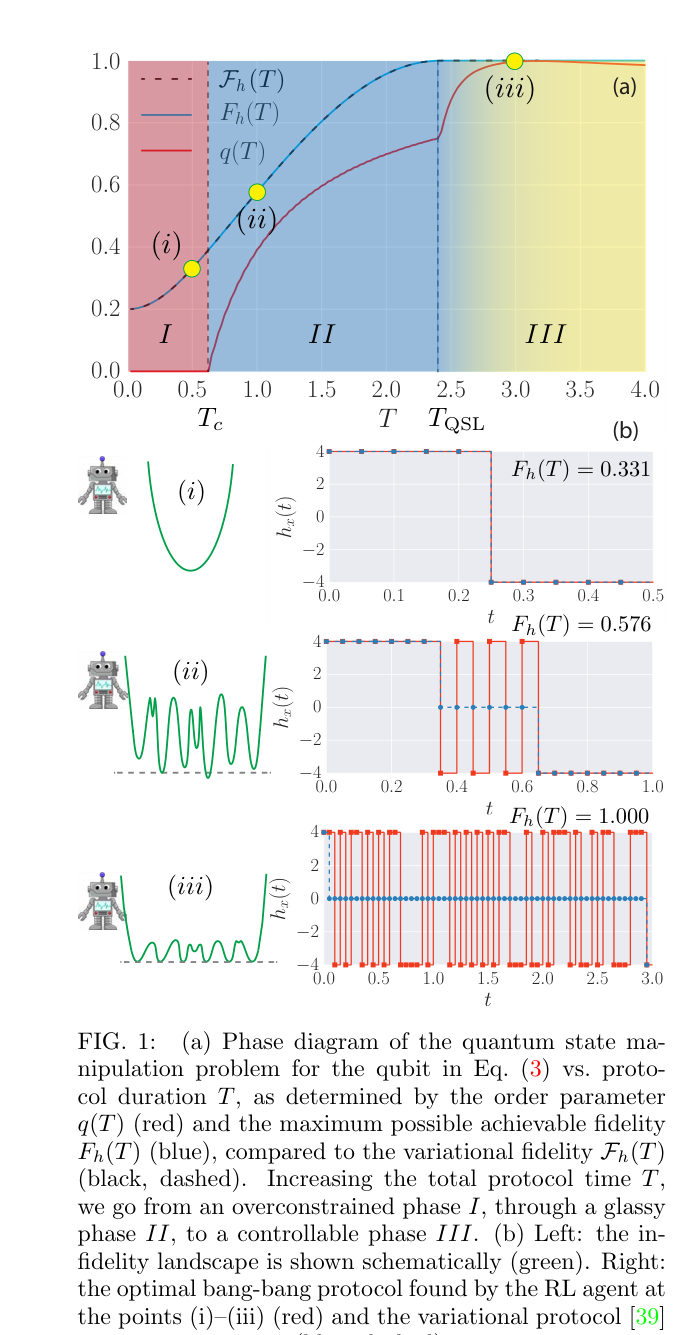
单比特态制备的控制相图:q(T) 与最大可达保真度随协议时长 T 的变化,标出过约束相 I、玻璃相 II、可控相 III 与 T_c、T_QSL(图源:Bukov 2018 Fig. 1)
方法与实现
对比研究:RL 何时胜出
Zhang 等在单比特态制备与多体自旋链态转移上横向对比了五种算法:查表 Q-learning(TQL)、深度 Q-learning(DQL)、策略梯度(PG)与经典的随机梯度下降(SGD)、Krotov Zhang 2019。结论可以概括为四条(其 Table I):
- 动作离散受限时 RL 占优:把控制场限制为 个离散值(如 即 ),DQL 与 PG 一致最好;离散化( 小)对 Krotov 与 SGD 是灾难,而 RL “天然喜欢有界的具体动作集”。
- 规模放大时 RL 占优: 个时间片后 DQL 的平均保真度虽被 Krotov 反超,但仍高达 。
- 自适应分段是 RL 的独特能力:RL 会在优化中自动发现”前 保持控制为零即可”这类最短方案,而 SGD/Krotov 固定搜索恰好 片的序列,常常错过最优解、产生复杂得多的脉冲。
- 连续控制集( 大)时 Krotov 占优:其大步长梯度更新依赖问题的连续性。
多比特演示为一维 自旋链的自旋转移(,, 片),RL 的局域场限制为 : 时平均保真度 DQL 、PG 、Krotov 仅 ,查表 Q-learning 因 Q 表维度爆炸在 即失效 Zhang 2019。
模型自由控制:奖励电路
Sivak 等把”量子环境的两个本质困难”——态空间大而只能通过投影测量获得随机二值结果——正面写进问题定义,提出量子可观马尔可夫决策过程(quantum-observable MDP, QOMDP):智能体逐步输出参数化控制电路的参数向量,观测只有辅助比特 测量的 ,奖励在 episode 末尾由一个专门设计的奖励电路(reward circuit)以单次测量的形式给出 Sivak 2022。设计原则是让奖励的期望单调依赖于保真度:取目标投影 POVM ,,则
这一 POVM 使目标态与其他态的可区分性最大。对 Fock 态制备,奖励电路就是色散读出 + 选择性 脉冲的组合,规则为 (第二次辅助比特测量的结果取负)。训练采用 PPO(近端策略优化):网络为一层 LSTM 加两层全连接,高斯策略输出动作向量;为抑制 奖励的采样噪声,PPO 在信任域内做小步更新,用”多评几个候选策略”代替”把单个策略评准” Sivak 2022。
控制对象是腔–比特系统中的谐振子,控制电路选为通用门集的模块化序列 :截断到 能级、深度 步,全程共 85 个实参数;总采样预算 个 episode( 个 epoch、每批 )。同样的预算下,直接拿保真度的 Nelder–Mead 随光子数增长迅速退化;把样本按最优方式分配给迭代与平均(每次 2000 次平均)也无法赶上 RL Sivak 2022。框架还演示了两件更”智能”的事:当 SNAP 门因脉冲过短而实现不完美(,远离理想区)时,仿真优化的开环策略因模型偏差严重退化,而智能体学出的自适应测量反馈策略仍能高保真制备 Fock 态 ;附录中进一步把逻辑门推广到振子编码的 GKP 逻辑比特 Sivak 2022。
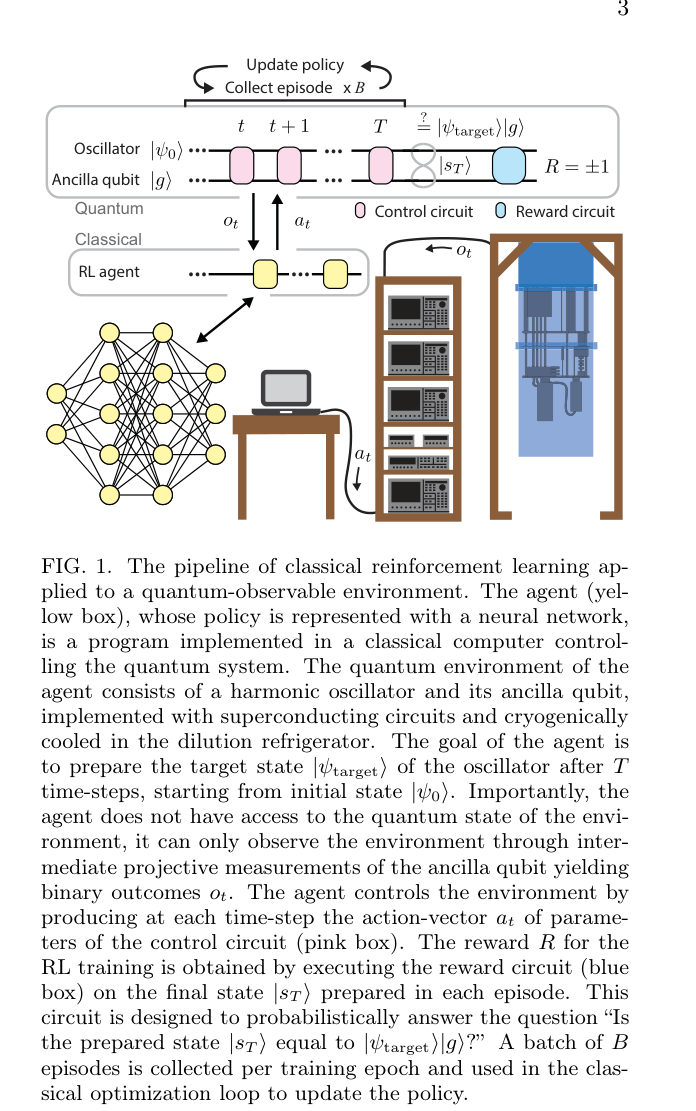
模型自由 RL 的训练回路:RL agent → 控制电路作用于量子系统 → 奖励电路单次测量 → 标量奖励回馈(图源:Sivak 2022 Fig. 1)
里德堡门的增量更新 DRL
面向中性原子里德堡门(见阻塞 CZ 门),增量更新深度强化学习(IU-DRL)把动作向量取为控制/靶原子里德堡激光的幅度与相位 ,但不直接输出绝对值,而是在上一拍的值上做限幅增量更新。这一步看似技术性,实则决定成败:传统更新方式在四维连续动作空间里探索,2.5 万个 epoch 后门保真度只有约 且脉冲剧烈振荡;同样的预算下 IU-DRL 达到 (门长 , 热运动下仍有 ),并自发找到”提前关断”策略——训练中期先学会关掉控制原子的 旋转激光,后期再精确校准关断时刻,把门长压到 。传统方式即使训练 10 万 epoch 也发现不了这一时刻,保真度上限约 Cai 2026。增量更新与CRAB的”把物理先验写进参数化”一脉相承,详见Rydberg 门增量 RL 最优控制。
实验结果与对比
| 任务与对比 | 方法 | 关键数字 | 来源 |
|---|---|---|---|
| 单比特控制相图 | Q-learning(bang-bang, episodes) | ,;三相机图 | Bukov 2018 |
| 玻璃相景观 | ”1-翻转”激发分析 | 28 个激发被 态包围(过约束相 ) | Bukov 2018 |
| 自旋链态转移 | DQL / PG / Krotov | / / | Zhang 2019 |
| 长序列()态制备 | DQL vs Krotov | (Krotov 平均更高) | Zhang 2019 |
| 腔–比特 Fock 态 – | PPO+LSTM, episodes | 从 (低 )到 (高 ) | Sivak 2022 |
| 同预算模型自由对比 | RL vs Nelder–Mead(2000 次平均/迭代) | NM 随 快速退化,RL 明显占优 | Sivak 2022 |
| 里德堡 CNOT 门 | IU-DRL vs 传统更新 DRL | vs (同 2.5 万 epoch); | Cai 2026 |
与其他概念的关系
- 在量子最优控制框架的版图里,RL 与CRAB/DCRAB同属”无梯度”路线:CRAB 用少参数截断把问题降维,RL 用学习到的策略替代盲目搜索;与GRAPE、Krotov/GOAT的梯度保证互为互补——Zhang 等的对比表明连续、无界控制问题仍是梯度法的天下。
- 玻璃相的出现条件 把 RL 的困难性与量子速度极限直接联系起来;多吸引子结构与鲁棒最优控制关心的”解的稳定性对采样噪声”问题相互呼应。
- 奖励电路用测量代替保真度估计,使 RL 可以直接以实验数据闭环,与门标定闭环的目标一致;模型偏差的来源与定量分解见误差预算与真实建模。
- 中性原子侧的延伸:里德堡门的少参数 RL 波形设计见Rydberg 门增量 RL 最优控制;门本身见阻塞 CZ 门与多比特阻塞门。
- RL 之外,学习型方法在编译层的应用见RL 线路优化与智能体工作流。
参考文献
- M. Bukov, A. G. R. Day, D. Sels, P. Weinberg, A. Polkovnikov, P. Mehta, “Reinforcement Learning in Different Phases of Quantum Control”, Phys. Rev. X 8, 031086 (2018). NA124 · DOI 10.1103/PhysRevX.8.031086
- X.-M. Zhang, Z. Wei, R. Asad, X.-C. Yang, X. Wang, “When does reinforcement learning stand out in quantum control? A comparative study on state preparation”, npj Quantum Information (2019). NA125 · DOI 10.1038/s41534-019-0201-8 · arXiv:1902.02157
- V. V. Sivak, A. Eickbusch, H. Liu, B. Royer, I. Tsioutsios, M. H. Devoret, “Model-Free Quantum Control with Reinforcement Learning”, Phys. Rev. X 12, 011059 (2022). NA128 · DOI 10.1103/PhysRevX.12.011059 · arXiv:2104.14539
- Y. Cai, H. Zhang, K. Zhang, J. Qian, “Intelligent Optimal Control of Rydberg Gates with Incremental-Update Deep Reinforcement Learning” (2026). NA135 · arXiv:2605.04628