问题背景
EIT 型里德堡 CNOT 门(EIT 里德堡门)因可扩展性备受青睐:控制原子处于 时,靶原子跟随 EIT 暗态 原样不动(STAY);控制原子处于 时被泵到里德堡态,强范德瓦尔斯相互作用 把靶原子的里德堡态移出共振、破坏 EIT 条件,靶原子在 Raman 脉冲()下完成翻转(TRANSFER)。但分段绝热设计有一个结构性天花板:TRANSFER 期间控制原子必须全程”停靠”在损耗性的里德堡态 上等待靶原子演化,仅里德堡衰减一项就积累 的误差,把保真度挡在 0.999 之外——对每段脉冲做再精细的优化也无济于事,只要”顺序结构”不变,控制原子的里德堡暴露就是决定性误差源 Cai 2026。
出路是同步方案:控制与靶原子的幅度 、相位 四路参数一起调制,放弃暗态绝热约束,从全哈密顿量出发统一编排脉冲。作为对照,分段协议用恒定 Rabi 频率的 离共振驱动 ,再依次施加 三段定位脉冲,相位通常固定为零——顺序结构正是误差的根源。但同步化把控制问题推入高维非凸景观:传统 DRL(“传统更新”,TU)把每个时间片的原始参数 当独立动作,一方面因相邻时间步动作可任意跳变而生成强振荡波形——受任意波形发生器与声光调制器的有限带宽限制,实验上难以实现;另一方面四维乘积空间 的探索负担使优化易陷次优区域——这正是强化学习量子控制中”探索噪声 vs 收敛速度”矛盾的典型体现 Cai 2026。
理论模型:增量更新 DRL
动作空间:在旧波形附近做微调
IU-DRL 把动作向量定义为相对上一时刻的增量
实际物理参数经累加积分恢复:,相位 同理。再引入平滑系数 约束单步更新幅度——、——动作内在维度仍是 4,但每一步可达的控制景观体积被大幅压缩。优先”局部、连续”的探索取代”全局、跳跃”的探索,从机制上抑制振荡波形并加速收敛:生成的脉冲天然光滑、实验可实现,且优化不易停滞在病态次优区 Cai 2026。
状态与奖励:对称性降维 + 稠密物理反馈
智能体的观测若暴力展开(四个计算初态的 密度矩阵)达 1024 维,训练开销难以承受。利用大失谐下 能量劈裂可忽略的交换对称性,门的全局性能只需跟踪两个初态——(STAY)与 (TRANSFER);再取密度矩阵对角元(非对角相干信息贡献有限),观测向量压缩到 24 维:
奖励设计须克服”延迟奖励”难题:真正的性能指标 (STAY 与 TRANSFER 两通道的平均门保真度)只在整段序列结束的 时刻可见,稀疏的终端反馈使信用分配困难。IU-DRL 构造兼顾稀疏终端引导与稠密物理反馈的奖励
第一项仅在 生效,对数标度保证逼近单位保真度时梯度陡峭( 对应奖励 3.0);第二项是逐步泄漏惩罚, 是四个计算初态平均的中间态/里德堡态布居时间积分,正则化系数 、 平衡终端保真度与瞬态衰减。正是稠密惩罚项诱导出 early-cutoff 策略:一旦靶态达成,继续驱动只会累积 ,智能体于是学会在 尽早把激光场置零(),把系统”冻结”在峰值保真度上——一种隐式的时间最优控制,与量子速度极限思想呼应 Cai 2026。
智能体采用 actor–critic 架构与 TRPO 算法(KL 散度约束保证策略单调改进,在非凸高维景观中保持稳定):演员与评论家均为三个全连接隐层(156/48/16 单元,双曲正切激活),从 24 维观测映射到 4 维高斯动作分布的均值;评论家的价值基线降低演员随机策略的梯度方差。总时长 离散为 步——分辨率兼顾波形光滑与计算效率。目标保真度 按 STAY/TRANSFER 两通道平均:初态 只涉及靶原子的主方程, 则需求解完整双原子主方程 Cai 2026。
方法与实现
系统为两个 原子的四能级模型:比特态编码于基态超精细能级 ,里德堡态 ,经 420 nm 与 1013 nm 双光子激发;原子间距 ,范德瓦尔斯相互作用 (里德堡阻塞深阻塞区)。EIT 全局激光 、失谐 ;同步方案的脉冲上限取 ( 取满幅以压缩控制原子的等效 旋转时间);衰减率 、。系统演化由 Lindblad 主方程描述,训练 25,000–100,000 epochs Cai 2026。
鲁棒性作后验检验:训练中不包含原子热运动,学得的脉冲被放进 、阱频 的真实模型里考问——多普勒频移 (速度服从 的高斯分布)与位置涨落导致的作用强度抖动 (,)一并纳入,其建模科目即误差预算与真实建模的标准清单 Cai 2026。
训练配置可归纳为四点:
- 环境步进由 Lindblad 主方程驱动,奖励中的 对四个计算初态取平均,保证两通道同步优化;
- 平滑系数 是唯一需要手工调节的”探索音量”旋钮,0.1 为灵活性–稳定性最佳平衡;
- 高斯策略的随机采样机制允许智能体偏离当前控制轨迹去”试探”替代路径,这对发现非绝热捷径至关重要;
- 该框架不依赖任何脉冲对称性或解析形状的先验知识;原文指出其可直接扩展到真实实验装置,以闭环数据继续学习(与门标定闭环衔接)。
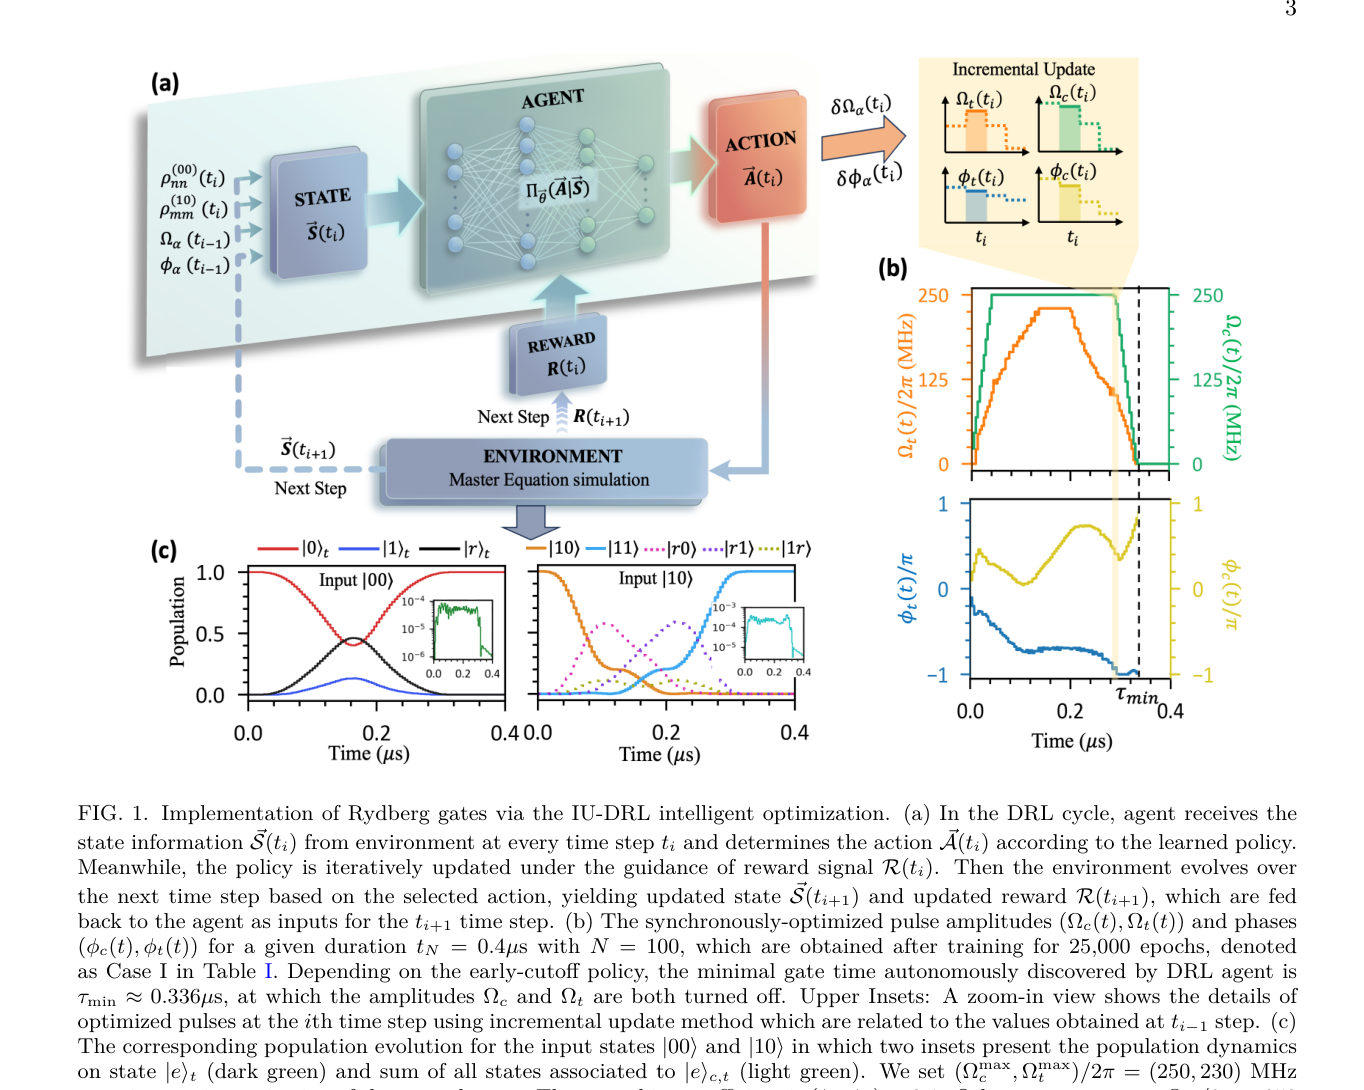
IU-DRL 循环与优化波形:动作增量→脉冲幅度/相位→提前关断时刻 τmin(图源:Cai 2026 Fig. 1)
实验结果与对比
最优协议(Case I,,25,000 epochs)达到平均保真度 、门时长 ;里德堡衰减误差 从分段设计的 压到 ,相对优化后的非绝热分段基准(总时长 、)提速约 38.9%。作为参照,附录中用同一 IU-DRL 框架优化的绝热分段方案需要 ——同步化本身就把门时间缩短了一个数量级。学习动力学呈现清晰的三阶段:25,000 epochs 时策略已铺满全程但出现关断倾向;50,000 epochs 先学会关断较简单的 (等效 旋转);75,000 epochs 两路 Rabi 频率都收敛到 early-cutoff 模式。学得的 近乎矩形(对”开关型”控制原子,压时长胜过复杂调制), 与两路相位则呈现精巧调制,以同时兼顾 STAY/TRANSFER 两通道与态依赖阻塞 Cai 2026。
平滑系数是探索体积的旋钮: 时若只训 25,000 epochs(Case II),过大的探索噪声使保真度仅 0.99194、 停在 0.400 ;延长到 75,000 epochs(Case IV)波形收敛光滑,保真度 0.99907、门时长进一步缩到 。与传统更新的对照(Table I)最能说明增量参数化的价值:
| 方法(Table I) | epochs | ||||
|---|---|---|---|---|---|
| IU,(Case I) | 25,000 | 0.336 | 2.72 | 0.99910 | 0.99884 |
| IU,(Case III) | 50,000 | 0.376 | 4.42 | 0.99685 | 0.99715 |
| IU,(Case IV) | 75,000 | 0.308 | 2.99 | 0.99907 | 0.99883 |
| TU(Case V) | 25,000 | 0.400 | 116.13 | 0.62720 | 0.63024 |
| TU(Case VII) | 75,000 | 0.400 | 8.08 | 0.96241 | 0.96163 |
| TU(Case VIII) | 100,000 | 0.400 | 6.76 | 0.99701 | 0.99693 |
TU 方法即使训练到 100,000 epochs 也始终无法发现提前关断( 恒等于分配时长 ),且以高随机性收敛到两类次优解:其一定期关断 、模仿分段 EIT(被顺序演化的保真度天花板锁死);其二让 全程近满幅、形似同步方案却缺了精调的 early-cutoff——多余里德堡暴露直接吃掉保真度与时长。热运动鲁棒性:IU-DRL 协议的多普勒误差仅从 ()增至 (),而传统分段绝热方案在 下接近 、彻底失去 0.999 能力;相互作用涨落误差在 下保持在 量级(深阻塞区门保真度对 精确值不敏感), 综合保真度仍达 0.9988——短门时长的 early-cutoff 正是压制多普勒累积相位误差的关键 Cai 2026。
与固定视界优化方法的对照:GRAPE 等传统 QOC方法虽可把总时长纳入优化,但通常工作在固定视界框架内——控制段被视为独立变量、整个分配时长总被用满,于是承受可避免的保真度损失;IU-DRL 把控制形式化为序贯决策,动作与演化中的系统状态直接耦合,策略在到达靶态后自然停止驱动。鲁棒性方面,残余的多普勒误差还可用更短双光子波长的激光组合、三光子激发或态映射方案进一步压制;作者展望的方向包括把噪声感知学习纳入训练(对特定实验漂移的主动鲁棒性)与硬件特定约束(有限带宽、调制器非线性)的直接编码,使这类理论协议更顺利地落到真实中性原子架构上 Cai 2026。
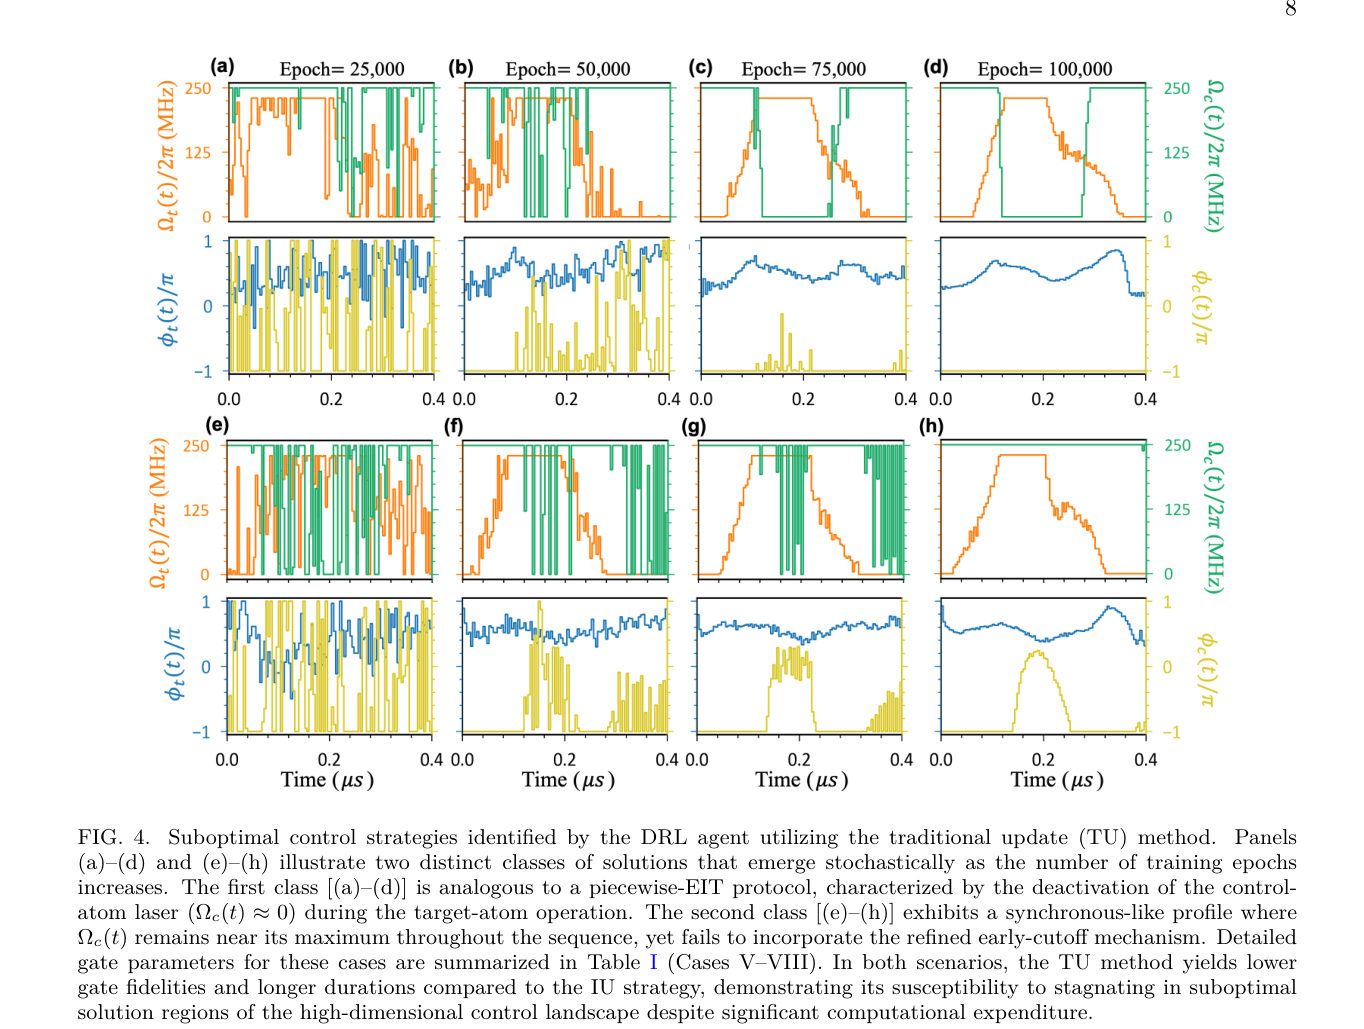
TU-DRL 的两类次优波形与 IU-DRL 的对比:分段式与伪同步式(图源:Cai 2026 Fig. 4)
与其他概念的关系
- IU 策略是强化学习量子控制中”模型自由 + 探索正则化”路线的门级实例;与量子最优控制框架中GRAPE的逐片自由变量相比,IU 用增量参数化把相邻时间片耦合起来,与Krotov/GOAT的单调收敛保证分属不同谱系。
- 优化对象是EIT 里德堡门与阻塞 CZ 门的同步化改写;early-cutoff 是智能体自发逼近量子速度极限的隐式时间最优行为。
- 平滑系数约束与解析整形脉冲、ORMD/ARMD的带宽限制思想一致,只是约束由数据驱动搜索自动满足;与CRAB/DCRAB的少参数 ansatz 相反,IU-DRL 保留全自由度但约束探索路径。
- 鲁棒性后验检验的噪声清单(多普勒/位置涨落/自发辐射)即误差预算与真实建模的标准科目;若追求对参数漂移的显式免疫,应结合鲁棒最优控制的 ensemble 目标做噪声感知训练(原文展望亦如此建议)。
- 编译层的姊妹工作见 电路即博弈:一个优化门波形、一个优化原子布局,共同构成中性原子的”学习型设计栈”。
参考文献
- Y. Cai, H. Zhang, K. Zhang, J. Qian, “Intelligent Optimal Control of Rydberg Gates with Incremental-Update Deep Reinforcement Learning”, arXiv:2605.04628 (2026). NA135 · arXiv:2605.04628
- M. Bukov, A. G. R. Day, D. Sels, P. Weinberg, A. Polkovnikov, P. Mehta, “Reinforcement Learning in Different Phases of Quantum Control”, Phys. Rev. X 8, 031086 (2018). NA124 · DOI 10.1103/PhysRevX.8.031086
- Z. T. Wang, Q. Chen, Y. Du, et al., “Quantum compiling with reinforcement learning on a superconducting processor”, Mach. Learn.: Sci. Technol. (2026). NA137