问题背景
场可编程量子阵列用空间光调制器(SLM)产生静态镊子网格、用声光偏转器(AOD)产生可移动镊子,编译器必须在两层相互纠缠的约束下调度电路:其一是静态空间约束——并行里德堡门要满足最大相互作用半径 ,且彼此的禁区(restriction radius ,通常 )不得重叠,否则产生串扰,重叠即”结构冒险”,调度器被迫把门串行化;其二是动态运动学约束——共享 AOD 行/列的原子必须同步移动,行/列在移动中不得交叉,违者强制把搬运分解为多个执行周期。当前层空间最优的布局往往让后续层的 AOD 轨迹拥堵甚至无解,两个维度由此深度耦合 Sun 2026。
现有编译器把两个维度放在一起同时求解,形成”可扩展性墙”。在 MQT Bench 随机门电路基准上的实测(正是编译器公平评测关心的场景):联合优化型求解器 Enola 在仅 比特时编译时间就指数上升到 秒(约 3 小时)超时线;启发式的 DasAtom 靠剪枝保住编译速度,但物理执行保真度在 比特时跌至 ,计算已不可用;转而插入 SWAP 序列解决路由冲突的方法则重新引入深度、易感退相干 Sun 2026。ARGON 用两条洞见解开这个死结:(1) 几何干涉规则是硬件固有的、与算法无关,可整体离线化;(2) 贪心地最大化瞬时门并行度往往加剧全局搬运开销,路由决策需要”拓扑前瞻”。
方法框架:时空解耦的三级流水线
离线布局库:空间约束归约为最大独立集
由于 、 是固定的物理参数,合法空间布局集合与具体电路完全无关。ARGON 在离线(非重复性工程,NRE)阶段用 SMT 求解器预计算一组”硬件认证、最大并行度”的布局:把 网格上所有物理可执行的门对定义为 ,再为禁区重叠的门对连边构成冲突图,布局生成即最大独立集型优化
其中 表示门 是否激活。求解器在不同网格尺寸与目标门密度间迭代扫描,抽取最大子集 ;布局再经正交旋转与镜像扩充,以近乎零成本倍增拓扑多样性。最大化同时激活的门数有两个红利:在数学上为里德堡激发级数 (Geyser 原生多比特门编译中的同款指标)设定下界,从源头压低错误积累;同时把组合搜索彻底逐出编译期 Sun 2026。
GNN 引导的预测式布局
给定电路当前层与候选布局,编译器先用轻量距离最小化启发式把逻辑门映射到物理槽位,再为每个活跃比特抽取 4 维运动学描述子 作为节点特征,并把前瞻窗口 层内的未来门依赖编码为带离散时滞属性 的图边。节点表示用三层扩展 Graph Isomorphism Network(GIN)聚合:
其中 为可学习标量(保持表示单射性)、 为建模空间跃迁的边嵌入。选择 GNN 而非搜索启发式或序列模型有两条理由:GNN 天然同时编码原子阵列的物理几何与演化的逻辑拓扑(不变硬件交互图 + 时序电路依赖图的合适归纳偏置);评估深路由拓扑本属高开销任务,神经范式把它整体吸收进离线数据集构建,使布局评估退化为常数时间前向推断。读出层采用全局求和池化
之所以选 sum-pooling 而非平均,是因为路由代价(累计原子渡越距离、局部轨迹延迟)在处理器上具有可加性。监督信号来自离线的重型时空 rollout:模拟器实例化物理状态、计算即时转移代价 (惩罚最大 AOD 渡越距离与违规移动),并在 层窗口上执行确定性启发式 rollout,目标累计代价为折扣和
衰减远处预测的不确定性。网络以 MSE 损失在数据集 上离线训练;经验剖析显示前瞻窗口 是延迟–精度的最佳折中 Sun 2026。
启发式并行路由
末级后端把选中的布局序列翻译成无碰撞 AOD 搬运序列:把原子移动建模为有向运动学图,沿正交轴合成互不相交的轨迹;遇环状目标依赖时,把环内一个原子临时”停靠”到中间位置,将循环依赖化为无环移动(仅引入少量额外移动成本),并为闲置原子生成安全避让路径以不干扰活跃 AOD 扫掠;随后把无环运动按图着色问题分组成并行执行切片——节点为轨迹、边表示轨迹相交,同色(不冲突)轨迹归入同一 AOD 执行周期 Sun 2026。
方法与实现
评测采用 阵列,原子间距 、、;端到端物理保真度按统一全局里德堡脉冲约束建模(隔离单比特误差以突出时空路由开销),形如
四项分别为门/闲置惩罚与转移惩罚、退相干极限,参数取 、、、、、、、加速度 ,按当前主流装置校准 Sun 2026。工程开销:布局库含 104 个模板()、128 个()、152 个(),单次生成耗时 3.5 s()、12.1 s()、21.7 s();一次性 NRE(数据集生成 + GNN 训练)约 3.5 小时;运行期内存至多 1.5 GB RAM + 0.5 GB 显存,普通工作站即可部署。基线为 DasAtom(空间优先启发式范式)、PowerMove(配置为 no-storage 模式以对齐单体阵列假设)与 Enola(较高保真度的 dynamic 模式),全部在同一台 AMD 7900X + RTX 4070 Ti SUPER 工作站上评测。值得强调的是:rollout 训练集只含随机门与 W-state 电路,QV、3-Regular 与 QASMBench 全部留作留出(held-out)评估 Sun 2026。
实验结果与对比
ARGON 平均编译时间 0.68 秒、所有任务均在 10 秒内完成;对稠密电路(Random gates、QV)平均加速超过 600 倍、最高超过 倍:DasAtom 与 Enola 频繁撞上 秒超时线,PowerMove 虽免于超时但在大规模 Random/QV 电路上也逼近 2000 秒 Sun 2026。
| 基准套件(平均编译时间,秒) | ARGON | DasAtom | PowerMove | Enola |
|---|---|---|---|---|
| W-state | 0.04 | 36.9 | 58.4 | 295.4 |
| Random gates | 1.1 | >3939.7 | 989.9 | >7156.4 |
| Quantum Volume | 2.2 | >5397.1 | 1338.3 | >8342.5 |
| 3-Regular | 0.02 | >3003.7 | 32.7 | 43.4 |
| QASMBench | 0.05 | 0.05 | 96.3 | >942.3 |
| 总平均 | 0.68 | >2475.5 | 503.1 | >3356.0 |
保真度侧:50 比特 W-state 上 ARGON 相对基线约有两个数量级的保真度提升;25 比特随机门电路相对 PowerMove 提升 8 个数量级以上、相对 Enola/DasAtom 提升 10 个数量级以上;QASMBench 全套平均物理保真度 ARGON 0.575,优于 PowerMove 0.559、DasAtom 0.562 与 Enola 0.568。保真度分解显示分工:搬运保真度以 DasAtom 最好(子电路合并减少搬运级数)、闲置激发保真度以 ARGON 与 Enola 最好(前者靠 SMT 布局最大化门并行度)、转移保真度 DasAtom 占优(转移次数少)、双比特门保真度各方法相同(只取决于门数) Sun 2026。
消融与泛化:把 GNN 预测换成”同一布局库 + 随机选择”,Random gates 上保真度最多跌一个数量级——布局库只是潜力,神经策略才兑现它;在 上训练的模型零样本迁移到 、 阵列,且电路越大领先越多(物理排除限制只定义局部邻域,学习到的模板组合逻辑具有尺度不变性,无需重训或扩库)。效率归因:库查询 + 图预处理 + GNN 推断合计低于 0.5 秒(50 比特稠密电路),总编译时间随里德堡级数线性增长(>300 级仍 <3 秒),确认后端可扩展性。与分区架构启发式(Stade 等,A* 式放置)对比:QASMBench 上 ARGON 0.063 s、对方 0.065 s、DasAtom 0.079 s,其中 ARGON 在 seca_n11、multiply_n13 上给出更少的全局里德堡级数 Sun 2026。
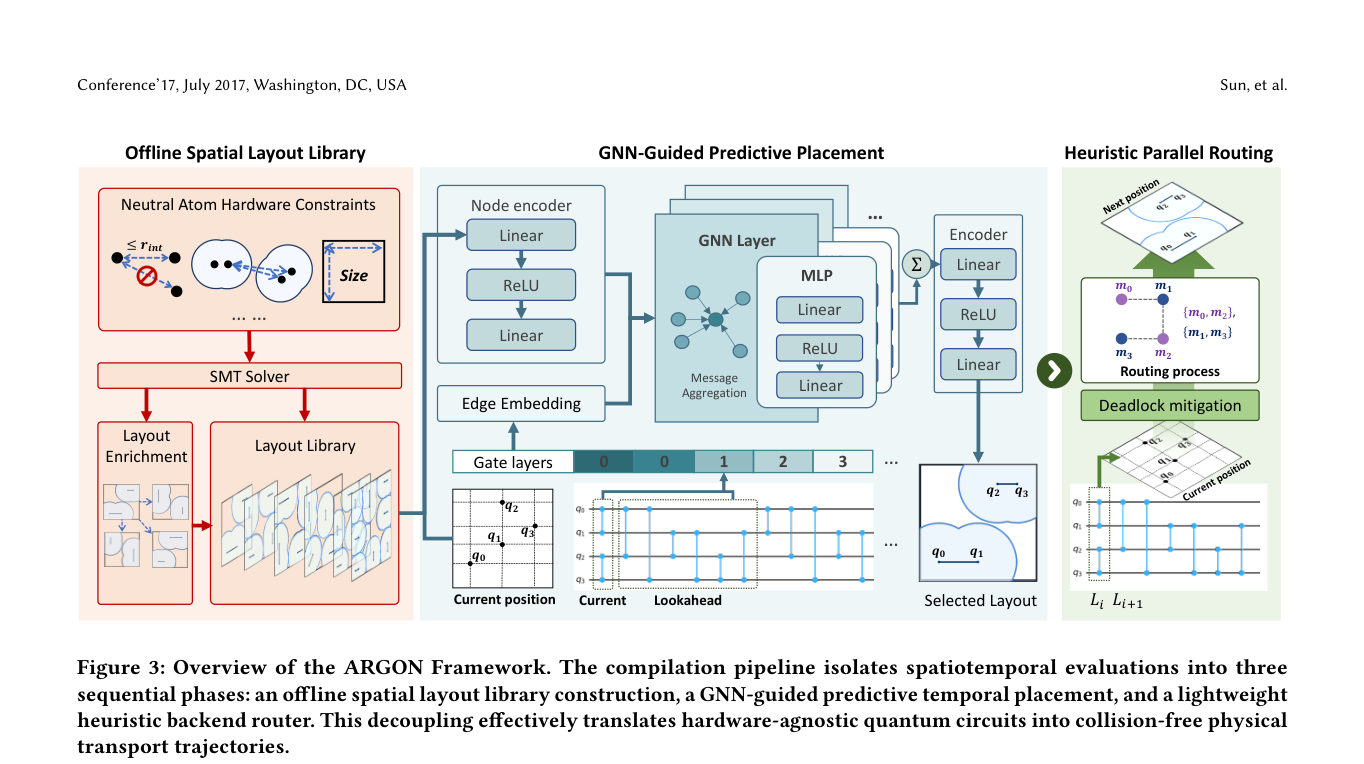
ARGON 三级流水线总览:离线布局库→GNN 预测布局→启发式路由(图源:Sun 2026 Fig. 3)
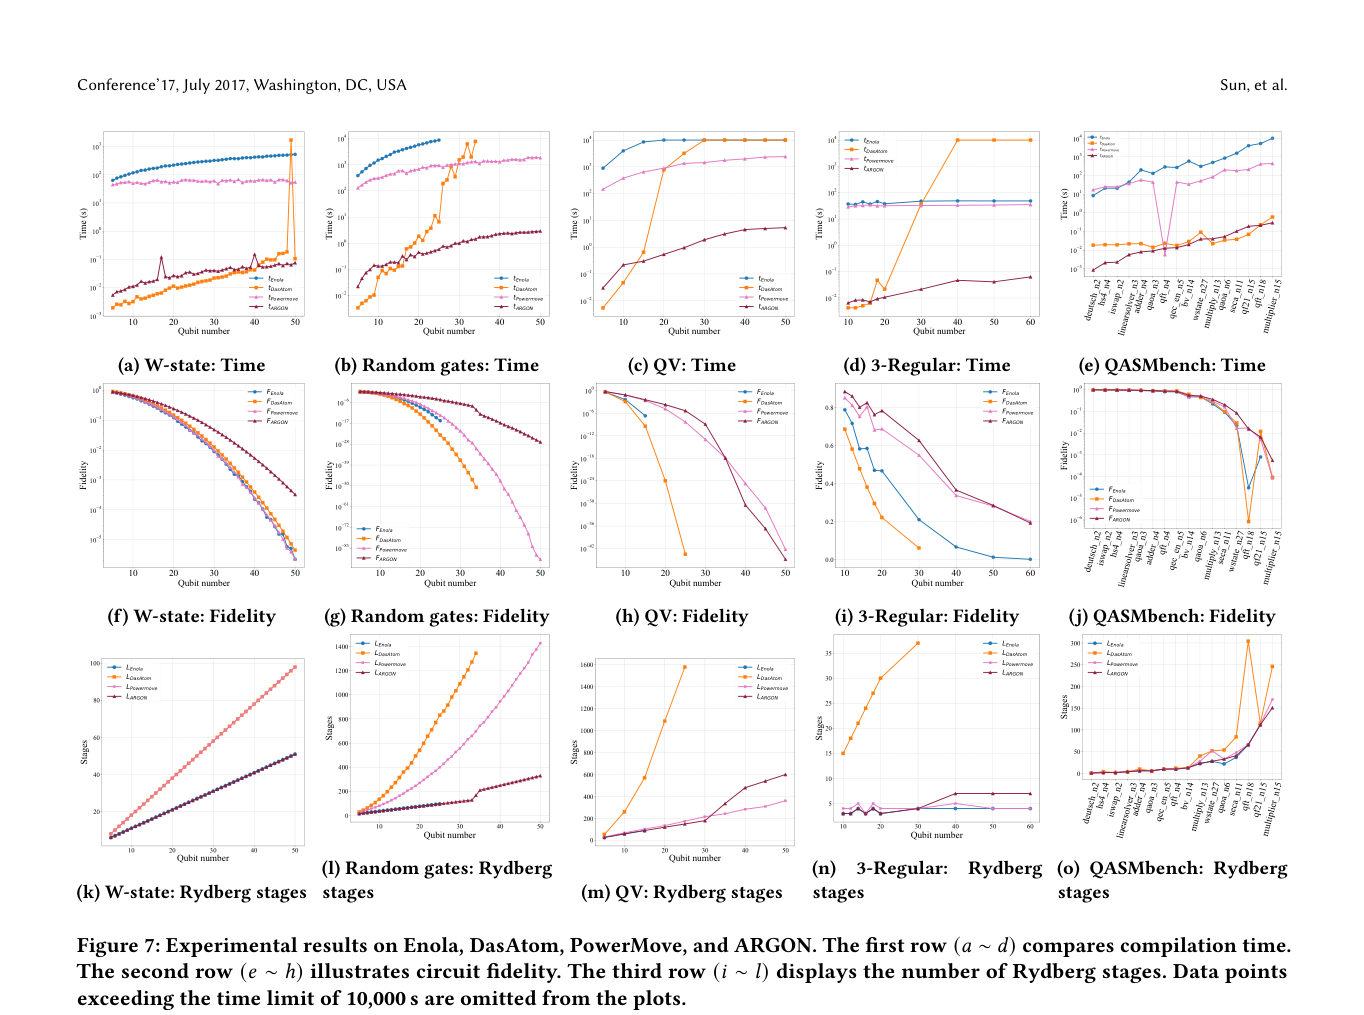
四个编译器在五套基准上的编译时间/保真度/里德堡级数对比(图源:Sun 2026 Fig. 7)
与其他概念的关系
- 时空解耦的”空间”半边建立在 FPQA 计算模型的硬件原语之上:AOD 行列同步与禁区约束正是该模型形式化的物理限制。
- 与 DasAtom(分治+穿梭)、PowerMove(分区架构优化编译)、Atomique(动态阵列区域划分)、Arctic(FPQA 调度)同台竞技:ARGON 的差异化在于把空间验证离线化、用 GNN 承担时间维预测。
- 离线布局库的”最大并行度”目标直接压低里德堡激发级数,与并行纠缠门及阻塞 CZ 门的执行效率正相关。
- 学习型编译谱系:ZX 图的深度强化学习优化与Quarl优化电路本身,ARGON 则优化”电路在原子阵列上的物理实现”,与电路即博弈的 RL 布局规划路线互为补充。
- 布局选择的未来依赖前瞻与布局映射与长程交互中的阻塞免 SWAP 路由同源;公平对比方法论见编译器公平评测与可视化,基准电路来自通用量子基准套件(MQT Bench、QASMBench)。
- 预计算布局模板因尺度不变性可充当未来分区架构纠缠区的调度原语——单体阵列之外的存储管理与区间流量调度仍需ZAP式系统栈配合。
参考文献
- W. Sun, X. Li, Z. Wang, L. Yu, G. Chen, G. Yang, “ARGON: A GNN-Empowered Compilation Framework for Scalable Neutral Atom Computing”, arXiv:2607.21216 (2026). NA134 · arXiv:2607.21216
- Y. Huang, D. Gao, S. Ying, S. Li, “DasAtom: A Divide-and-Shuttle Atom Approach to Quantum Circuit Transformation”, IEEE Trans. Comput.-Aided Des. Integr. Circuits Syst. (2025). NA029
- J. Ruan, X. Fang, H. Zhang, A. Li, T. Humble, Y. Ding, “PowerMove: Optimizing Compilation for Neutral Atom Quantum Computers with Zoned Architecture”, Proc. 30th ACM ASPLOS (2025). NA031
- E. Khusainov, Y. Chen, J. Winklmann, H. Seidl, C. B. Mendl, “Practical Insights into Fair Comparison and Evaluation Framework for Neutral-Atom Compilers”, arXiv (2026). NA186