ZAP 的主旨是”先设计架构、再让编译器别犹豫”:纠缠区里预排好间距小于里德堡半径的 SLM 陷阱对,使搬运退化为存储区与陷阱对之间的短程往返;编译器则放弃迭代全局搜索,用 ASAP-separate 调度、前瞻式初始映射与冲突感知路由组成单遍确定性流水线——同一套硬件参数下,编译时间比 ZAC/PowerMove 快两到三个数量级、比 Enola 快四到六个数量级,执行质量持平或更优。
问题背景
中性原子平台的扩展同时卡在硬件与编译两头:双比特门靠全局里德堡光束,闲置比特会被串扰;原子搬运带来退相干与加热;而把逻辑线路映射到动态重构阵列本身是 NP 难的组合问题。此前的编译器普遍依赖迭代搜索:ZAC 用模拟退火做初始映射与比特复用 Lin 2025;Enola(见OLSQ-DPQA:可重构阵列的 Qubit 映射)面向非分区架构、以图着色调度为核心;PowerMove 分区架构编译虽是多阶段启发式联动,仍需多轮协同优化 Huang 2026。结果是编译时间从几分钟爆炸到几小时,编译器本身成了系统瓶颈——迭代式编译无法支撑交互式的算法开发循环。
ZAP 的回答分两层。架构层:与编译器协同设计一个二分区处理器——存储区(闲置比特 + 单比特门)在上/下,纠缠区在另一侧;纠缠区的 SLM 陷阱排成陷阱对,对内间距小于里德堡阻塞半径(保证成对可纠缠),对间间距大于阻塞半径(防止串扰);两区之间保持 隔离。编译层:确定性单遍流水线,没有任何迭代细化,每个决策一次做出、永不回溯 Huang 2026。
形式化模型
保真度与成本模型
ZAP 的保真度模型显式把串扰记为独立因子 Huang 2026:
其中 为单比特/CZ 门数, 刻画纠缠区内非目标原子被全局光束误激发的串扰事件(每次 ), 为串扰次数, 为 SLM↔AOD 换阱次数, 为比特空闲时长,。
执行语义:阶段 ≠ 同时
模型中的”阶段”是逻辑调度块而非物理同时执行的保证:同一阶段内硬件不兼容的操作(全局里德堡脉冲与无法并行的单比特转动)仍按时间排序;只有作用在不同区域、互不冲突的操作才真正并行。单比特阶段通常直接在存储区内完成,双比特阶段才把选中的比特运入纠缠区——这条语义划清了”逻辑深度”与”物理时长”的界限,是 ASAP-separate”阶段数变多、搬运变少”仍然合算的前提。与PowerMove 分区架构编译的模型相比,这里假设受控搬运本身近乎无损(实验上平滑输运的内在误差可忽略),其代价只通过时长进入退相干项——于是位移 的搬运时长用加速度受限模型
为加速度上限;多段子移动的时间开销逐段累加。编译器的三个可操作目标由此确定:最小化串扰事件 (布局与调度)、最小化换阱次数 (搬运规划)、缩短总执行时间(压低所有 )。门保真度项 由硬件决定,编译器无能为力——优化火力全部集中在后三个编译相关因子上。
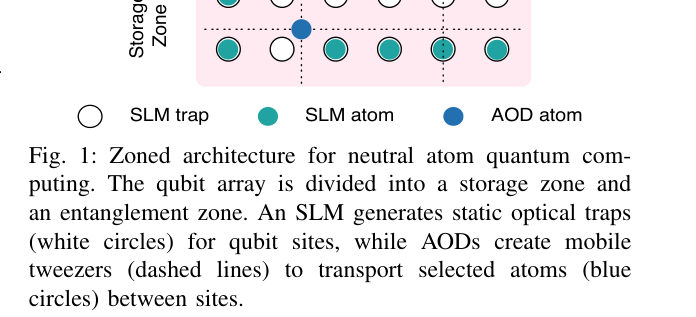
ZAP 二分区架构:存储区 SLM 晶格 + 纠缠区陷阱对(对内间距 < 阻塞半径、对间 > 阻塞半径)与 AOD 短程往返(图源:Huang 2026 Fig. 1)
方法与实现
ZAP 流水线三步,每步都为下游步骤”留好接口” Huang 2026:
1. ASAP-separate 调度。线路先转译为单比特门与 CZ,按 DAG 做 ASAP 调度。关键在变体的选择:ASAP-joint 把单/双比特门塞进同一逻辑阶段,逻辑深度最小,但相邻阶段依赖紧耦合、比特频繁往返;ASAP-separate 先排所有双比特门、再用单比特门填补空隙,阶段数可能变多,却把搬运需求大幅压缩——同一示例线路中,joint 在阶段 0–1、1–2、3–4 之间都要搬原子,separate 只在 0–1 与 4–5 之间搬。ZAP 采用后者,并明确”阶段”只是调度块:硬件不兼容的操作在同一阶段内仍按时间排序执行。
2. 前瞻式映射与布局。初始映射一次性完成:存储位点按到纠缠区的平均距离排序,量子比特按重要性权重 排序(越早参与双比特门越重要),依次安放;若比特的首次双比特门落在前瞻窗口内,就为它预估一个”首次搬运向量”,并对候选位点的向量与已规划向量的 AOD 不兼容数 计罚——评分 同时奖励离纠缠区近与未来搬运可并行。逐阶段布局则处理两件事:其一,闲置比特管理——不同于以往编译器把闲置比特一律送回存储区,ZAP 逐比特逐阶段比较留在纠缠区的串扰损失 与送回存储区的换阱损失 (,若该比特永不再用则计 4)加退相干损失 ,仅当 才送回;其二,主动门布局——优先复用已部分占用的有效陷阱对,否则确定性选择使 最小的空闲陷阱对并定向。
3. 冲突感知路由。路由把每个阶段的目标布局翻译为物理指令序列:为安全移动集合构建兼容图,贪心取极大独立集作为下一批并行搬运。对起点同行、终点异行的”本质冲突”,ZAP 引入停靠(parking)步——先做一次短位移把冲突解开,再并行主移动,把”必须串行”化为”并行前的一次微调”。
三步的信息流是单向的:调度形态决定布局的评分函数,布局增量提交的移动向量又约束路由的兼容图——正是这种”决策即承诺”的确定性结构,让整个编译无需任何搜索。
实验结果与对比
评测覆盖三类工作负载:14 个结构化算法基准(2–35 比特:adder、qaoa、qft、sat、bv、multiplier、qnn、vqc、qram、knn、ising、wstate、ghz、cat)、10–100 比特随机 3 正则线路,以及放大到 500 比特的 Ising/Cat/Adder/QFT;基线为 ZAC Lin 2025、PowerMove 分区架构编译 Ruan 2025与 Enola Tan 2025(单比特门项各编译器相同,从指标中剔除)Huang 2026。
| 指标 | 结果 | 对照 |
|---|---|---|
| 保真度(qft_n10) | ZAP vs PowerMove | 编译相关误差分解见原文 Fig. 9 |
| 串扰抑制 | 多数基准上近乎完全压制 | Enola 串扰损失最大 |
| 执行时间 | 与 ZAC/PowerMove 相当,常为最快 | 硬件原语相同,差距温和 |
| 编译时间(结构化) | 多数基准 | ZAC/PowerMove 数十秒:加速 |
| 编译时间(vs Enola) | 加速 | 摘要口径:超过 |
| 随机线路编译 | 100 比特仍 | ZAC/PowerMove 进入数十秒 |
| 规模极限 | 500 比特 QFT 编译 | ZAC/PowerMove 迭代在数百比特即不可行 |
三条主结论 Huang 2026:其一,ZAP 的保真度优势来自更好的调度/布局/路由决策而非更乐观的硬件模型——分解显示它在多数基准上几乎消除串扰、同时控制换阱与退相干,优势在连接不规则、比特复用不均匀的结构化负载(QRAM、KNN、QFT 类)上最显著;在 GHZ、Cat 这类移动模式简单的态制备线路上各编译器差距很小。其二,随机 3 正则线路上各编译器面对相同的稀疏交互密度(每比特 个 CZ),编译相关损失被平均化,ZAP 与 PowerMove 差距收窄但仍保持编译速度优势。其三,执行时间的比较被限制在共享同一存储–纠缠执行模型的 ZAC/PowerMove/ZAP 之间(Enola 面向非分区架构,物理时长不可同口径比较):三者受相同硬件原语支配,ZAP 靠减少不必要的往返与调度开销常居最快。
分解视角还给出一个前瞻判断:编译相关误差(串扰、换阱)被 ZAP 压低之后,退相干成为随规模增长的主导残余——它的改善只能来自真空度、磁场稳定性与激光噪声抑制等硬件进步;换言之,编译器优化越成功,硬件参数在保真度账本中的权重越大。这也是”编译速度”被 ZAP 摆到第一性位置的原因之一:当执行质量趋同时,能把编译从数十秒压到 0.1 s 以下、支撑交互式迭代工作流的那一版编译流程就是实际意义上的最优。
参数与量级
| 量 | 典型值 | 来源 |
|---|---|---|
| 单比特门 | , | Huang 2026 |
| 双比特门 | , | Huang 2026 |
| 串扰因子 | (每次 ) | Huang 2026 |
| SLM↔AOD 换阱 | , | Huang 2026 |
| 搬运加速度上限 | (近似无损) | Huang 2026 |
| 相干时间 | Huang 2026 | |
| 两区间隔 | Huang 2026 | |
| 编译时间 | 多数基准 ;对 ZAC/PowerMove 加速 ,对 Enola | Huang 2026 |
| 最大演示规模 | 500 比特 QFT,编译 | Huang 2026 |
与其他概念的关系
- ZAP 与分区架构是典型的协同设计样本:陷阱对纠缠区是专为”短程搬运 + 全局光束并行门”设计的硬件形态,反过来让编译器可以完全确定化。
- 与PowerMove 分区架构编译构成”质量 vs 速度”的两极:PowerMove 用多轮联动优化换数个数量级保真度,ZAP 用单遍确定性换三个数量级编译速度且质量不降。
- ASAP-separate 调度削减搬运的机制是FPQA 计算模型与能力边界中”全局门 + 整队移动”原生指令集的直接推论;串扰项的物理基础见并行纠缠门与里德堡阻塞。
- 迭代式对照组 ZAC 的复用感知思路与 Enola 的图着色调度见OLSQ-DPQA:可重构阵列的 Qubit 映射;同为单遍思路的分区编译还有Arctic:FPQA 调度。
- 陷阱对几何与长程交互的利用呼应布局映射与长程交互利用;AOD 短程往返的物理约束(行列保序、加速度上限)由原子搬运与相干输运的实验数据支撑。
- 编译速度被当作第一性指标的评测方法学与可视化见编译器公平评测与可视化。
参考文献
- C. Huang, X. Zhao, H. Xu, W. Zhuang, M. Hu, D. E. Liu, J. Wang, “ZAP: Zoned Architecture and Performant Compiler for Field-Programmable Atom Array”, IEEE Trans. Quantum Eng. (2026). NA046 · arXiv:2411.14037 · DOI 10.1109/TQE.2026.3696707
- W.-H. Lin, D. B. Tan, J. Cong, “Reuse-Aware Compilation for Zoned Quantum Architectures Based on Neutral Atoms”, HPCA (2025)(ZAC 基线). NA033
- J. Ruan, X. Fang, H. Zhang, A. Li, T. Humble, Y. Ding, “PowerMove: Optimizing Compilation for Neutral Atom Quantum Computers with Zoned Architecture”, ASPLOS (2025). NA031
- D. B. Tan, W.-H. Lin, J. Cong, “Compilation for Dynamically Field-Programmable Qubit Arrays with Efficient and Provably Near-Optimal Scheduling”, ASPDAC (2025)(Enola 基线). NA028
- D. Bluvstein et al., “A quantum processor based on coherent transport of entangled atom arrays”, Nature (2022)(分区硬件蓝本). NA143