问题背景
FPQA 计算模型与能力边界确认了 FPQA 的两条独特能力:阻塞半径内任意原子对可纠缠、原子可被 AOD 相干搬运。但彼时的 FPQA 编译(如 OLSQ-DPQA:可重构阵列的 Qubit 映射的求解器路线)只把数据比特本身搬来搬去——每一次路由都是数据的物理迁移,搬运与纠缠深度互相纠缠。Q-Pilot 注意到一个被忽视的自由度:既然实验已演示高保真搬运(错误可忽略)与 的并行 CNOT,那么完全可以让数据不动、让辅助原子飞:可动原子在整个执行期间只扮演”临时总线”,态被复制上来、传输过去、再回收下来,自身从不承载真正的量子数据 Wang 2024。
这一”飞行 ancilla”(flying ancilla)范式与相邻平台的对照很能说明其适配性:离子阱的多链合并/分裂中”动普通比特与动辅助比特代价相同”,飞行方案无优势;超导的飞行量子比特接口保真度只有约 ;而 FPQA 的搬运近乎无损——正是飞行 ancilla 的唯一主场 Wang 2024。
理论模型
飞行 ancilla 的 CZ 路由定理
给定任意 比特态 与 CZ 对集合 ,直接执行得到 。Q-Pilot 证明如下三步等价 Wang 2024:
- 复制:对 个新鲜 ancilla 施加横向 CNOT,( ancilla 位串与数据位串相同);
- 长程 CZ:在复制品上执行 ——由于 中第 位与第 位相同,相位因子 与直接在数据上执行完全一致;
- 回收:再施加一遍横向 CNOT,——ancilla 精确归零,可立刻复用。
关键收益在深度:SWAP 路由每个 SWAP 需 3 个 CNOT(深度 +3),飞行 ancilla 整个”复制–执行–回收”只加深 +2;且第 2 步的全部 CZ 可在单个并行层内完成,因为参与交互的是各自独立搬运的 ancilla,数据比特之间从不互相靠近。此结果与耦合图无关、对任意 CZ 集合成立(对 ZZ 泡利串同样适用),但依赖目标门是 CZ 族——其他门须先分解。
误差模型
编译误差按 Tan 2022 的口径估计:
为占用的最大比特数(含 AOD 与 SLM), 为深度, 为单比特门数, 为第 阶段的最大搬运距离, 为单步搬运特征时间,,。估计表明:只要双比特门错误率低于 ,三类基准的总误差率都低于 0.5 Wang 2024。
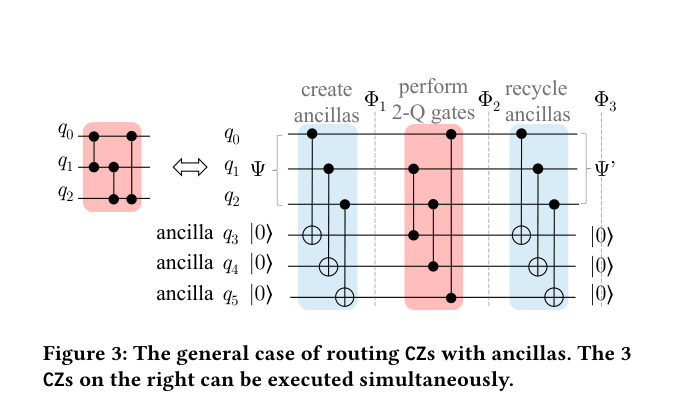
飞行 ancilla 三步路由:横向 CNOT 复制 → AOD ancilla 长程并行 CZ → 横向 CNOT 回收归零(图源:Wang 2024 Fig. 3)
方法与实现
Q-Pilot 框架由”映射器 + 高并行路由器”组成 Wang 2024:
映射器。数据比特按阅读顺序一一映射到 SLM 固定原子;AOD 网格由备用 SLM 原子经 @transfer 填充而成——因为 ancilla 在传输期间不含量子信息,原子丢失并不致命,随时可补新原子重建 AOD 拓扑。
通用高并行路由器(任意线路)。迭代处理依赖 DAG 的源层:先执行层内全部可并行单比特门(Raman 寻址),再从 CZ 候选中贪心选最大合法子集。合法性判据只有一条:AOD 行/列的次序不可逆——把候选门按首个比特下标排序后逐个尝试加入,一旦某门的两个端点在行/列维度的次序约束冲突即被踢出。对选中的子集执行三阶段物理操作:(1)AOD ancilla 移到控制比特旁、横向 CNOT 复制;(2)ancilla 移到目标比特旁,一个里德堡脉冲并行打完全部 CZ;(3)CNOT 回收、ancilla 归零。相邻迭代之间可自由重建 AOD 网格。
量子模拟定制路由器。演化一个 Pauli 串时,以串内一个”根”比特为原点,把根比特的态经一棵 CNOT 树扇出到多个 ancilla,再让 ancilla 各自飞向其余 Pauli 比特——一次复制支撑整串的 ZZ 相位门。调度把 Pauli 串的比特间兼容关系建成有向图(仅当存在路径才兼容),贪心抽取最长路径逐段并行。
QAOA 定制路由器。改为每比特一个 ancilla:利用 MaxCut 线路中大量边共享端点的特点,先为第一行选最小下标的边,再迭代加入同行兼容的边组成”抵消对”,使 ancilla 的移动距离与冲突最小;整张图处理完后统一回收 ancilla。
性能评估器与架构探索。快速代价函数返回单比特门数、双比特门数、深度与搬运距离,于是编译器可在环评估(router-in-the-loop):反复调整阵列构型、择优输出——这使 Q-Pilot 同时成为 FPQA 架构设计空间的探索工具。
实验结果与对比
基线为三种”固定连接”设备 Wang 2024:127 比特重六边形的 IBM Washington 超导机、16×16 方格与 16×16 三角点阵的固定中性原子阵列(FAA,随 OLSQ-DPQA:可重构阵列的 Qubit 映射设定),Qiskit 优化等级 3 转译;深度定义为并行双比特门层数。基准为 5–100 比特的随机线路、量子模拟(100 条随机 Pauli 串,Pauli 占据概率 0.1–0.5)与 MaxCut QAOA(随机图与 3/4 正则图)。
| 基准(100 比特) | 深度缩减 vs 最强基线 | 双比特门数缩减 | 备注 |
|---|---|---|---|
| 随机线路 | 平均 | 门数 2–50 倍比特数 | |
| 量子模拟() | 平均 | 摘要口径 27.7×;分子 Pauli 串上深度平均 、门数 | |
| QAOA(边概率 0.3) | (摘要 ) | 平均 | 4 正则图同样领先 |
| 摘要汇总 | / / | — | 随机 / 模拟 / QAOA |
分子模拟 Pauli 串上的具体数字同样可观:H₂、LiH(UCCSD)、H₂O、BeH₂ 四个基准上,Q-Pilot 的编译深度分别为 61、849、7,585、10,617,而三角点阵 FAA 基线为 73、2,616、35,353、51,699,超导基线为 77、3,403、40,080、59,259——规模越大差距越大 Wang 2024。
三条深化结论 Wang 2024:对比求解器,3/4 正则图 QAOA 上 Q-Pilot 编译全部实例用时低于 1 秒,编译深度不超过最优深度的 ;而 OLSQ-DPQA:可重构阵列的 Qubit 映射式 SMT 求解器在 50/100 比特上超时(4,000 s 上限;20 比特即需 74.5 s),其松弛迭代版(iter-p,Enola 前身,见OLSQ-DPQA:可重构阵列的 Qubit 映射)100 比特亦超时。对比通用路由器,定制路由器在量子模拟上再降深度 、门数 ,在 QAOA 上再降深度 、门数 ——领域知识直接兑换并行度。架构在环探索给出阵列宽度的量化取舍:QAOA 偏好宽阵列(最优 128 列),随机线路与量子模拟在 32–64 列最优——更宽的阵列并行路径更多,却不必然更高效。20/50/100 比特 QAOA 的平均并行度分别为 3.32、4.13、4.90,随规模上升。
参数与量级
| 量 | 典型值 | 来源 |
|---|---|---|
| 横向 CNOT 保真度 | (并行执行) | Wang 2024 |
| ancilla 搬运误差 | 近似为 0 | Wang 2024 |
| 单比特门保真度 | Wang 2024 | |
| 相干时间 | Wang 2024 | |
| 单步搬运特征时间 | Wang 2024 | |
| 飞行 ancilla 深度开销 | (SWAP 为 ) | Wang 2024 |
| 100 比特深度缩减 | 随机 ;模拟 ;QAOA | Wang 2024 |
| 对比求解器 | 全部实例 ;深度 最优 | Wang 2024 |
| 定制路由器增益 | 模拟深度再降 ;QAOA 再降 | Wang 2024 |
与其他概念的关系
- 飞行 ancilla 是原子搬运与相干输运的范式级应用:它把”移动”从数据迁移变成态总线,依赖的正是彼处展开的相干输运与并行 CNOT 实验。
- CZ 路由定理的”复制–相位–回收”结构与多比特阻塞门的扇出思想相通:横向 CNOT 扇出把一串门折叠进单个并行层。
- 与Atomique 动态阵列编译共享”SLM 固定 + AOD 可动”的硬件图景,但分工相反:Atomique 搬数据比特凑门,Q-Pilot 固定数据、搬辅助比特。
- SMT 求解器基线与 iter-p(Enola 前身)的调度框架见OLSQ-DPQA:可重构阵列的 Qubit 映射;后续分区架构路线见分区架构、PowerMove 分区架构编译与ZAP 架构与编译器。
- 在环架构探索与算法相关布局选择目标一致(Qompose 也在搜布局),只是搜索变量从静态拓扑换成了阵列宽度等 FPQA 构型。
- 长程 CZ 的阻塞物理与并行执行的串扰约束承接里德堡阻塞与并行纠缠门;QAOA/量子模拟基准的谱系见通用量子基准套件与里德堡模拟优化与 MIS。
参考文献
- H. Wang, D. B. Tan, P. Liu, Y. Liu, et al., “Q-Pilot: Field Programmable Qubit Array Compilation with Flying Ancillas”, DAC (2024). NA026 · arXiv:2311.16190 · DOI 10.1145/3649329.3658470
- B. Tan, D. Bluvstein, M. D. Lukin, J. Cong, “Qubit Mapping for Reconfigurable Atom Arrays”, ICCAD (2022)(求解器基线与误差模型来源). NA014
- D. B. Tan, W.-H. Lin, J. Cong, “Compilation for Dynamically Field-Programmable Qubit Arrays with Efficient and Provably Near-Optimal Scheduling”, ASPDAC (2025)(iter-p 基线). NA028
- S. J. Evered et al., “High-fidelity parallel entangling gates on a neutral atom quantum computer”(搬运误差可忽略与 99.5% CNOT 的实验依据,题录经 NA026 参考文献核实). NA078
- D. Bluvstein et al., “A quantum processor based on coherent transport of entangled atom arrays”, Nature 604 (2022)(相干搬运硬件依据). NA143