问题背景
分区架构确立后,编译器的任务被分解为四件事:把线路切成可并行执行的阶段(stage)、给每个量子比特分配原子位点、规划位点到目标的搬运、以及管理计算区与存储区之间的往来。PowerMove 之前的编译器把这四件事串行地当作独立子问题依次求解:先求初始布局,再做搬运,最后套上分区。当时综合表现最好的是 Enola(见OLSQ-DPQA:可重构阵列的 Qubit 映射,其双比特门保真度比 Atomique 动态阵列编译高 779 倍、比 Q-Pilot 飞行 ancilla 编译高 5806 倍)Ruan 2025。
但 Enola 有两个结构性缺陷。其一,子优化的搬运方案:为避免原子聚簇导致非预期交互,Enola 在每次里德堡激发之间都要把所有原子撤回初始布局再重新出发——直接从一个阶段的布局过渡到下一个阶段的布局会产生聚簇(例如 、 门执行后,下一阶段的 、 门会把 挤成簇),于是反复回撤带来大量搬运开销,布局实际上”半静态”,FPQA 的动态能力被浪费。其二,无法集成存储区:若想引入存储区,初始布局必须整个放进存储区,而”每阶段回初始布局”意味着交互比特要在计算区与存储区之间来回横穿,区间通信开销吃掉全部收益 Ruan 2025。
PowerMove 的诊断是:这些缺陷的根源是分解方式本身——调度、分配、搬运各自的局部最优拼不出全局最优,必须让三者相互感知、联动求解。这正是”以移动为中心”(movement-centric)的含义:搬运不再是调度的附属品,而是与调度共同决定保真度的一等公民。
形式化模型
硬件模型与执行抽象
硬件为分区架构:计算区与存储区相距 (实验上至少 ),相邻位点间距 ;里德堡半径 ,激发期间非交互比特须保持 间距。AOD 满足两条硬约束:行/列只能整队平移、次序不可交叉;加速度 时搬运保真度近似为 1。支持多个独立 AOD 阵列并行搬运 Ruan 2025。
线路先综合成交替的”单比特门层 + CZ 门块”。一个阶段(stage)是共享比特互斥的一组 CZ,可在单次全局里德堡激发下并行完成;阶段之间由一次”装载–集体移动–存储”循环衔接(见FPQA 计算模型与能力边界)。
五因子保真度模型
输出保真度分解为五个独立因子 Ruan 2025:
- ()、():单比特门与 CZ 门;
- :旁观原子激发误差——每次全局里德堡激发()中,区内所有未参与门的 个原子都要白吃一次激发;
- ():每次 SLM↔AOD 换阱, 为总换阱次数;
- :量子比特 的累计空闲时长,——把比特送进存储区可让该项近似归零。
这一模型把编译器的优化目标指向三个可操作量:减少激发次数与旁观原子数(调度与布局)、减少换阱次数(搬运规划)、缩短空闲时长(存储区管理)。搬运时长按距离线性插值: 约 、 约 Ruan 2025。
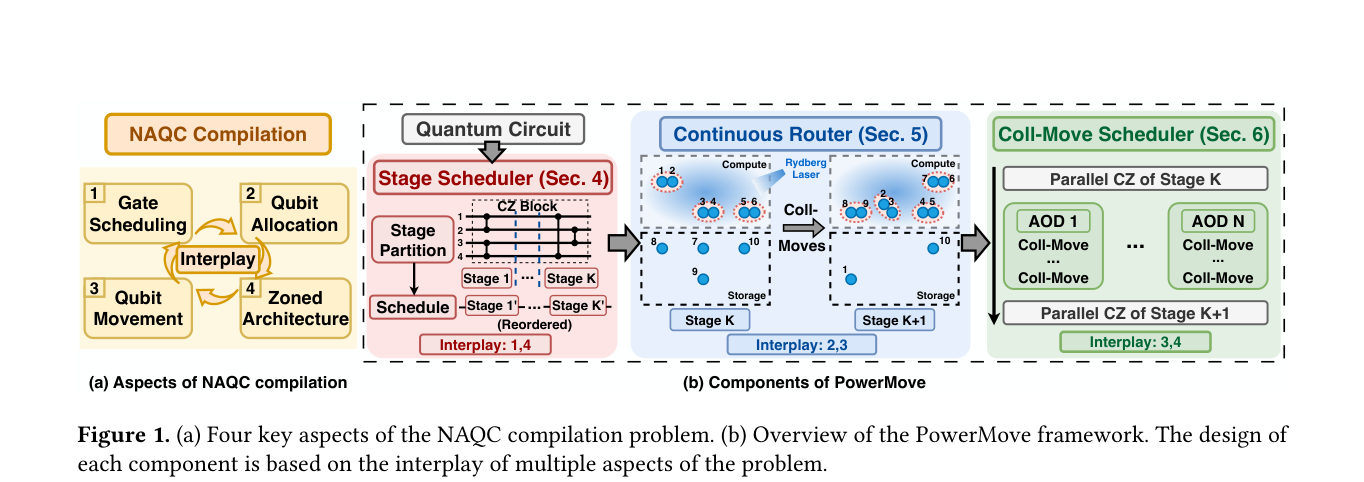
PowerMove 三组件流水线:Stage Scheduler 阶段划分与排序 → Continuous Router 静态/移动/未定标签 → Coll-Move 分组与多 AOD 调度(图源:Ruan 2025 Fig. 1)
方法与实现
PowerMove 的流水线由三个相互衔接的组件构成 Ruan 2025:
1. Stage Scheduler(阶段调度器)。先用边着色把 CZ 门块切成阶段:按度数降序处理门,与已有阶段无共享比特者并入同色,否则开新色(该算法近乎线性)。由于 CZ 块内的门相互对易,阶段的执行次序可以自由重排——调度器贪心地选下一个阶段,使交互比特集合的差 ()最小:给”移入存储区方向”的差更低的权重,因为进存储区是净收益(消激发、消退相干),出存储区只是必要开销。首个阶段选交互比特最少者,且初始布局整体放在存储区——此后布局连续演化、永不再回初始布局。
2. Continuous Router(连续路由器)。给定排好序的阶段列表,为下一阶段决定所有单原子移动,分三步:第一步,下一阶段无交互的比特全部标记为 mobile,按 坐标降序垂直搬入存储区最近的空位点(离存储区远的先选位,最小化总路程);第二步,对每个 CZ 按两原子当前所在区(存储/计算)的四种组合,给原子打上 static(原地不动等对方来)、mobile(必然要动)或 undecided(目标位点待定:位点被 static 占据会聚簇,或两个原子都在存储区需协商会合点)标签;第三步,为 undecided 原子在计算区就近搜空位定靶。最后把全部单原子移动打包成集体移动(Coll-Move):贪心分组,目标是组数最少、每组最大位移最小——组内距离均衡能压低以”最长位移”计时的搬运总时长。
3. Coll-Moves Scheduler(集体移动调度器)。对每个 Coll-Move 组统计移入(进存储区)与移出操作数之差 ,按降序排定执行次序——尽早进驻、尽晚撤离存储区,把空闲时长 压到最低;同时把独立分组分配给多个 AOD 阵列并行执行,直接利用硬件的并行搬运能力。
三组件的分工呼应了保真度模型:调度器压激发次数与旁观原子数,路由器压换阱数与搬运距离,移动调度器压空闲时长。
实验结果与对比
评测以 Enola 为基线(硬件间距 、分区相距 ),基准覆盖 QAOA(3/4 正则图与随机图,20–100 比特)、QFT(18/29)、BV(14/50/70)、VQE(30/50)与随机量子模拟 QSIM-rand(10/20/40)Ruan 2025。代表数据如下:
| 基准 | Enola 保真度 | PowerMove 保真度 | 保真度提升 | 执行时间加速 | 编译时间加速 |
|---|---|---|---|---|---|
| QAOA-regular3-100 | 0.01 | 0.14 | 12.8× | 2.73× | 3.66× |
| QFT-18 | 0.05 | 60.3× | 2.94× | 31.4× | |
| QFT-29 | 2.67× | 47.1× | |||
| BV-50 | 0.04 | 0.84 | 20.2× | 1.80× | 95.3× |
| BV-70 | 0.75 | 1,090× | 1.71× | 213.6× | |
| VQE-50 | 0.48 | 0.63 | 1.32× | 3.46× | 1.89× |
| QSIM-rand-40 | 0.14 | 2.05× | 64.7× |
汇总结论 Ruan 2025:全部基准上保真度提升数个数量级、执行时间缩短 、编译时间最高缩短 (BV-70:)。消融实验把收益归因拆开:仅用连续路由器(不引入存储区)平均保真度已提升最高 ;引入存储区后相对无存储区平均再提升 ,且区间搬运开销被阶段排序与集体移动消化,执行时间相对 Enola 仍最高缩短 。编译加速随规模增长,源于 Enola 依赖最大独立集(MIS)求解器而 PowerMove 用近线性启发式——NP 难的编译问题被换成”可扩展换质量”的交易。保真度提升随规模扩大的机理同样清晰: 与 两项都随比特数与阶段数累积,而存储区把这两项几乎清零。
参数与量级
| 量 | 典型值 | 来源 |
|---|---|---|
| 相邻位点间距 / 分区间距 | / (实验下限 ) | Ruan 2025 |
| 里德堡半径 / 旁观原子最小间距 | / | Ruan 2025 |
| 单比特 / CZ 门 | ()/ () | Ruan 2025 |
| 旁观原子激发因子 | (每次激发 ) | Ruan 2025 |
| SLM↔AOD 换阱 | , | Ruan 2025 |
| 相干时间 / 搬运加速度上限 | / | Ruan 2025 |
| 搬运时长示例 | ();() | Ruan 2025 |
| 对 Enola 总收益 | 保真度数个数量级;执行 ;编译最高 | Ruan 2025 |
| 存储区消融收益 | 相对无存储区平均保真度 | Ruan 2025 |
与其他概念的关系
- PowerMove 是分区架构抽象模型的完整编译实例:四条 AOD 约束、阶段/运行分层与”从物理阵列到逻辑阵列”的抽象在彼处统一展开。
- 其连续路由器与 Coll-Move 打包是原子搬运与相干输运能力在编译层的直接兑现——搬运保真度接近 1 才使”移动优先于门”成立。
- 与Arctic:FPQA 调度同属分区架构纯移动路线:Arctic 用 max-cut 分层 + 单 AOD 做到秒级编译,PowerMove 用三组件联动换取更高质量与多 AOD 并行。
- 对比基线 Enola 的调度框架见OLSQ-DPQA:可重构阵列的 Qubit 映射;更早的启发式对照组见Atomique 动态阵列编译与Q-Pilot 飞行 ancilla 编译。
- 旁观原子激发误差的物理来源(全局光束并行激发)承接并行纠缠门与里德堡阻塞。
- 存储区集成依赖免受激光扰动的闲置比特管理,与中电路测量与非破坏读出的空间隔离要求同源;后续”去迭代化”路线见ZAP 架构与编译器。
参考文献
- J. Ruan, X. Fang, H. Zhang, A. Li, T. Humble, Y. Ding, “PowerMove: Optimizing Compilation for Neutral Atom Quantum Computers with Zoned Architecture”, ASPLOS (2025). NA031 · arXiv:2411.12263 · DOI 10.1145/3676642.3736128
- D. B. Tan, W.-H. Lin, J. Cong, “Compilation for Dynamically Field-Programmable Qubit Arrays with Efficient and Provably Near-Optimal Scheduling”, ASPDAC (2025)(Enola,主要对比基线). NA028
- H. Wang et al., “Atomique: A Quantum Compiler for Reconfigurable Neutral Atom Arrays”, ISCA (2024). NA019
- H. Wang et al., “Q-Pilot: Field Programmable Qubit Array Compilation with Flying Ancillas”, DAC (2024). NA026
- Y. Stade, L. Schmid, L. Burgholzer, R. Wille, “An Abstract Model and Efficient Routing for Logical Entangling Gates on Zoned Neutral Atom Architectures”, IEEE QCE (2024). NA017
- D. Bluvstein et al., “A quantum processor based on coherent transport of entangled atom arrays”, Nature (2022)(分区架构实验原型). NA143
- C. Huang et al., “ZAP: Zoned Architecture and Performant Compiler for Field-Programmable Atom Array”, IEEE Trans. Quantum Eng. (2026). NA046