问题背景
中性原子阵列的相干时间可达数十秒、规模可达数千 qubit,而实验已演示保真度不低于 0.9999 的计算中相干搬运——用”移动原子”取代”SWAP 门”做路由因此成为高保真替代方案 Decker 2024。分区架构(zoned architecture,见分区架构)把原子平面划成三个功能区:存储区(闲置 qubit 与单独寻址的单比特门)、纠缠区(被全局里德堡激光照亮的耦合区)、测量区(中电路测量),以此减少 qubit 暴露在激光与散射下的时间。
在此架构上做编译面临一组刚性约束:SLM 静态阱可排任意拓扑但执行中固定;AOD 可动阱只能是矩形阵列、原子按整行/整列移动、行与列不能相互交叉(只能整体拉伸压缩);SLM↔AOD 陷阱转移一次约 ,是整台机器最耗时的操作 Decker 2024。此前的可重构阵列编译器各有短板:OLSQ-DPQA(见OLSQ-DPQA:可重构阵列的 Qubit 映射)把约束写成 SMT 布尔方程,求解动辄数天且让闲置 qubit 白白暴露在里德堡激光下;FPQA-C、Q-Pilot 等”组间路由”方案可扩展,但组间仍靠 SWAP 门衔接,同样不考虑全局激光的无谓照射 Decker 2024。Arctic 的目标是三者兼得:完全不用 SWAP、尊重分区、编译时间在秒级——据作者所述,这是第一个专为分区架构设计、且唯一纯靠原子移动实现全连接的编译技术。
形式化模型
分层即 max-cut
从线路出发,Arctic 只保留”可与别的门并行执行”的双比特门构造连接图(因电路依赖必须串行的门被剔除——它们无论怎么摆都不增加并行度)。把 qubit 分配到上下两个原子层,等价于在连接图上求最大割(max-cut):割两侧的 qubit 之间的门恰好都跨越两层、沿垂直于两层的方向(即原子搬运方向)发生。直觉是:AOD 整行整列移动的收益在纠缠方向一致时最大——一列原子拉进纠缠区,整列都是”成对待纠缠”的原子。max-cut 是 NP 困难问题,Arctic 采用 Goemans–Williamson 型半定规划,拥有 0.87 近似比与多项式运行时间,这是它保持秒级编译的关键 Decker 2024。
交叉最小化
层内水平排序决定搬运轨迹的交叉数:两个 qubit 交换水平位置,跨层边就会交叉,对应的 AOD 行列被迫串行。这是经典的二层直线交叉最小化问题;对全连接的双层图,任何水平交换都不改变结构,因此稀疏图才是优化的主战场。Arctic 用 GRASP 启发式(构造 + 改进两阶段)近似求解,改进阶段按度加权分布
概率采样候选 qubit,仅当交叉数下降才接受位置调整 Decker 2024。
保真度模型
沿用OLSQ-DPQA的框架并做分区化修改:
关键区别在 ——第 层被里德堡激光照到的 qubit 数:分区架构下只有被搬进纠缠区的原子才吃双比特门误差,闲置 qubit 留在存储区不进误差项;门时间本身被忽略,因为陷阱转移远比门慢。退相干项中的移动时间 按陷阱转移( 量级)与进出纠缠区约 的路程估算,,, Decker 2024。这个模型显式地把”激光照射次数与照射人数”变成第一阶代价,与FPQA 计算模型中全局门的原生开销一致。
方法与实现
Arctic 三阶段流水线 Decker 2024:
- 分层(layer assignment):对过滤后的连接图跑半定 max-cut,把 qubit 分到两层,最大化跨层(即沿搬运方向)的双比特门数。
- 交叉最小化(cross minimization):GRASP 构造阶段按未加权度从高到低放置 qubit,位置取已放邻居的重心(barycenter),让相连 qubit 尽量同列;改进阶段按上式概率采样、尝试重心或重心 ±1 位置,交叉数下降才接受。经验上 30 次迭代即收敛。
- 堆叠(stacking,维度权衡):引入用户可调的水平宽度参数 ,把双层解”压扁摊开”成多层——新层只从原上/下层取 qubit 且保持水平次序(从而复用交叉最小化的成果);层按门操作频率(边权和度)垂直排序。拓扑上提出”执行区居中”包裹式排布:最活跃的两层放执行区两侧 位置,次活跃层放 ,依次向外。例如水平限制为 3 时,操作频率最高的 6 个 qubit 进驻头两层。 越小阵列越窄、层数越多,代价是垂直堆叠引入新的串行化——正上方/正下方的边必须串行执行(除非是直接平移)。
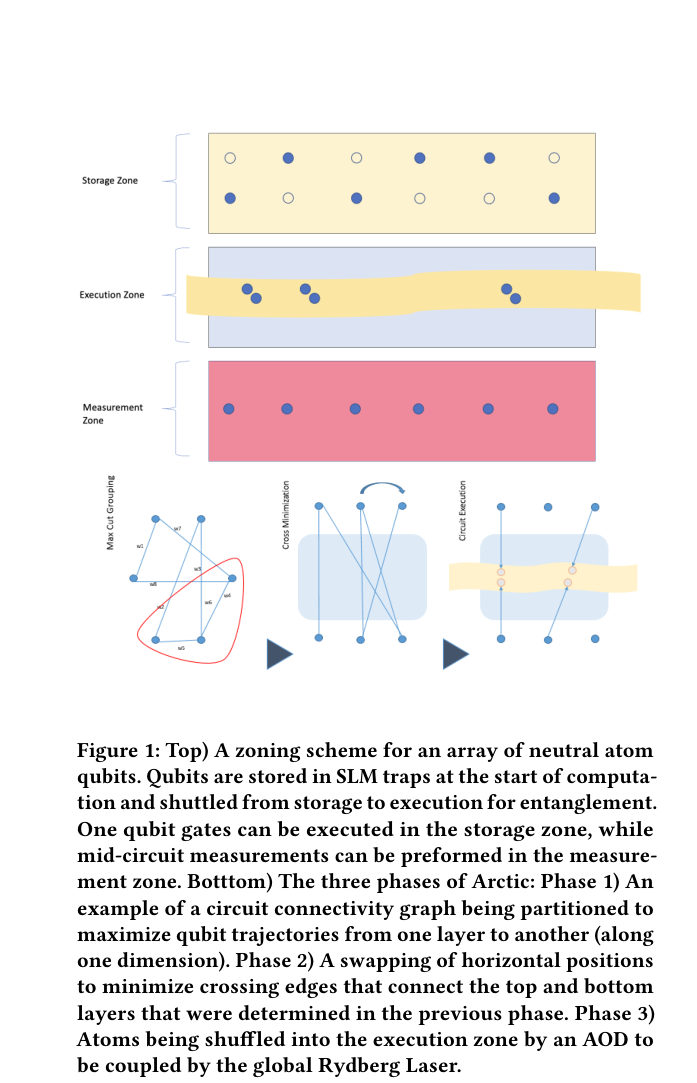
分区架构与 Arctic 三阶段示意:存储/纠缠/测量区、连接图 max-cut 分层、重心交叉最小化、AOD 把原子整列拉进执行区(图源:Decker 2024 Fig. 1)
执行期每层每步只有两次搬运(进、出纠缠区),闲置原子从不进入激光路径。堆叠阶段保持水平次序不变还有一层工程红利:交叉最小化的计算成果可以跨层复用,新增层不需要重新优化。Arctic 目前只假设单个 AOD,但其并行搬运批次天然可以分配给未来配备多个 AOD 的设备 Decker 2024。模拟环境为单 SLM + 单 AOD;基准取自 SupermarQ 与 QASMBench(另加自定义 QAOA 生成器),Qiskit 0.44 优化等级 3、全连接后端转译到 基;每个指标记录 10 次运行的最优值。对照组为 FPQA-C(当时最先进的可重构编译)与按 Sycamore 参数建模的固定超导方阵(、、每层 25 ns、基 )Decker 2024。
实验结果与对比
| 指标(SupermarQ/QASMBench 基准,10 次取最优) | FPQA-C | Arctic | 结论 |
|---|---|---|---|
| 全局脉冲数 | 基线 | 多数算法类至少少 50% | 最好情形降 5× |
| 转译后门数 | 随深度/连通度指数增长(SWAP 开销) | 常数(转译后不变) | 无 SWAP 开销 |
| 保真度 | 基线 | 最好情形提升 7× | 受益于分区+纯移动 |
| 编译时间 | — | 稳定秒级,测试中不超过 2 分钟 | 首个秒级纯移动编译 |
三条结果链条都指向同一机制:纯移动路由消除了 SWAP 门数随问题规模的指数爆炸——深而稠密的算法下 SWAP 基编译器门数指数增长,而 Arctic 转译后门数不变;分区让闲置 qubit 免遭里德堡激光,这是 FPQA-C 在全局照射模型下损失保真度的主因;交叉最小化让每次 AOD 查询装满并行门,压制了分区架构最贵的陷阱转移时间。作者也坦承局限:非常稠密的全连接图上 FPQA-C 仍有竞争力;垂直堆叠引入的串行化、多 AOD 硬件、多维构型与多品种原子阵列是留给后续工作的方向 Decker 2024。
参数与量级
| 量 | 典型值 | 来源 |
|---|---|---|
| 单/双比特门保真度 | , | Decker 2024 |
| 相干时间 (中性原子模型) | Decker 2024 | |
| 陷阱转移时间 | (每层每步 2 次搬运) | Decker 2024 |
| 相干搬运保真度 | (实验演示) | Decker 2024 |
| max-cut 近似比 | 0.87(Goemans–Williamson 半定规划) | Decker 2024 |
| GRASP 迭代数 | 30(经验值) | Decker 2024 |
| 脉冲数缩减 | 多数算法类 ,最好 5× | Decker 2024 |
| 保真度提升 / 编译时间 | 最好 7×;秒级( 分钟) | Decker 2024 |
与其他概念的关系
- 直接面向分区架构:存储/纠缠/测量分区的误差抑制是 Arctic 保真度模型与”执行区居中”拓扑的出发点。
- 调度对象是FPQA 计算模型中”整行/整列移动 + 全局里德堡门”的原生指令集;全局脉冲串扰的物理基础见并行纠缠门与阻塞 CZ 门。
- 与OLSQ-DPQA的 SMT 路线互补:Arctic 用多项式启发式换取秒级编译,是”近优换可扩展”的典型案例。
- 与Atomique 动态阵列编译同用图割思想:Atomique 在门频图上做 MAX k-Cut 分组(多 AOD、组间 SWAP),Arctic 在连接图上做二分 max-cut(单 AOD、组间纯移动)。
- 搬运操作本身的时间与保真度参数由原子搬运与相干输运的实验数据支撑;测量区的前途与中电路测量的编译衔接是自然延伸。
- 后续面向分区的更完整编译系统见PowerMove 分区架构编译与ZAP 架构与编译器。
- 其分区硬件蓝本来自 48 逻辑比特的逻辑量子处理器实验;规模化路径与大规模阵列与连续运行相通。
- 基准算法取自 SupermarQ 与 QASMBench 两大套件,其设计定位与覆盖面见通用量子基准套件。
参考文献
- E. Decker, “Arctic: A Field Programmable Quantum Array Scheduling Technique”, 预印本 (2024). NA018 · arXiv:2405.06183
- B. Tan, D. Bluvstein, M. D. Lukin, J. Cong, “Qubit Mapping for Reconfigurable Atom Arrays”, ICCAD (2022)(保真度模型来源,题录经 NA018 参考文献核实)· DOI 10.1145/3508352.3549331
- H. Wang et al., “FPQA-C: A Compilation Framework for Field Programmable Qubit Array”, arXiv:2311.15123 (2023)(对比基线,题录经 NA018 参考文献核实)
- D. Bluvstein et al., “Logical Quantum Processor Based on Reconfigurable Atom Arrays”, Nature 626, 58 (2024)(分区硬件来源,题录经 NA018 参考文献核实)· DOI 10.1038/s41586-023-06927-3