问题背景
多数中性原子架构不具备完全的局域单比特寻址:原生门集是 ,其中全局转动 对所有 个比特同步施加相同的 转动(见FPQA 计算模型)。若全局门只为少数比特服务,编译器必须把”误伤”的其他比特旋转回来,导致深度与门数膨胀、误差累积 Nottingham 2024。
另一类广泛部署的折中是矩形寻址(rectangular / row-column addressing):2D 声光偏转器(AOD)的行与列各自独立调制,激光只在行×列交点上生效。这一方案在实验上已被大规模逻辑量子处理器采用——AOD 调制的光束在交点比特上实现 门 Bluvstein 2023。矩形寻址把控制电子学通道数从 压到 ,平方级削减控制复杂度,同时保留退化意义上的独立寻址(单点也是矩形);代价是可能需要更多寻址轮次(深度)。Tan、Ping 与 Cong 把”深度最优的矩形寻址”形式化为精确二值矩阵分解(Exact Binary Matrix Factorization, EBMF),并指出这是出现在通信复杂度与组合优化中的 NP-hard 问题 Tan 2024。
理论模型
矩形与 EBMF
把一次寻址任务写成二值矩阵 ( 表示该比特要被寻址)。(组合)矩形是形如 (, )的集合。指示矩形的矩阵 只在一个矩形上为 ,故秩为 1;若
则称 为 的 EBMF,最小的 称为二值秩 。注意求和是在 上而非 上——例如单位阵形 矩阵看似可用 2 个”模 2 矩形”表示,但在 上会重叠违约,实际需要 3 个矩形 Tan 2024。把 视为二部图邻接矩阵时,EBMF 等价于把边划分为最少个完全二部子图(biclique partition),此问题 NP-hard。
下界:fooling set
通信复杂度给出干净的谱系: 不小于最大 fooling set 大小 ——即满足” 且对任意不同对 有 或 “的 1-位置集合。论文的核心例子是 矩阵:找到大小为 5 的 fooling set,随即证明其 5-矩形划分最优 Tan 2024。平凡上界是去掉空行/重复行后的 。
容错计算的张量结构
容错运行时,逻辑操作 对应逻辑层 2D 图案 ,物理层是补丁内图案 ,总操作为张量积 。实秩在张量积下可乘(都可用初等行变换化为上三角),而二值秩是否可乘是公开问题;已知
前者给出可上界的构造(对补丁内全 1 的简单图案 ,逻辑层划分即最优解),后者给出下界 Tan 2024。对逻辑比特更全局化的qLDPC 码一维排布,作者猜测逐行寻址通常已足够。
方法与实现
论文提出 SAP(SMT and packing)算法:先用启发式 row packing 快速得到上界,再用 SMT 求解器迭代逼近最优 Tan 2024。
Row packing 启发式。逐行处理矩阵,维护一组”基向量”(每个对应一个矩形):若行 包含某基向量 的支撑,就把 并入对应矩形(纵向生长)并从 中扣除;剩余的 1 组成残差,或作为新基向量加入,或触发既有矩形的横向收缩与基更新。由于打包顺序影响结果,随机打乱行序多次重跑( 次试验),并对矩阵与其转置各跑一遍取优。每次试验最多为每个非重复行引入一个矩形,保证不劣于平凡启发式;复杂度 。
SMT 精确求解。把分解写成函数 ( 是 1-位置集, 是矩形标签集),用 SMT 的未解释函数与位向量编码;核心约束只有一组(对每个 1-位置对 ):
以 row packing 的结果减一为初值 ,逐次把约束 加入收窄界限,直到不可满足(UNSAT)即证最优。实现基于 numpy 与 z3-solver,MIT 协议开源(UCLA-VAST/EBMF),在 AMD EPYC 7V13 上完成评估 Tan 2024。
两个后续方向值得留意:其一,阵列中未被加载的格位是天然的”无所谓”位置——被打多少次都无妨,把它们当作 don’t care 可进一步削减矩形数,问题随之变为二值矩阵补全;其二,打包过程可用 Knuth 的精确覆盖算法 X 替代纯随机重排 Tan 2024。
实验结果与对比
三组基准:随机矩阵(,占据率 10%–90%;,占据率 1%–20%—— 被视为当前原子阵列技术的规模上限)、已知最优解的构造矩阵(秩 )、以及刻意拉开实秩与二值秩差距的”gap”矩阵(2–5 个行对,各 100 个 )Tan 2024。
| 基准( 除注明外) | 平凡启发式 | row packing×10 | 结论 |
|---|---|---|---|
| 随机 | 80% | 99% | 接近全优 |
| 随机 | 62% | 96% | 规模化良好 |
| 已知最优 | 100% | 100% | 全部命中 |
| gap:2 行对 | 29% | 100% | 最优 |
| gap:3 行对 | 16% | 100% | 最优 |
| gap:4/5 行对 | 40% / 84% | 98% / 96% | 需更多试验 |
(表中百分比为找到最优解的比例。)要点:随机矩阵的实秩与二值秩以高概率相等(占据率高时几乎必满秩);已知最优组被 row packing 轻松命中,而平凡启发式在 gap 组上崩溃,说明 row packing 远非平凡;最耗时的案例是 SMT 证明 UNSAT——求解器需逐级收紧界限并证明不可满足 Tan 2024。
时序感知的映射与调度(NA016)
与”空间图案怎么分解”互补的问题是”什么时候执行”。Li 等的 Timing-Aware Qubit Mapping and Gate Scheduling(IEEE TCAD 2023)即综述中的 Q-Tetris 映射器(C++ 实现,得名于其对积木式问题的类比):与以往工作不同,它为单比特门、多比特门与 SWAP 门分别设定不同的执行时间,映射与调度采用贪心启发式结合蒙特卡洛树搜索(MCTS)插入必要的 SWAP,以线路总执行时间(而非门数)为目标 Li 2023 Schmid 2024。本站语料未收录 NA016 原文的提取文本,机制描述经 Schmid 2024 综述转述;在综述自己的评估中,与 Qiskit 基线启发式相比,Q-Tetris 平均减少 – 的空闲时间,代价是 SWAP 门数至多翻倍 Schmid 2024。
作为可查证的另一参照,Nottingham 等对受限寻址的系统级处理表明:把单比特门编组为 SQGM/MQGM 时刻、用横向分解把每个时刻的总全局转角压到最小并联合调度,相对未优化流水线最高加速 (几何均值 ),相对既有逐门直分解方案最高 (几何均值 ),大线路保真度提升数个数量级 Nottingham 2024。
参数与量级
| 量 | 典型值 | 来源 |
|---|---|---|
| 控制位压缩 | 对比 (平方级) | Tan 2024 |
| 问题复杂度 | EBMF / biclique partition,NP-hard | Tan 2024 |
| row packing 复杂度 | ( 次试验) | Tan 2024 |
| 基准规模上限 | (当前阵列技术上限) | Tan 2024 |
| row packing 最优率 | 96%–100%(10 次试验,各基准组) | Tan 2024 |
| 求解栈 | numpy 1.26.3 + z3 4.12.1.0,AMD EPYC 7V13 | Tan 2024 |
| 全局门调度收益 | 最高 加速(几何均值 ) | Nottingham 2024 |
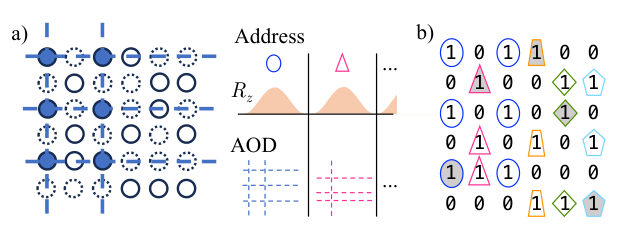
6x6 矩形的 5-矩形划分与 fooling set 标记(图源:Tan 2024 Fig. 1)
与其他概念的关系
- 受限寻址的原生门集与全局门 的形式化定义见FPQA 计算模型;横向/轴向分解与 -Opt 调度是该模型的工程化。
- 行列交点寻址的实验载体是可重构逻辑处理器 逻辑量子处理器;大阵列本身的组装与维持见大规模阵列与连续运行。
- 寻址深度只是编译成本的一环:完整的映射-搬运-调度框架见OLSQ-DPQA、Atomique 动态阵列编译与Arctic:FPQA 调度。
- 多比特门与受限寻址的正交性:全局单比特受限时,原生 CCZ(见Geyser:原生多比特门编译)与并行双比特门(并行纠缠门)仍然局域可用。
- 容错侧的张量结构对应qLDPC 码架构的块排布与分区架构的分区级操作。
参考文献
- D. B. Tan, S. Ping, J. Cong, “Depth-Optimal Addressing of 2D Qubit Array with 1D Controls Based on Exact Binary Matrix Factorization”, Proc. DATE 2024 (2024). NA022 · arXiv:2401.13807 · DOI 10.23919/DATE58400.2024.10546763
- Y. Li, Y. Zhang, M. Chen, X. Li, et al., “Timing-Aware Qubit Mapping and Gate Scheduling Adapted to Neutral Atom Quantum Computing”, IEEE Trans. Comput.-Aided Des. Integr. Circuits Syst. (2023). NA016 · DOI 10.1109/TCAD.2023.3261244
- N. Nottingham, M. A. Perlin, D. Shah, R. White, et al., “Circuit Decompositions and Scheduling for Neutral Atom Devices with Limited Local Addressability”, IEEE QCE (2024). NA020 · arXiv:2307.14996
- D. Bluvstein, S. J. Evered, A. A. Geim, et al., “Logical quantum processor based on reconfigurable atom arrays”, Nature 604, 451 (2023). NA153 · DOI 10.1038/s41586-023-06927-3