问题背景
综合(synthesis)的标准做法是把任意幺正分解到固定的基元门集(见基本门分解),中性原子编译器再把基元门映射到 CZ、搬运与全局门上(见FPQA 计算模型)。这条流水线对超导平台是自然的,但对中性原子有一种系统性浪费:里德堡阻塞机制天然支持一个脉冲同时对多个原子施加受控相位(见多比特阻塞门与Toffoli/CCZ 门),而”先分解后编译”的门流里多比特结构早已被打散,无从利用。
Geyser(ISCA 2022,Patel–Silver–Tiwari)是系统社区首个正面处理这一问题的编译框架:不是把大幺正分解到含多比特门的基元集,而是反过来把线路中的双比特门块合成为 Toffoli 块 Patel 2022。据 Schmid 等人的综述转述,其综合步骤是在线路中识别恰好涉及三个量子比特的门块(gate blocks),寻找由 Toffoli 门与单比特门构成的等价门序列来替换,并以希尔伯特–施密特距离最小化作为等价性判据 Schmid 2024。
本站语料未收录 NA012 原文的提取文本,本词条关于 Geyser 机制的描述以 Schmid 2024 综述的转述与论文题录为据;Geyser 原文的实验数字不予转引,下文量化证据全部来自本站有提取文本的相关工作。
形式化模型
门块替换与等价判据
给定线路段 (涉及量子比特 ),寻找 Toffoli 与单比特门的复合 使其逼近 ,判据为希尔伯特–施密特距离
当且仅当两算子完全相等。Toffoli/CCZ 的矩阵形式为
它是三比特对角门,可由里德堡阻塞单脉冲方案原生执行:综述指出 CCZ 的几何约束是三原子共线、中间原子与两端距离不超过交互半径 (长程交互与阻塞半径的定义见FPQA 计算模型)Schmid 2024。若分解成 CZ 原生集,每个逻辑 CNOT 还要展开为 –CZ– 三道工序 Huang 2026——分解链的每一环都在加脉冲。
优化目标:脉冲数而非门数
Geyser 在评估时不以门计数、而以激光脉冲计数(laser pulse count)为目标函数——综述指出这可视为线路总执行时间的估计 Schmid 2024。这一选择背后是中性原子的成本结构:
- 一个原生多比特门只需一次里德堡脉冲(约 、保真度约 –,对比 CZ 约 、)Schmid 2024;
- 限制体积(restriction volume)会把空间上重叠的门强制串行,执行时间随之膨胀——这正是综述强调的调度瓶颈 Schmid 2024;
- SWAP 由多次搬运或三个 CX 构成,脉冲成本远高于普通门。
因此”门数最少”与”脉冲数最少”在多比特原生平台上并不等价,后者才是执行时间的正确代理指标。
约束:门块互不限制
映射阶段使用 Qiskit 完成布局与路由,前提条件是构造出的 Toffoli 块之间不互相限制(not restrict each other)Schmid 2024——即参与不同 Toffoli 门的原子组在执行时刻彼此处于限制体积之外。这把”多比特门能否并行”的调度问题前移到了综合阶段:只要块与块的量子比特集不相交且空间可分离,后续调度就能安全并行化这些块。
方法与实现
综述按能力轴把现有编译器分为四类,Geyser 是多比特门型编译器的代表,且是能力矩阵中唯一具备”多比特综合”(标注为 Toffoli 门块组合)的现有工具,代码在 GitHub 开源(Python)Schmid 2024。完整流程为:
- 综合:扫描输入线路,识别三比特门块;对每个块求解最小化 的 Toffoli + 单比特门替换;
- 映射:将替换后的线路交给 Qiskit 的映射器,在保证 Toffoli 块互不限制的前提下布置到原子阵列;
- 调度与评估:按脉冲数统计执行成本,完成”综合 → 映射与路由 → 调度”的完整链路。
作为对照,同处”多比特门型”一格的 Q-Tetris(Li 等,即受限寻址的分解与调度词条中的时序感知映射器)区分单比特、多比特与 SWAP 门的不同执行时间做时序感知调度,但综合仍落在传统门集;长程门型(Baker、Brandhofer)与搬运型(OLSQ-DPQA、Q-Pilot 等)则完全不做多比特综合 Schmid 2024。Geyser 的位置因此在”以前所未探索的综合任务为焦点”,让原生多比特门成为综合的输出而非分解的牺牲品。
后续路线:把高阶相位结构留到硬件层。Möbius 编译器(NA042)把这一思想推到对角门全族:对角相位函数经子集格上的 Möbius 反演变成相位超图,每条超边 对应占据投影子相位
支撑集 的项作为原生多比特受控相位候选交给调度器(计入原子运动、交互区容量、阻塞可行性与误差成本),超过截断的项才回退到固定的 CNOT/相位模板分解 Huang 2026。Geyser 与它的共同点是:分解不是默认动作,而是调度阶段的受控决策。
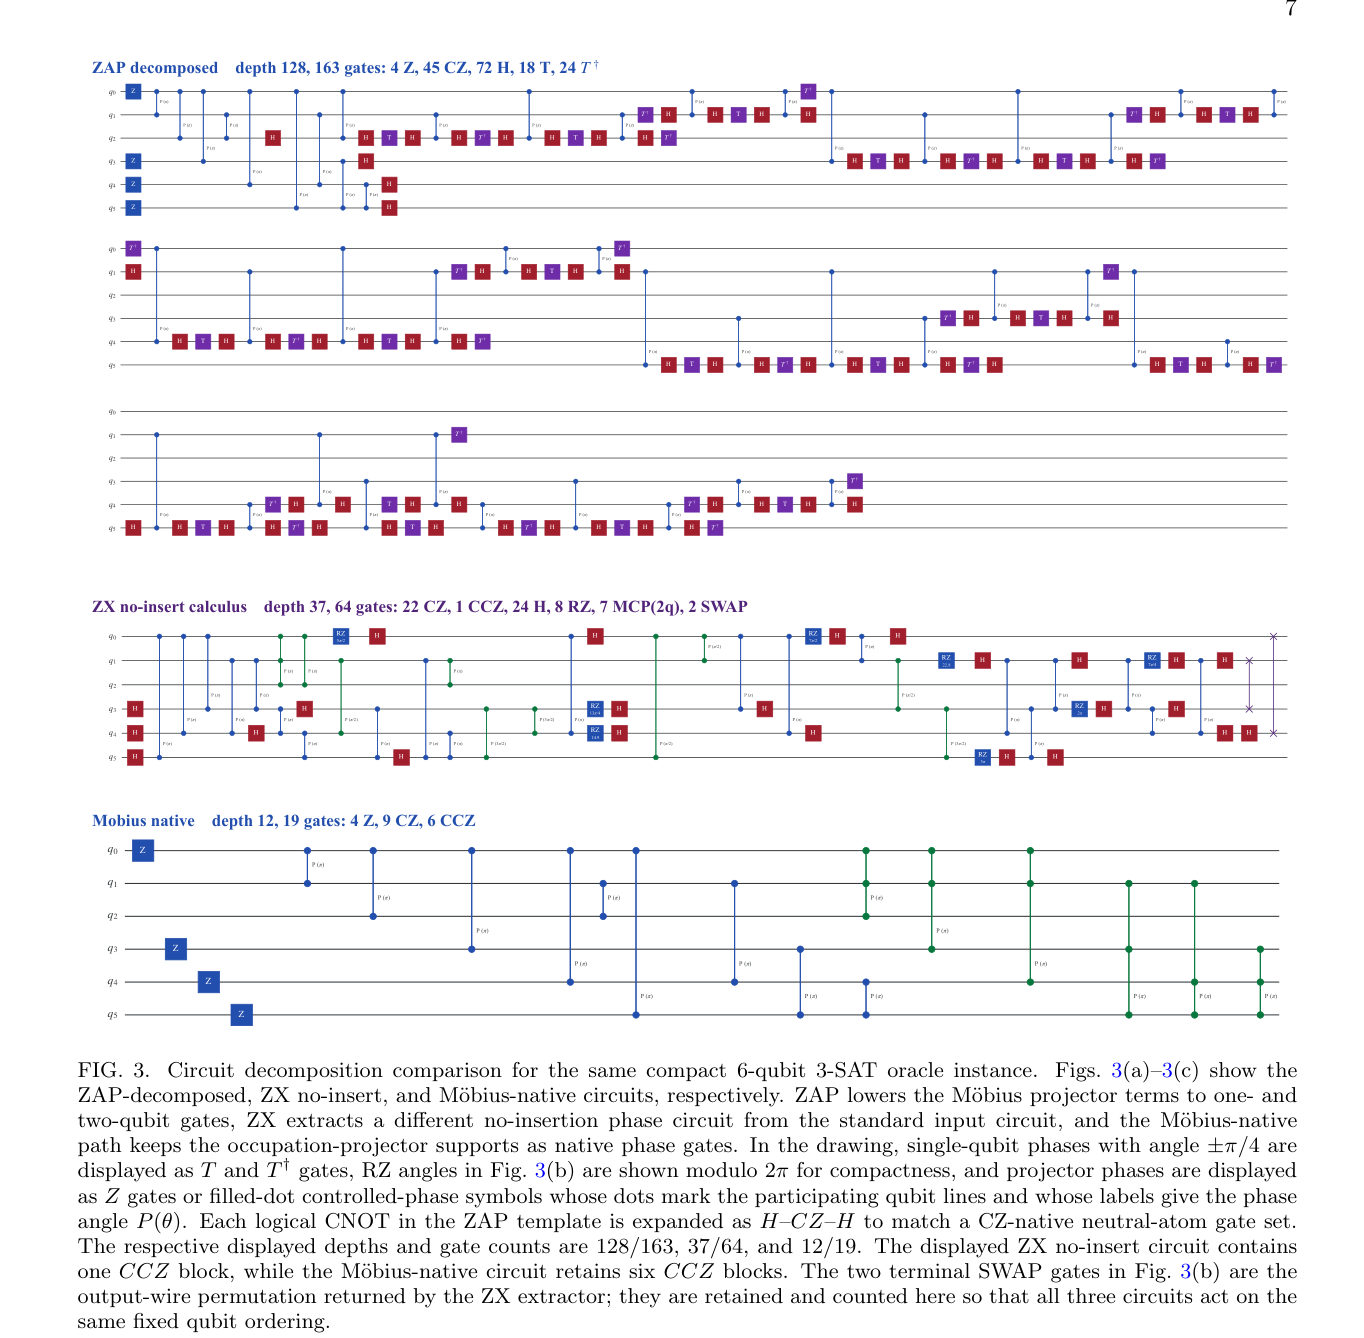
同一 3-SAT 预言机线路的三种编译对比:ZAP 分解(128 深)vs 保留原生 CCZ 块(12 深)(图源:Huang 2026 Fig. 3)
实验结果与对比
本地语料没有 Geyser 原文的实验数字,这里用两条有据的旁线说明”保留原生多比特结构”的价值。
其一,硬件参数层面:综述汇总的原生 CCZ 约 、–,而把多控门分解为 CZ 链需要多倍脉冲与大量单比特补偿,误差沿链累积 Schmid 2024。
其二,受控对照层面(NA042,同一调度器与路由器下的公平比较):对 6 比特 3-SAT 相位预言机,
| 编译流 | 深度 | 门数 | 备注 |
|---|---|---|---|
| ZAP(投影子先拆到单/双比特门) | 128 | 163 | 无原生高阶门 |
| ZX 演算(无插入) | 37 | 64 | 含 1 个 CCZ 块 |
| Möbius 原生(保留投影子) | 12 | 19 | 保留 6 个 CCZ 块 |
在更大的基准族上,含三、四体相位项的实例(3-SAT、QAOA、p-spin Ising、超图态、QRAM、乘法器预言机)中,Möbius 原生流的路由后估计成功率 系统性高于 ZAP 与 ZX 基线,且线路越大优势越大(分解基线的两比特门、路由阶段与空闲暴露随 快速累积);而纯两体实例(QFT 相位层、GHZ 链)三条曲线几乎重合——说明收益恰恰来自被保留的多比特结构 Huang 2026。这正是 Geyser 当年指出的问题的现代重述。
参数与量级
| 量 | 典型值 | 来源 |
|---|---|---|
| 原生 CCZ 门 | , | Schmid 2024 |
| CZ 门(对照) | , | Schmid 2024 |
| 单比特门(Rb,对照) | , | Schmid 2024 |
| CCZ 几何约束 | 三原子共线,间距 | Schmid 2024 |
| NA042 原生截断 | 体相位项 | Huang 2026 |
| 6 比特 3-SAT 深度/门数 | (ZAP)对 (原生保留) | Huang 2026 |
| Geyser 目标函数 | 激光脉冲计数(执行时间代理) | Schmid 2024 |
与其他概念的关系
- 原生 Toffoli/CCZ 门的物理实现(阻塞机制、最优几何与时间最优脉冲)见Toffoli/CCZ 门与多比特阻塞门;限制体积与阻塞因子的形式化见FPQA 计算模型。
- Geyser 解决的”综合”一步是标准分解理论(基本门分解)的多比特原生版延伸;对角多比特相位结构的系统综合见对角线路综合、相位 Gadget 与浅深综合与多控相位门综合。
- 门块并行性受限制体积约束,与并行纠缠门的串扰分析同源;阵列表述的布局前提见算法相关布局选择。
- 原生三比特门在容错侧的收益(降低稳定子测量深度)见三比特门容错稳定子测量;图论侧的等价工具见ZX 演算与PyZX 与图论化简。
参考文献
- T. Patel, D. Silver, D. Tiwari, “Geyser: a compilation framework for quantum computing with neutral atoms”, Proc. 49th Int. Symp. on Computer Architecture (ISCA), pp. 383–395 (2022). NA012 · DOI 10.1145/3470496.3527428
- L. Schmid, D. F. Locher, M. Rispler, S. Blatt, J. Zeiher, M. Müller, R. Wille, “Computational capabilities and compiler development for neutral atom quantum processors”, Quantum Sci. Technol. 9, 035023 (2024). NA009 · arXiv:2309.08656
- H. Huang, Y. Gu, C. Huang, X. Zhao, M.-J. Hu, D. E. Liu, J. Wang, “Möbius-Guided Diagonal-Gate Compilation with Native Multiqubit Controlled-Phase Gates on Neutral-Atom Processors”, arXiv:2607.08212 (2026). NA042 · arXiv:2607.08212