问题背景
NISQ 时代迫切需要回答三个问题:这台设备跑我的应用行不行?这个编译器/调度器输出的电路好不好?这个模拟器可不可信?单一指标(如量子体积)只能测方型随机电路,无法覆盖化学模拟、优化、机器学习等真实负载的多样性 Li 2023。同时,各工具链用各自的抽象层级与指标定义报告结果,导致横向比较困难——这一痛点后来在中性原子编译器评测中被系统证实(见编译器公平评测与可视化)。
SupermarQ 提出把经典基准方法学(如 SPEC CPU 的覆盖度思想)系统移植到量子领域,要求基准套件满足四条设计原则:可扩展(电路能在任意比特数上生成)、有意义且多样(覆盖真实应用域)、共享抽象层级(如统一到 OpenQASM,让编译器参与整体性能)、自适应(随算法与硬件演进持续更新)Tomesh 2022。QASMBench 选择”低层级”路线:直接以 OpenQASM 汇编表示固经常用子例程与内核,在通用性与易用性之间折中 Li 2023;MQT Bench 则押注”跨层级”:同一算法在四层抽象上提供基准,以比较软件工具在不同层级的表现 Quetschlich 2023。
理论模型
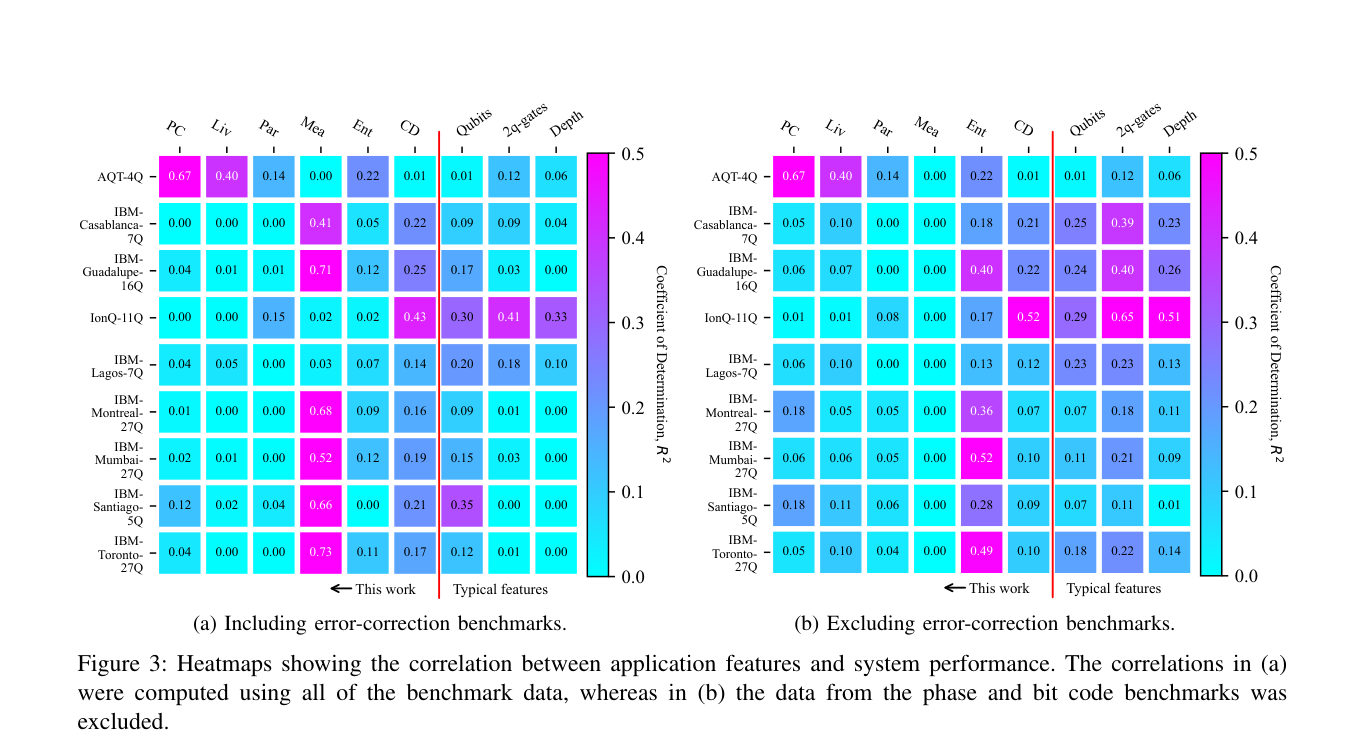
SupermarQ 的六维特征向量
每条基准应用映射为特征空间中的一个点,六个特征定义如下 Tomesh 2022:
- 程序通信(Program Communication):电路中双比特交互的局域性/连通需求;
- 临界深度(Critical Depth):关键路径上双比特门占比,
其中 为最长依赖路径上的双比特门数, 为双比特门总数;高值表示误差沿关键路径复利累积; 3. 纠缠比(Entanglement-Ratio):
双比特门占全部门的比例,粗略刻画电路纠缠量(无纠缠的电路可被经典高效模拟); 4. 并行度(Parallelism):
门数与”深度 × 比特数”上限之比,衡量对串扰(crosstalk)的敏感度; 5. 测量(Measurement):
含测量/重置操作的层数占比,聚焦中电路测量(见中电路测量与非破坏读出); 6. 活性(Liveness):由 的 0-1 活性矩阵定义,统计量子比特空闲频率,刻画退相干暴露。
一套基准的覆盖度定义为其特征向量集在六维空间张成的凸包体积;SupermarQ 用 8 个应用(GHZ、Mermin–Bell、Phase Code、Bit Code、ZZ-SWAP QAOA、Vanilla QAOA、VQE、哈密顿模拟)在 3 到 1000 比特规模上生成实例,其覆盖度优于纯合成套件 Tomesh 2022。
QASMBench 的四个电路指标
在宽度、深度之外,QASMBench 提出(记门槽数 宽度为 网格)Li 2023:
其中 是比特 的活跃深度, 是落在比特 上的双比特门数。保持寿命估计电路相对 的退相干暴露;纠缠方差大的电路在映射到受限拓扑时更受益于好的逻辑–物理比特映射(对中性原子而言,受FPQA 计算模型中布局自由度的影响则不同)。
MQT Bench 的四层抽象
同一算法按 openQASM 3.0 结构分为四级输出:算法级(无门集约束)、目标无关级(通用门集分解)、目标相关原生门级(绑定某设备的原生门集)、目标相关映射级(完成布局与路由,绑定具体拓扑)Quetschlich 2023。这使得”分解开销”与”映射开销”可以被分开度量——正是评测OLSQ-DPQA这类映射工具、Geyser 原生门编译这类分解工具所需的基准形态。
方法与实现
QASMBench。 电路按规模分小(1–5 比特)、中(6–15)、大(15–127)三档,覆盖化学、模拟、线性代数、搜索、优化、算术、机器学习、容错、密码等领域。评估流程:在 12 台 IBM-Q 设备上对子集电路做密度矩阵态层析(共 25K 次电路评估),并比较 IBM-Q、IonQ QPU(离子阱)与 Rigetti Aspen M-1 的执行保真度 Li 2023。
SupermarQ。 通过 SuperstaQ 工具流”一次编写、多后端执行”,在 7 台 IBM 超导 QPU、IonQ 与 AQT@LBNL 上采集结果;GHZ 基准以实验输出分布对理想分布(各半的 与 )的 Hellinger 保真度评分,Mermin–Bell 基准则以 形式的 Bell 检验期望评分 Tomesh 2022。
MQT Bench。 提供 Web 界面与 Python 包,含 70,000 余条基准电路,规模 2–130 比特,四层抽象分别导出,支持自定义门集与架构扩展 Quetschlich 2023。
MQT Predictor:从基准到自动选型。 在套件之上再进一步:用机器学习模型为给定电路自动选择设备并混搭各工具的编译 pass。用超过 500 条(2–90 比特)MQT Bench 电路与 7 台设备(两种比特技术)训练/评估,以期望保真度为指标,结果在 14 个基线中 的情形落入前 3,最优异情形超出全部基线组合至多 ;跨技术泛化评估中前 3 命中率 ,最大提升可达 Quetschlich 2025。
参数与量级
| 量 | 典型值 | 来源 |
|---|---|---|
| QASMBench 电路规模 | 小 1–5 / 中 6–15 / 大 15–127 比特 | Li 2023 |
| QASMBench 硬件评估 | 12 台 IBM-Q、25K 次层析评估 | Li 2023 |
| SupermarQ 特征维度 / 应用数 | 6 维特征、8 个应用 | Tomesh 2022 |
| SupermarQ 实例规模 | 3–1000 比特;IBM / IonQ / AQT@LBNL | Tomesh 2022 |
| MQT Bench 线路总量 | 条,2–130 比特,4 层抽象 | Quetschlich 2023 |
| MQT Predictor 选型精度 | 500+ 电路、7 设备, 进前 3(14 基线) | Quetschlich 2025 |
| MQT Predictor 期望保真度增益 | 最高超出基线 (跨技术 进前 3) | Quetschlich 2025 |
SupermarQ 八个基准应用在六维特征空间中的覆盖度凸包示意(图源:Tomesh 2022 Fig. 3)
与其他概念的关系
- 面向中性原子平台本身的应用级评测(QED-C 套件、量子体积、全连通收益)见中性原子基准测试;当套件用于比较编译工具而非硬件时的方法学陷阱见编译器公平评测与可视化。
- MQT Bench 的”目标相关映射级”输出是OLSQ-DPQA、算法相关布局选择、Q-Pilot 飞行 ancilla 编译等映射工具的标准输入形态。
- 套件中电路的各向异性指标(纠缠方差、临界深度)间接决定编译收益大小;中性原子侧的原生资源(全连通、多比特门)如何改变这些指标见FPQA 计算模型与Geyser 原生多比特门编译。
- 设备级全景与”最终用户视角”的性能讨论见中性原子量子计算硬件全景。
- 基准电路跑在真实中性原子逻辑处理器上的结果见逻辑量子处理器。
参考文献
- A. Li, S. Stein, S. Krishnamoorthy, J. Ang, “QASMBench: A Low-Level Quantum Benchmark Suite for NISQ Evaluation and Simulation”, ACM Trans. Quantum Comput. (2023). NA180 · DOI 10.1145/3550488 · arXiv:2005.13018
- T. Tomesh, P. Gokhale, V. Omole, G. S. Ravi, et al., “SupermarQ: A Scalable Quantum Benchmark Suite”, HPCA 2022 (2022). NA178 · DOI 10.1109/HPCA53966.2022.00050 · arXiv:2202.11045
- N. Quetschlich, L. Burgholzer, R. Wille, “MQT Bench: Benchmarking Software and Design Automation Tools for Quantum Computing”, Quantum 7, 1062 (2023). NA179 · DOI 10.22331/q-2023-07-20-1062 · arXiv:2204.13719
- N. Quetschlich, L. Burgholzer, R. Wille, “MQT Predictor: Automatic Device Selection with Device-Specific Circuit Compilation for Quantum Computing”, ACM Trans. Quantum Comput. (2025). NA131 · DOI 10.1145/3673241 · arXiv:2310.06889