多控相位门 是里德堡阵列的”原生指令”,而传统综合只会把它拆成两比特门——Staudacher 等用 ZX 演算反其道而行:从任意电路里”认出”对角片段,直接综合成任意规模的原生多控相位门,这是首个支持任意比特数多控相位门的精确综合算法。
问题背景
现有综合算法几乎都面向”单比特旋转 + 一个纠缠两比特门”的门集(CX、CZ、Mølmer–Sørensen 等):遇到多比特门就按固定模板指数级展开。中性原子硬件打破了这个前提——里德堡阻塞天然支持一次激光脉冲对任意多个原子施加受控相位(见阻塞 CZ 门与多比特阻塞门),多控相位门 与两比特门一样便宜。硬件的寻址模式也特殊:全局光束统一驱动全体原子,单比特寻址靠局部光移/微波,因此综合的天然目标是最小化”全局脉冲次数”而非门数本身 Staudacher 2024。
此前唯一的适配尝试是 Geyser 框架(见Geyser:原生多比特门编译):用数值优化把电路重写到含 CCZ 的门集。但它有两大盲区:只认两比特以上的 CCZ,不认任意相位的受控门,也不支持多于一个控制比特的门。而 HHL、QAOA、算术电路等大量应用本就”长满”受控相位门 Staudacher 2024。
理论模型
对角门的 ZX 图判据
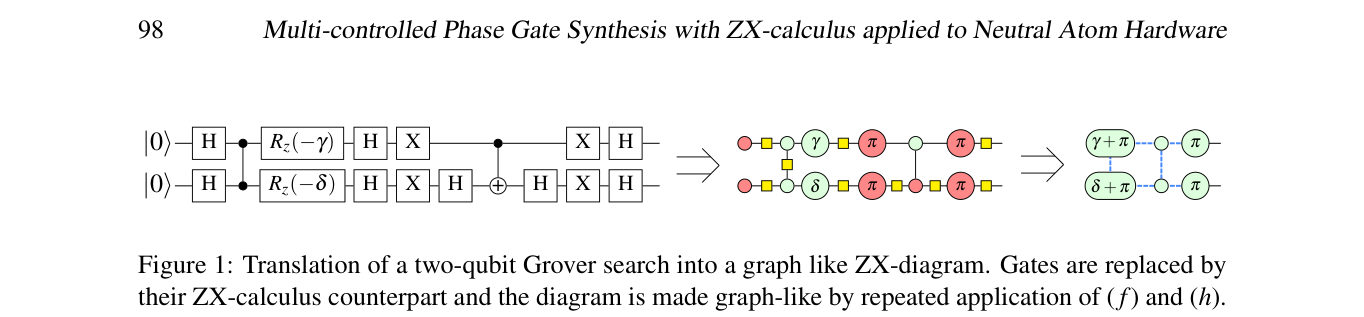
把电路表示为 graph-like ZX 演算图后,关键观察是:对角门在 graph-like 图上有独特的结构签名。受控相位门 是对角的,其非零矩阵元只在 基对角线上,可写成半布尔(semi-Boolean)相位函数 ;在图上它表现为一组共享相位的 Z-蜘蛛及其邻居间的特定连接模式。Staudacher 等证明了该对应关系的图形化命题: 的 ZX 表示与对角门矩阵可以互相导出,从而可以通过图匹配在电路中定位(哪怕原电路从未显式写出)多控相位门 Staudacher 2024。
提取与综合算法
综合流程是把电路转为 graph-like 图后反复执行:
- 识别:在图中搜索对角结构对应的子图,确定可提取的 ;
- 提取:把该子图从图中剥出,记录为原生的 门,剩余图继续化简;
- 可选插入:允许在图中插入额外的相位 gadget,让本不相邻的相位汇聚成更高维的多控门——代价是经典运行时间从 增加( 为比特数, 为 gadget 规模相关参数) Staudacher 2024。
整个方案是精确综合:提取出的门序列与原幺正严格相等(可由 电路等价性验证 的 ZX 技术闭环确认),且支持任意比特数的 。
Toffoli-Hadamard 精确综合
多比特门综合的另一条精确路线来自 Amy–Glaudell–Li–Ross:Toffoli-Hadamard 门集 恰好能表示形如 ( 为整数矩阵)的正交矩阵。借用 Kliuchnikov 2013 年为 Clifford+ 提出的技巧,综合规模从既有的 降到 ;另有针对不超过三比特的替代方法,结论同样覆盖二元分数正交矩阵与 门变体 Amy 2023。这类精确综合为多比特门”该用几个、怎么用”提供了参照下界。
方法与实现
面向中性原子原生门集的端到端流程 Staudacher 2024:
- 原生门集:—— 为任意控制的里德堡相位门, 为可单独寻址的 旋转, 为作用于全体比特的全局 旋转(全局里德堡/微波照明,耗时约 100 µs);
- 多比特门综合:用上述 ZX 提取算法把电路改写为 + 单比特旋转;
- 单比特层调度:任意的同时单比特门序列可分解为两次全局 照明夹单比特 (横向分解),未用到的比特上互补旋转相消为恒等;
- 优化目标:最小化最慢的全局 门个数——它直接乘 100 µs 的脉冲时间。
在 QASM-Bench、MQT-Bench、Feynman 三套基准上对比五种方案(Qiskit-default、No-decomp、ZX-default、ZX-no-insert、ZX-with-insert):ZX-with-insert 相对 Qiskit 内部综合平均缩短执行时间 26%(QASM-Bench,35 条改善 23 条)、26%(MQT-Bench,11 条改善 7 条)、40%(Feynman,26 条改善 24 条);对已含近最优多控门的算术电路,简单替换的 No-decomp 反而最优(Feynman 上平均省 63%)——ZX 方法在该情形会引入门与时间开销 Staudacher 2024。
评测的执行时间按各方案综合产物在目标门集上的脉冲时间 计,综合算法自身的经典运行时间 在消费级笔记本上测得,与 Qiskit 内部综合大体相当;With-insert 变体在 qcla_adder、gf2^t_mult 等算例上经典运行时间显著增长。结果同时表明,With-insert 常能”无中生有”地合成出比原电路更高控制维度的 门(如 qnn_10 神经网络电路与 HHL 类天然含受控相位的电路),从而减少慢速全局 脉冲;但也有例外(如 hhl_n7),全局脉冲更少却因单脉冲时间变长而总时间更差 Staudacher 2024。
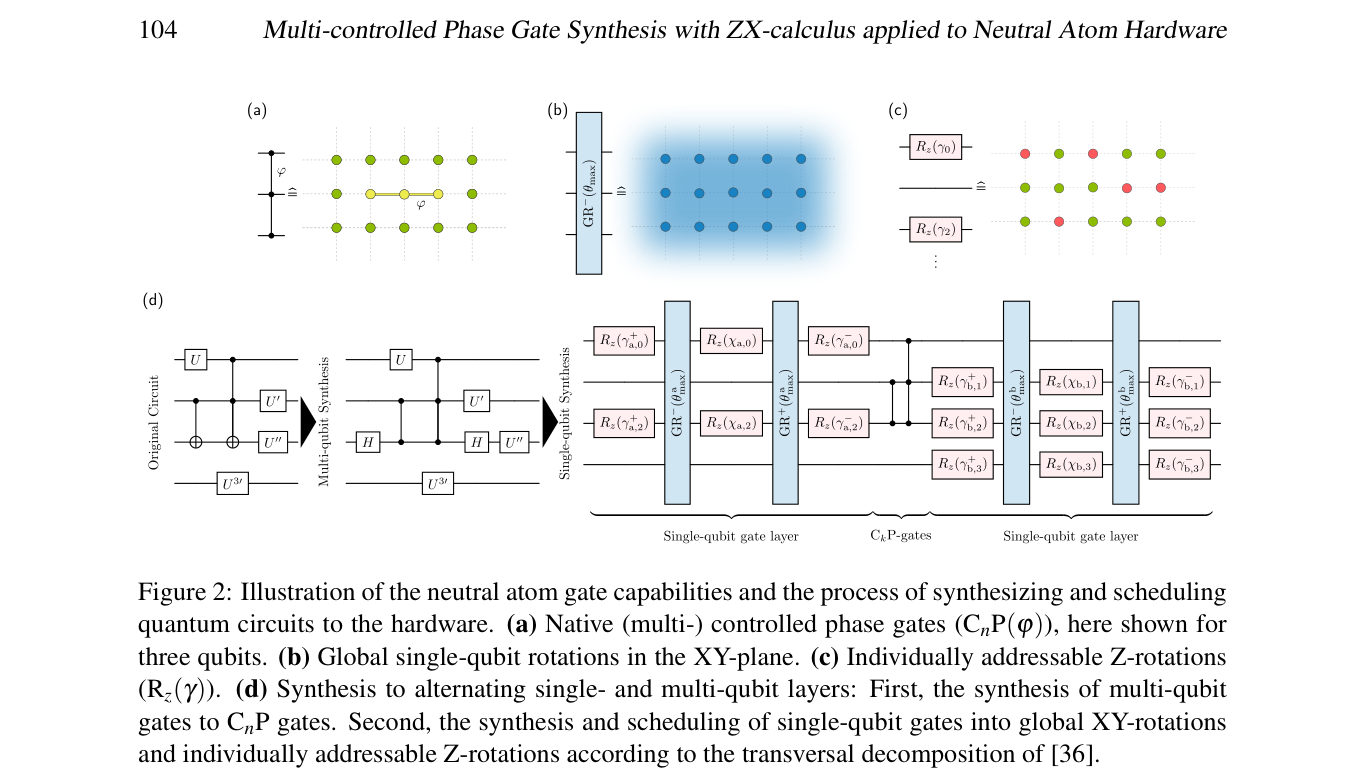
_中性原子门能力与综合调度流程:CnP 门、全局 GR 旋转、Rz 与两步综合示意(图源:Staudacher 2024
Fig. 2)_
三套基准上五种综合方案的执行时间对比表(图源:Staudacher 2024 Fig. 1)
适用边界
该方法的收益与电路的”对角含量”正相关:
- 高收益:QAOA、HHL、含比较器/加法器的算术电路等天然富含受控相位,With-insert 还常合成出比原电路更高控制维度的门(如 qnn_10);
- 低收益甚至负收益:已被手工写成近最优多控门形式的电路(Feynman 基准的典型情形)会被提取过程拆散重建,带来门与时间开销——此时逐门替换(No-decomp)才是正解;
- 代价弹性:允许插入相位 gadget 的变体换来更高维的多控门,但经典综合时间显著增长(qcla_adder、gf2^t_mult 等算例)。
这与任何结构识别类综合的共性一致:识别到的结构要真存在,才有免费的午餐 Staudacher 2024。
对中性原子平台的意义
这项工作把”线路综合”与”硬件原生能力”第一次系统对齐:综合产物中隐含的对角/受控相位结构(见对角线路综合与相位 Gadget 与浅深综合)不再被两比特分解摧毁,而是被抬升为原生门。对FPQA 计算模型与能力边界而言,这意味着编译器的中间表示需要携带多比特门信息;综合步骤与分区架构的调度、原子搬运与相干输运等映射任务是正交的两级流水线。
参数与量级
| 量 | 数值 | 来源 |
|---|---|---|
| 全局 门耗时 | (全局照明) | Staudacher 2024 |
| QASM-Bench 执行时间 | 平均 (35 条改善 23 条,ZX-with-insert vs Qiskit) | Staudacher 2024 |
| MQT-Bench 执行时间 | 平均 (11 条改善 7 条) | Staudacher 2024 |
| Feynman 执行时间 | (24/26);No-decomp 达 | Staudacher 2024 |
| 全局脉冲削减 | With-insert 显著减少慢速全局 门个数 | Staudacher 2024 |
| 提取算法运行时间 | (无插入变体) | Staudacher 2024 |
| 综合能力 | 首个支持任意规模多控相位门的精确综合 | Staudacher 2024 |
| Toffoli-Hadamard 精确综合 | Amy 2023 |
与其他概念的关系
- ZX 演算与PyZX 与图论化简:识别与提取算法的图形语言;对角结构的图签名是核心。
- 相位 Gadget 与浅深综合与对角线路综合: 恰是相位 gadget/Walsh 项的原生实现,综合即结构识别。
- Geyser:原生多比特门编译:先行的 NA 多比特门综合(数值优化 + CCZ),本文方法在其盲区(任意相位、多控制)上扩展。
- 阻塞 CZ 门、多比特阻塞门与奇偶相位门与原生多体门: 的物理实现层。
- Toffoli/CCZ 门: 特例的原生时间最优方案。
- 电路等价性验证:精确综合正确性的验证手段(同一 ZX 框架)。
- ZX 图的深度强化学习优化:同一图形表示上的另一条自动化化简路线。
- Quartz 超优化:门级等价替换搜索,可与对角提取级联。
- 编译器公平评测与可视化:多方案综合质量对比的评测框架参照。
- T 计数与非 Clifford 约简:离散门集上的对应问题;在 NA 上”贵门”换成了全局里德堡脉冲。
- FPQA 计算模型与能力边界:多比特原生门能力的形式化模型。
参考文献
- K. Staudacher, L. Schmid, J. Zeiher, R. Wille, D. Kranzlmüller, “Multi-controlled Phase Gate Synthesis with ZX-calculus applied to Neutral Atom Hardware”, Electron. Proc. Theor. Comput. Sci. 406 (2024). NA122 · DOI 10.4204/EPTCS.406.5
- M. Amy, A. N. Glaudell, S. M. Li, N. J. Ross, “Improved Synthesis of Toffoli-Hadamard Circuits”, Reversible Computation (LNCS) (2023). NA120 · DOI 10.1007/978-3-031-38100-3_12