问题背景
容错量子计算需要一套逻辑门实现方案。对仅有局域连接的拓扑码,标准答案是格手术(lattice surgery):它可行,但需要额外的 ancilla 补丁,且一次逻辑操作耗时随码距 以 增长 Chen 2026。相比之下,横向门是”零时间开销理想方案”:逻辑算符由逐比特独立、不跨比特传播错误的操作实现,容错性自动成立。
但 Eastin–Knill 定理禁止任何量子码拥有通用的横向门集——横向门永远只是完整门集的真子集。对最流行的旋转表面码(rotated surface code,电路级噪声阈值约 ;最近的超导实验首次明确演示了低于阈值的表面码存储器, 逻辑比特保存信息的时间超过物理比特的两倍)而言,Clifford 生成集 中三扇门的横向化难度截然不同 Chen 2026:
- 横向 CNOT 需要长程连接:在两个对齐的码补丁之间逐列连接对应数据比特即可。借助(有效)长程连接,中性原子阵列已在 上演示了横向逻辑 CNOT Chen 2026。由于 生成整个 Clifford 群,只要再补齐 H 与 S,全部逻辑 Clifford 门都可以避免格手术;
- 横向 H 数学上存在(对所有数据比特作用 H),但会把 X、Z 稳定子整体互换,等价于要把补丁旋转 ——中性原子阵列现行的 2D 声光偏转器(2D-AOD)只擅长平移矩形网格,不天然支持补丁旋转;
- 横向 S 在旋转表面码上此前完全没有已知方案(尽管改进局域连接下 S 门效率的工作层出不穷)。未旋转表面码虽 admits 全部横向 Clifford 门(折叠表面码方案),但同样码距下需要几乎两倍的码比特 Chen 2026。
Chen 等人的方案 Chen 2026 用”硬件协同设计”同时解决 H 与 S:H 靠双 AOD 反射完成补丁旋转,S 靠把折叠横向操作嵌入 SE 轮的时间动力学中。
理论模型
旋转表面码的码参数为 (数据比特排成 网格),稳定子是相邻 plaquette 上的权重 4 的 X 型与 Z 型算符。
横向门的容错性来自其结构:若逻辑幺正 把码空间映射到自身,则单比特故障最多以权重 1 的形式穿过门层,不会放大成高权重数据错误。因此横向门的”电路级深度”为 1,与 无关——这正是它相对 时间开销的格手术的本质优势。
横向 H 与补丁旋转。 对所有数据比特施加 H 后,逻辑 H 实现,但每个 X 稳定子变为 Z 稳定子、反之亦然。要恢复标准稳定子布局,需将补丁旋转 。关键观察: 旋转 = 两次反射的复合,
而每次反射恰好可以通过一个”按特定方向对齐的 2D-AOD”用分治算法高效执行 Chen 2026——无需逐比特搬运。硬件上这是”顺势而为”的设计:水平对齐的 2D-AOD 正是现行实验中用于选择、寻址与移动矩形码补丁的工具( 横向 CNOT 实验即靠它);真正新增的只是一组对角对齐的 AOD。
SE 电路的对角结构。 标准 SE 电路含 4 层 CNOT;由于布局紧凑,X 型与 Z 型稳定子测量的 CNOT 顺序不同。把负责 X(Z)稳定子的 ancilla 记为 X(Z)ancilla,则在给定比特排布下 X 与 Z ancilla 天然生活在不同的对角线上。于是对角对齐的 AOD 可以同时寻址全部 X(或 Z)ancilla 而不扰动其他比特——一组原本为旋转而引入的硬件,反过来又加速了 SE 本身 Chen 2026。
折叠横向 S 门与形变效应。 对未旋转表面码,Moussa(2016)与 Breuckmann–Burton(2024)给出折叠横向 S 门:对补丁做特定镜像分解的 S 门集合,实现逻辑 。对旋转码此操作无法直接套用。突破口是 SE 电路的形变效应(morphing effect,源自 McEwen–Bacon–Gidney 对表面码电路时间动力学的观察):一轮 SE 中,ancilla 重置后执行前两层 CNOT 时,数据 + ancilla 全体恰好演化成未旋转表面码态(“半周期态”,half-cycle state),边界附带少量自由比特;后两层 CNOT 与 ancilla 测量再把它形变回旋转码态(“末周期态”)。因此在一轮 SE 的中点对半周期态执行一次折叠横向 S 门,就实现了逻辑 S,同时该轮 SE 照常产出综合征结果 Chen 2026。
为什么 S 门最难:CSS 码的横向 CNOT 只要求两个同构补丁逐比特配对;横向 H 只要求把补丁转正(几何操作);而 是四阶相位门,其横向实现必须借道码的”折叠/镜像”对称性——旋转码的镜像对称与稳定子布局耦合,导致折叠横向操作落在半周期态这个”中间码形”上才自洽。这也是此前一系列工作只能在局域连接约束下反复优化 S 门(如借助 Y 基、扭曲码等)却无法横向化的原因 Chen 2026。
探测器构造的新麻烦:传统横向门发生在两轮 SE 之间,探测器可以从相邻轮的稳定子时间序列直接继承;而嵌入轮内的折叠操作会把部分 X 稳定子诱导成带符号的新稳定子,并产生需要 与 联合测量的”旗标稳定子”,边界附近还需额外的 X/Z 测量位置 Chen 2026。
方法与实现
以一轮 SE(记为轮 ,称为 S-SE 轮)为载体的 S 门协议 Chen 2026:
- 轮初重置 ancilla,按标准 SE 电路执行第 1–2 层 CNOT,得到半周期态;
- 在半周期态上执行折叠横向 S 门(数据比特的镜像 S 门集合);
- 执行第 3–4 层 CNOT 与 ancilla 测量,态形变回旋转码态,该轮综合征同时被读出。
与传统”两轮 SE 之间插横向门”不同,横向操作发生在单轮 SE 的内部——门与该轮纠错”合二为一”,这正是协议几乎不付额外逻辑轮次代价的原因;相应地, syndrome 提取结果的语义与标准轮不同,解码器必须为 S-SE 轮重新构造探测器网络 Chen 2026。
解码是主要难点:门操作使错误以非常规方式穿过横向层,Z 综合征容易被错误地连到时间边界而造成解码错误。解码策略为先解 Z 探测器、再解 X 探测器的两步法,并配合两项改进:(1) 枚举四种虚拟时间边界(VTB)条件、取总权重最小的解码结果;(2) 把 Z 解码结果用于重加权 X 解码图——按重加权时机分为推迟重加权(PR)与完全重加权(FR)两种 Chen 2026。解码策略失效的模式具有明确结构:纯按 Z 综合征最小权重解出的图未必是 X、Z 联合意义下的最小权重解释,PR/FR 恰是把这一相关性回灌进解码。
数值实验用 Stim 构造探测器错误模型、PyMatching 匹配解码、Sinter 统计(见Stim 稳定子模拟),对 到 、电路错误率 与 采样;每个数据点用最大似然估计给出逻辑错误率及其可信区间(似然比因子 1000 以内的假设均计入阴影区) Chen 2026。
基准电路:X 存储器电路(X 基初始化 + 约 轮 I-SE + X 基测量)作对照;S-2 电路在 I-SE 轮之间插入两个 S-SE 轮——X 基初始化与第一个 S-SE 轮之间、第二个 S-SE 轮与 X 基测量之间各垫 轮 I-SE,两个 S-SE 轮之间隔 轮(取 或 2),边界处 。当取 时 S-2 电路长度约为对应 X 存储器的一半;仿真显示配合 VTB-FR 解码,S 门协议的逻辑错误率被压回与(更长的)存储器基线持平的水平 Chen 2026。
与既有方案的取舍:把整 Clifford 集横向化还有一条”现成”路线——改用未旋转(折叠)表面码,三类门一步到位,但同码距下码比特数近乎翻倍;本方案保留旋转码的紧凑性,把额外代价转移为一次 AOD 反射(H)与一轮 SE 内部的折叠操作(S),都属于”用重构自由度换码面积”的典型交易 Chen 2026。与格手术相比,横向 S 门甚至不消耗额外的逻辑轮次——它寄生在本来就要执行的 SE 轮里。
展望:把形变-横向思路推广到 qLDPC 码——在 SE 半途把数据/ancilla 形变为具有不同横向门集的码(如超图乘积码与 BB 码),扩大高码率码可用的逻辑门集;并把横向 CNOT 与 S 门解码器组合,实现旋转表面码上更一般 Clifford 线路的快速逻辑处理 Chen 2026。全部数值实验的码与电路已开源,采样-解码-统计流水线可复用 Chen 2026。
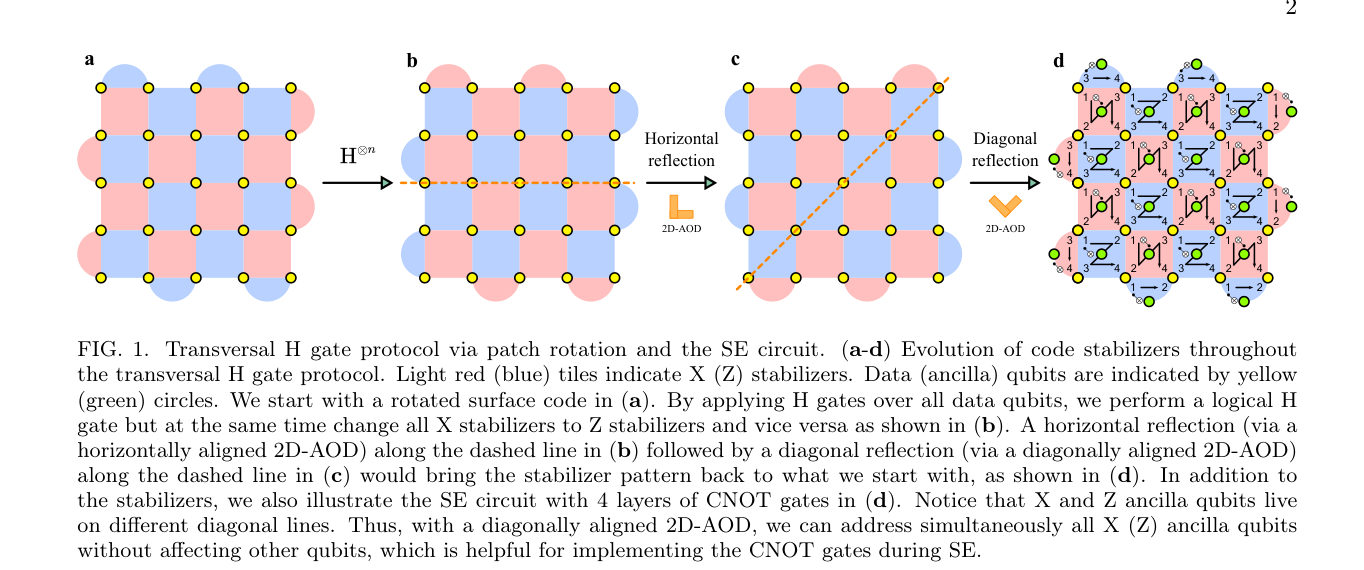
横向 H 门协议中稳定子构型随水平反射、对角反射的演化,以及带 4 层 CNOT 的 SE 电路(图源:Chen 2026 Fig. 1)
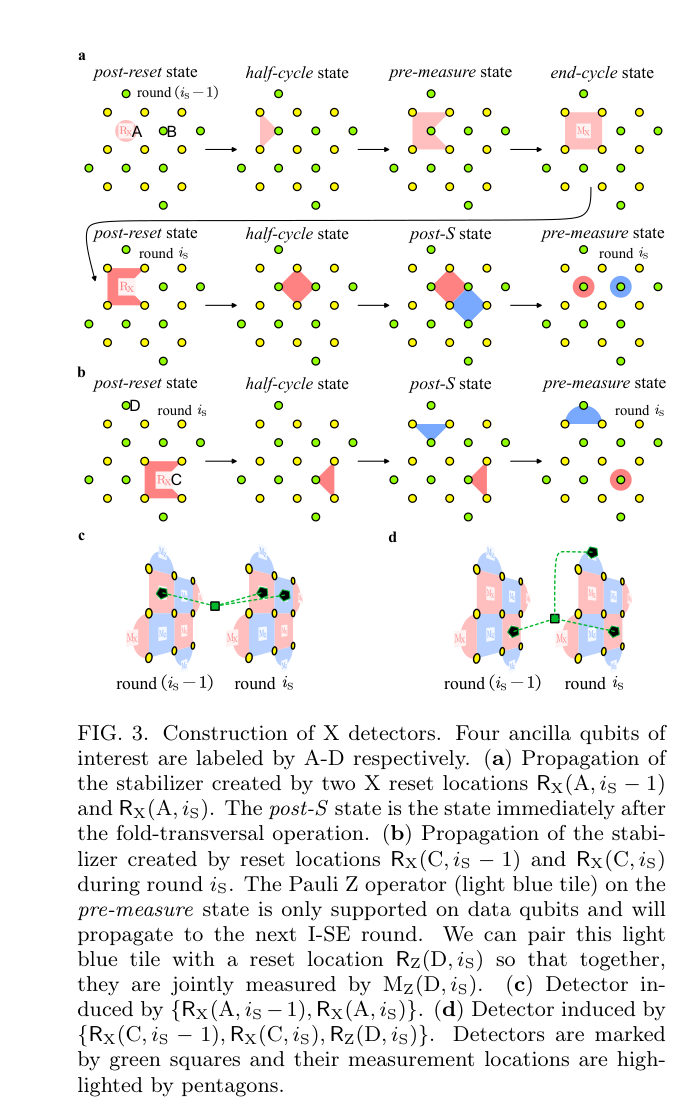
半周期态上的折叠横向 S 门操作、稳定子传播与探测器构造(图源:Chen 2026 Fig. 3)
参数与量级
| 量 | 典型值 | 来源 |
|---|---|---|
| 旋转表面码电路级阈值 | Chen 2026 | |
| 格手术逻辑操作时间 | (另需 ancilla 补丁) | Chen 2026 |
| 已演示横向逻辑 CNOT | (可重构原子阵列) | Chen 2026 |
| S-2 电路 SE 轮数 | (约为 X 存储器电路一半) | Chen 2026 |
| 仿真码距范围 | , | Chen 2026 |
| S 门协议逻辑错误率 | VTB-FR 解码后与量子存储器持平 | Chen 2026 |
| 未旋转码横向 Clifford 代价 | 同码距需近 2 倍码比特 | Chen 2026 |
| 解码流水线 | Stim + PyMatching + Sinter(VTB-PR/FR 改进) | Chen 2026 |
与其他概念的关系
- 横向逻辑 CNOT 的 演示由逻辑量子处理器实验完成;本词条把同一平台上的 H 与 S 补齐,形成完整的横向逻辑 Clifford 集。与 48 逻辑比特处理器所用的”移动比特就位 + 横向 CNOT”模式相比,本方案进一步把 H、S 也从格手术的 时间表中解放出来。
- 解码流程建立在Stim 稳定子模拟与探测器错误模型之上;横向门引入的相关错误也给Sparse Blossom 最小权匹配等匹配译码器带来非常规的图结构。
- SE 轮内的形变态与中电路测量能力配合,才能在门操作同一轮内完成综合征读出。
- 形变-横向门集的扩张指向qLDPC 码架构与常数开销容错中的高码率码;通用计算仍需非 Clifford 门,可结合里德堡硬件高效容错的码族选择与魔法态方案。
- 用原生多比特门压缩 SE 深度是另一条互补路线,见三比特门容错稳定子测量。
- 双 AOD 反射式补丁旋转是FPQA 计算模型中”移动/重构即编译原语”的具体体现,其调度问题与分区架构同源。
参考文献
- Z.-H. Chen, M.-C. Chen, C.-Y. Lu, J.-W. Pan, “Transversal Logical Clifford Gates on the Rotated Surface Code with Reconfigurable Neutral Atom Arrays”, Phys. Rev. Lett. (2026). NA175 · arXiv:2412.01391
- D. Bluvstein, S. J. Evered, A. A. Geim, et al., “Logical quantum processor based on reconfigurable atom arrays”, Nature (2023). (NA175 引文 [7]: 横向逻辑 CNOT 演示的原始实验,经由 NA175 叙述核实)
- J. E. Moussa, “Transversal Clifford gates on folded surface codes”, Phys. Rev. A 94, 042316 (2016). (NA175 引文 [19])
- N. P. Breuckmann, S. Burton, “Fold-Transversal Clifford Gates for Quantum Codes”, Quantum 8, 1372 (2024). (NA175 引文 [20])
- M. McEwen, D. Bacon, C. Gidney, “Relaxing Hardware Requirements for Surface Code Circuits using Time-dynamics”, Quantum 7, 1172 (2023). (NA175 引文 [23]:SE 形变效应)