问题背景
最小权完美匹配(minimum-weight perfect matching, MWPM)译码器是表面码等一类码族中应用最广的译码器:把错误模型分解为 X 型与 Z 型 Pauli 错误后,译码问题变成图上的匹配问题,可用 Edmonds 花算法精确求解 Higgott 2025。但 MWPM 的朴素实现有两个瓶颈:最坏情形复杂度为 ( 为图节点数),且主流实现需要对每个症状节点做全对全(all-to-all)Dijkstra 最短路预计算——在探测器图上这是一笔巨大的常数开销。后果是:已有的匹配译码软件远慢于稳定子线路模拟器(见Stim 稳定子模拟与探测器错误模型),成为表面码数值研究的瓶颈;研究者因此更常去估计阈值(需要的射击数少)而非更实用的资源开销估计 Higgott 2025。
实时译码的要求更苛刻:译码器必须以症状数据产生的速率消费症状流,否则积压随 门深度指数增长。超导处理器的症状数据生成速率是每轮症状提取亚微秒量级——这就是”每核每秒百万错误”这一指标的由来 Higgott 2025。
理论模型:从噪声模型到匹配问题
图状错误模型。 设 DEM(见Stim 稳定子模拟与探测器错误模型)给出检测矩阵 ( 个探测器、 个错误机制)、逻辑观测量矩阵 与先验概率向量 。一次错误实现是向量 ,观测到的症状为 (症状中为 1 的探测器称缺陷/defect) Higgott 2025。
先验概率的权重化。 独立错误机制的先验为
取对数后,最大化 等价于最小化
即”最可能的错误解释”就是探测器图上连接各缺陷的最小总权重边集 Higgott 2025。
嵌入匹配(MWEM)。 严格地说,译码问题不是传统图 上的最小权完美匹配,而是其变体——最小权嵌入匹配(minimum weight embedded matching):给定探测事件集合 ,求边集 使 中每个顶点与 中奇数条边关联、 中每个顶点与偶数条边关联,且总权重最小;无边界半边时它就是组合优化中的最小权 T-join 问题。传统 MWPM 的三步归约(Dijkstra 建”路径图” → 花算法求匹配 → 回溯路径)在探测事件数 上有平方级的枚举开销——这正是逐缺陷做 all-to-all Dijkstra 的代价来源 Higgott 2025。
输出与成功判据。 译码器无需输出完整的物理纠正边集:它只需输出对逻辑观测量翻转的预测 ,并要求 (即在逻辑层面施加纠正,与物理层面等价)。这一输出极其稀疏——表面码存储实验中预测只是一个比特:逻辑 X(或 Z)可观测量是否被翻转 Higgott 2025。
为什么期望运行时间可以做到接近线性。 图状噪声模型下,探测事件的位置分布并非均匀:错误按独立采样边生成,缺陷是采样边集中奇度顶点。低错误率下,相距很远的缺陷对呈指数压低——而花算法的生长步数由”相邻缺陷的短边”主导,因此期望运行时间可以做到对探测事件数 接近线性,这为实时译码提供了算法层面的可行性 Higgott 2025。
复杂度参照。 主要译码路线的定性对比 Higgott 2025:
| 译码器 | 复杂度/策略 | 与 MWPM 的关系 |
|---|---|---|
| 朴素 MWPM | 最坏 + all-to-all Dijkstra | 精确解 |
| Fowler 系列改进 | 预设探索半径、逐步扩大 | 同精度,运行时间大幅改善 |
| Sparse Blossom(PyMatching 2) | 探测器图上均匀生长 + 全局优先队列 | 同精度,单核最快 |
| fusion blossom | 类 union-find 簇生长,支持算法级并行 | 同精度,并行更快 |
| Union-Find | 几乎线性最坏时间 | 近似,精度略低 |
| 最大似然译码 | 组合复杂度,不可实时 | 精度更高 |
相关匹配(correlated MWPM)、belief matching 与神经网络译码器也可在高噪声下取得高于标准 MWPM 的精度 Higgott 2025。
方法与实现
算法结构。 花算法的骨架来自 Edmonds 的两个定理:Berge 定理(匹配最大当且仅当不存在增广路径)与增广路径的花收缩处理。算法从平凡匹配出发,反复”构造交错树(alternating tree)→ 找增广路径 → 沿路径翻转匹配/非匹配边”,直至无增广路径;奇圈(blossom)结构保证奇圈也能被正确处理。经典实现对每个根节点做 Dijkstra 找最短增广路径,是全对全开销的来源 Higgott 2025。Sparse Blossom 与 Fowler 系列工作一脉相承,直接在探测器图上求解嵌入匹配问题,从而避免 all-to-all Dijkstra。其核心机制是:从各缺陷出发的探索区域(exploratory region)以与边权重成比例的代价均匀生长,由一个全局优先队列管理生长事件;区域相遇时通过合并与对偶变量调整保持匹配的最优性证书。与同期的 fusion blossom 相比,二者都在探测器图上求解,但 fusion blossom 用类似 union-find 的簇生长方式并支持算法自身的并行化;sparse blossom 的单核性能更快,且按射击分批即天然可并行 Higgott 2025。
数据结构与流式译码。 实现采用邻接式压缩稀疏行布局存探测器图,支持”流式”输入症状数据(而非整批),为多核实时译码铺路;与 Stim 的 DEM 输出直接对接。作者估计,配合多核并行与流式支持,实时译码超导规模处理器是可行的 Higgott 2025。
把整条译码管线排开,Sparse Blossom 位于第四环:
- 线路构造与噪声注入(Stim,见Stim 稳定子模拟与探测器错误模型);
- 批量采样探测事件(Stim
--detect); - 从线路导出 DEM:检测矩阵 、观测量矩阵 、先验 ;
- 由 DEM 建探测器图并做最小权嵌入匹配(PyMatching 2);
- 输出逻辑翻转预测,统计逻辑错误率。
开源实现。 Sparse Blossom 以 PyMatching 2 发布(pip install pymatching)。组合 Stim + PyMatching 2 后,过去在高性能集群上要跑数小时的纠错模拟可在笔记本上数分钟完成 Higgott 2025。
与并行化方案的关系。 实时译码中,靠”并行处理多批射击”并不够——单个计算实例内的症状流若不能被及时消费,积压会随 门深度指数增长;退而求其次的并行窗口译码则带来多项式 slowdown。因此作者指出,未来方向是把 sparse blossom 与 fusion blossom 的”译码算法自身并行化”技术结合:前者单核最快,后者支持并行执行单个译码实例 Higgott 2025。
参数与量级
| 量 | 典型值 | 来源 |
|---|---|---|
| 距离 17 表面码、0.1% 线路级去极化噪声 | X+Z 两基合计 每轮症状提取(单核),即每核每秒 次译码 | Higgott 2025 |
| 距离 29、同一噪声模型 | 每轮每核(足以达到 逻辑错误率) | Higgott 2025 |
| 朴素 MWPM 最坏复杂度 | Higgott 2025 | |
| 边权重定义 | Higgott 2025 | |
| Union-Find 译码 | 几乎线性最坏时间(精度为 MWPM 的近似) | Higgott 2025 |
| Stim+PyMatching 2 组合收益 | 笔记本数分钟 ≈ 此前集群数小时的模拟 | Higgott 2025 |
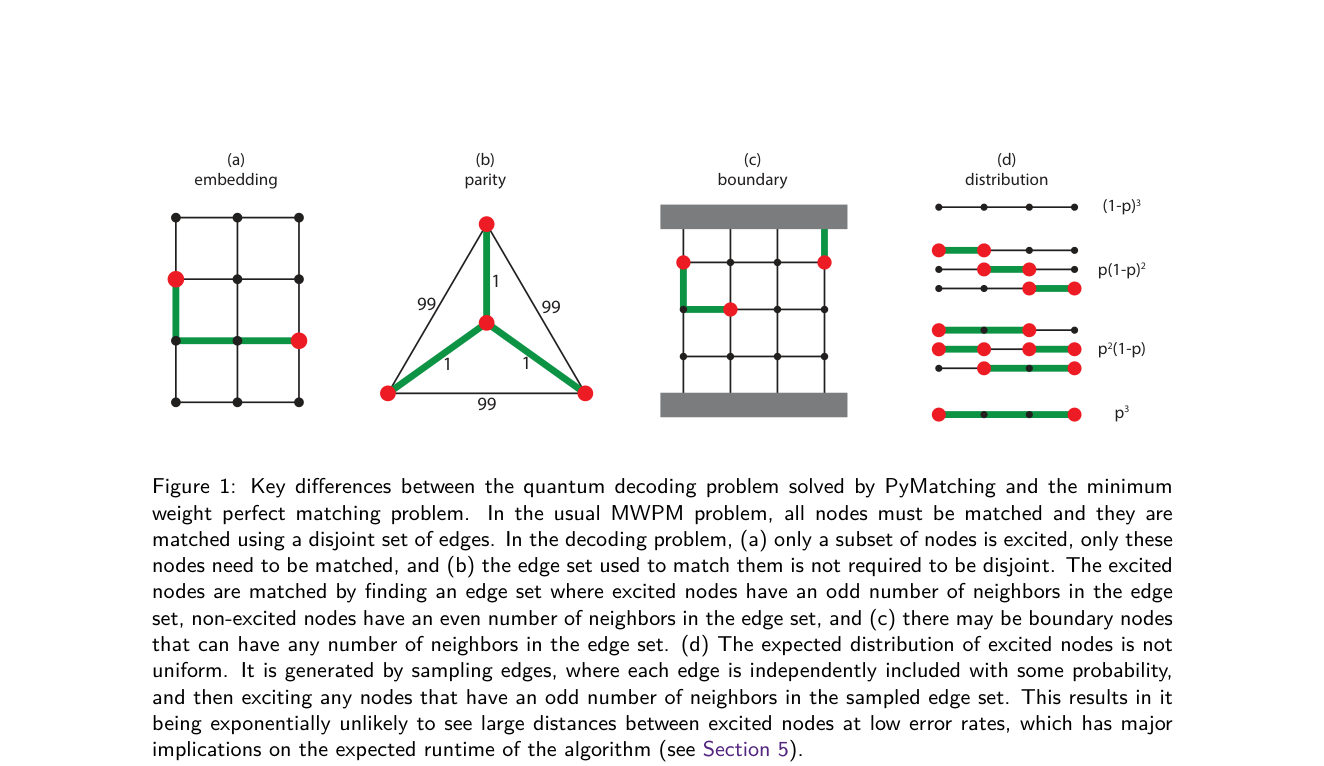
Sparse Blossom 探索区域在探测器图上生长与合并示意:缺陷出发的 region、全局优先队列与 blossom 结构(图源:Higgott 2025 Fig. 1)
与其他概念的关系
- 输入侧:探测器图与先验权重来自 Stim 的探测器错误模型,见Stim 稳定子模拟与探测器错误模型;二者组合构成纠错数值模拟的标准工具链。
- 译码精度依赖噪声模型本身:擦除转换把去相干错误转成已知位置的擦除错误后,匹配图的边结构显著简化、阈值显著提高。
- 该译码器是评估常数开销容错与qLDPC 码架构资源开销的工具链一环;qLDPC 码的图状译码(或到匹配问题的归约)仍是活跃研究方向。
- 实时译码要求症状提取电路的测量调度与时序可控,与中电路测量与非破坏读出和三比特门容错稳定子测量的硬件实现直接相关。
- 在中性原子硬件上以表面码译码跑通逻辑线路的演示见逻辑量子处理器与横向逻辑 Clifford 门。
参考文献
- O. Higgott, C. Gidney, “Sparse Blossom: correcting a million errors per core second with minimum-weight matching”, Quantum 9, 1600 (2025). NA184 · DOI 10.22331/q-2025-01-20-1600 · arXiv:2303.15933