表面码每加一个逻辑比特要多付出 个物理比特,而高码率 qLDPC 码把 的密集编码与常数开销容错(Gottesman 构想)连在一起;可重构原子阵列用”分治式原子重排”实现 qLDPC 的非局域检查,使综合征提取电路的空间开销在实际相关尺度上等效于常数,数百物理比特起即超越表面码。
问题背景
平面表面码每个码块只编码 个逻辑比特,编码速率按 消退;运行有实用价值的算法常被估计需要百万量级物理比特 Xu 2024。Gottesman 指出:若换用渐近常码率的量子低密度奇偶校验(qLDPC)码,配合恰当的逻辑门构造,容错量子计算的空间开销可以降为 ——每保护一个逻辑比特只花常数个物理比特 Xu 2024。此后若干实用门构造被相继提出,但都缺少电路级(circuit-level)容错证明与性能分析,“低开销在真实噪声线路中能否保持”悬而未决 Xu 2024。
qLDPC 码的物理难点在于非局域连接:稳定子把空间上相距很远的比特绑进同一个检查。超导平台所需的多层长程连接远超近期与中期硬件能力 Xu 2024。另一条纯平面路线(薄平面码)虽能压低空间开销,却仍带可观的时间开销——低编码率的 ancilla 与计算补丁把逻辑并行度限制在 Xu 2024。可重构原子阵列提供第三条路:光镊 + AOD 相干搬运整片原子网格,“重排即连线”。Xu 等人的架构 Xu 2024 给出了完整的电路级验证:存储、计算与传送三种角色分工协作,高阈值与低开销在门操作中保持不变。
这一路线的意义可以用一句话概括:把”非局域连接”从空间问题变成时间问题。固定架构必须用物理布线(或反复 SWAP)满足 qLDPC 的检查图;重排架构则让每个检查在其轮次到来时”临时连线”,用可并行搬运的时间片换取空间布线的不存在。剩下的问题只有两个——重排要多快、纠错要多强,而两者在该架构中都找到了肯定答案。
理论模型
架构由三块组成 Xu 2024:
- qLDPC 存储块:超图乘积(HGP)码或准循环提升乘积(LP)码 ,、,即 ——编码速率 是”常数开销”的来源;
- 处理器: 个表面码/彩色码型计算比特 ,码距 由深度 的目标失败率决定;
- 介导 ancilla:码参数 ,通过 ancilla 辅助格手术在存储块与处理器之间隐形传态。
整个电路的逻辑失败率(LFR,定义为每个码周期 个逻辑比特中任意一个失败的概率)随码距指数衰减。每步传送 个逻辑比特,则比特开销由存储块主导、仍为常数。有限尺寸下没有渐近阈值(见下),但物理相关尺度内常数开销容错与亚阈值行为依然成立 Xu 2024。
码构造与阈值。HGP 码取自具有良好扩张性质的经典随机二部图;LP 码以商多项式环上的 基矩阵构造,提升尺寸增大、矩阵元优化后尺寸至 1428,码率下界 ,且同尺寸下比 HGP 保持更高码率与更大距离。不含空转误差的电路级去极化模型下,HGP/LP 阈值分别约为 与 Xu 2024。
架构角色的分工逻辑:存储要密(码率优先),计算要灵活(阈值与门集优先),于是把两者解耦——表面码/彩色码补丁承担逻辑门,qLDPC 块承担存储,介导 ancilla 承担异码块之间的联合测量。每个逻辑线路步可对存储块中 个逻辑比特并行施门, 的选取直接决定计算部分的开销是否被存储块”淹没” Xu 2024。
子阈值标度拟合(含空转误差重缩放)给出 Xu 2024:
而表面码对照为 。LP 的失败率对 的指数 显著优于 HGP 的 ,故小尺寸下 LP 更省。空转误差来自重排期间比特空转,按 (HGP)/ (LP)增长,可等效为门错误重缩放 ;在当前实验参数与实际相关码尺寸下 ,影响可忽略 Xu 2024。
方法与实现
乘积结构与 AOD 的同构。HGP/LP 码由两个经典 LDPC 码的乘积构造,Tanner 图天然分解为”行 × 列”;交叉 AOD 恰以两条控制波形并行搬动整行/整列原子。把经典码的检查与比特排到一条线上、使每层纠缠门只连相邻对,再用分治重排(递归对半分,深度 , 为阵列边长)实现任意行/列置换,即可按”行重排 → CZ → 列重排 → CZ”完成一轮综合征提取 Xu 2024。
- 综合征电路用与码乘积结构兼容的”乘积着色电路”(product coloration circuit),每个稳定子生成元配一个 ancilla,HGP/LP 码的纠缠门深度分别为 16 与 20 层 Xu 2024;
- 一万个比特的 HGP 码每层重排约 3 ms,远小于原子阵列已演示的 相干时间;底层为扩张图(expander)的经典码给出单发(single-shot)性质——一轮综合征提取即容错 Xu 2024;
- 解码采用跨 3 个码周期联合解码的时空 BP+OSD 电路级译码器:变节点对应电路故障、检查节点对应综合征奇偶,比逐周期独立解码的阈值更高,也是逻辑操作仿真中跨周期容错的关键 Xu 2024;
- 逻辑操作用 ancilla 辅助格手术:存储块与处理器逻辑算符的超图乘积构成介导码块,经合并–分裂联合测量传送逻辑信息;每步可对 个不同列坐标的逻辑比特并行传送。与既有算法容错方案相比介导补丁尺寸减半,需 轮综合征提取保证对数据错误的容错 Xu 2024。
空转误差的处理是这套架构诚意的体现:QEC 周期的时钟不仅包含 SE 门,还包含重排、检查比特重置与读出。重排引起的空转错误随码尺寸缓慢增长(),通过乘积着色电路的结构化 rescaling 并入门错误 后纳入阈值分析;读出与重置的绝对时长则属于平台工程(见中电路测量与非破坏读出) Xu 2024。
传送电路的电路级验证:以”表面码补丁 → HGP 补丁”隐形传态为样例,聚焦合并/分裂操作中 XX 测量的错误,观测到与存储器一致的 LFR 与阈值交叉行为;单个逻辑比特的失败率远低于整个码块,即便最小的 码在 下也远低于盈亏平衡点——高阈值与低开销在”计算层”同样保持 Xu 2024。
规模外推:用拟合公式对 HGP 码做大尺度外推,在 1000 逻辑比特、 物理比特的尺度上仍保持对表面码超过一个数量级的比特节省;LP 码在 80/180 逻辑比特处分别只需 1367/2670 个物理比特() Xu 2024。
值得注意的是,即使在码块层面分析所用的最保守假设下,25 逻辑比特这个最小的仿真规模也已经越过”超越表面码”的门槛——低开销优势不是远景,而是几百比特量级的现实选项 Xu 2024。
时间开销的坦白账:处理器侧表面/彩色码补丁仍带 类时间开销,逻辑并行度受限;作者预期编译改进可缓解 Xu 2024。对超大码(空转误差不可忽略时),可与另一码串联延长有效相干时间 Xu 2024。
为什么”重排”能赢过”连线”:固定布线架构里,qLDPC 检查的度数与多层交叉直接转化为工艺难题;而重排架构里非局域性被时间化——同一物理比特在不同时刻处于不同”连线图”中,连线代价变成 标度的搬运时间(相似于恒定加速度轨迹),且行/列并行使重排的”宽度”与码尺寸解耦 Xu 2024。这正是本文开头所说”实际相关尺度上等效常数”的含义:渐近意义下空转误差随 增长、最终抹掉阈值(与平面码类似的无-go 直觉一致),但增长如此之慢( 量级),在 比特尺度内完全不构成约束 Xu 2024。
混合架构的要义在于:只要存储块足够多,qLDPC 的周期时间不会限制逻辑计算的速率;高距离码(如 )+ 中性原子长相干时间使这类码成为时空两维都高效的存储器候选 Poole 2025。
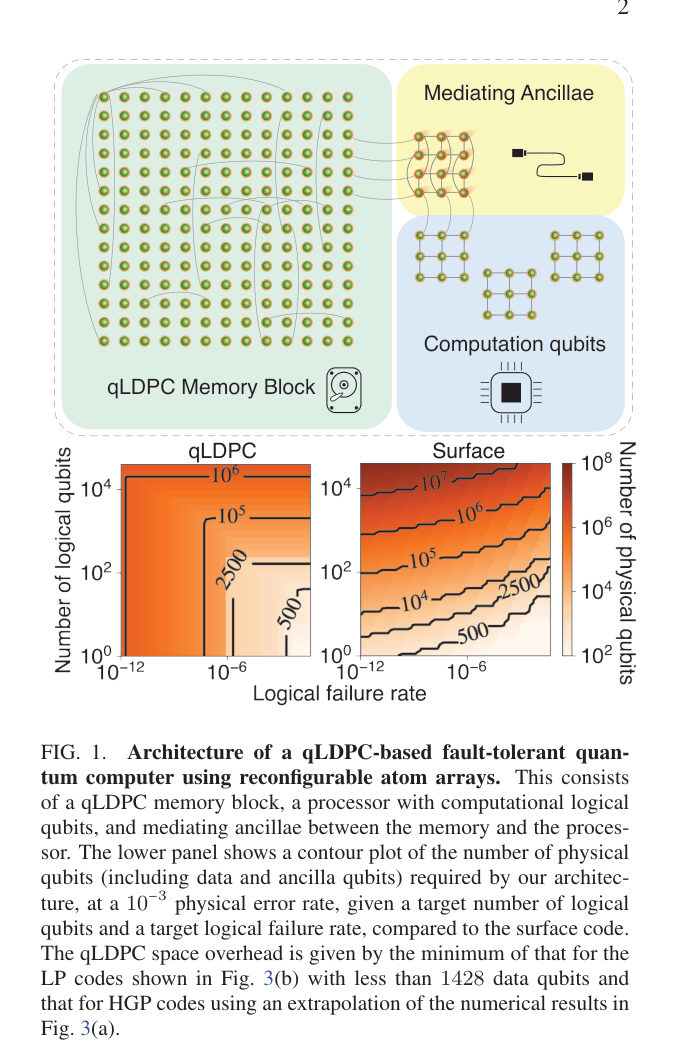
_qLDPC 存储 + 表面码处理器 + 介导 ancilla 的三块架构与物理比特数等高线图(图源:Xu 2024
Fig. 1)_
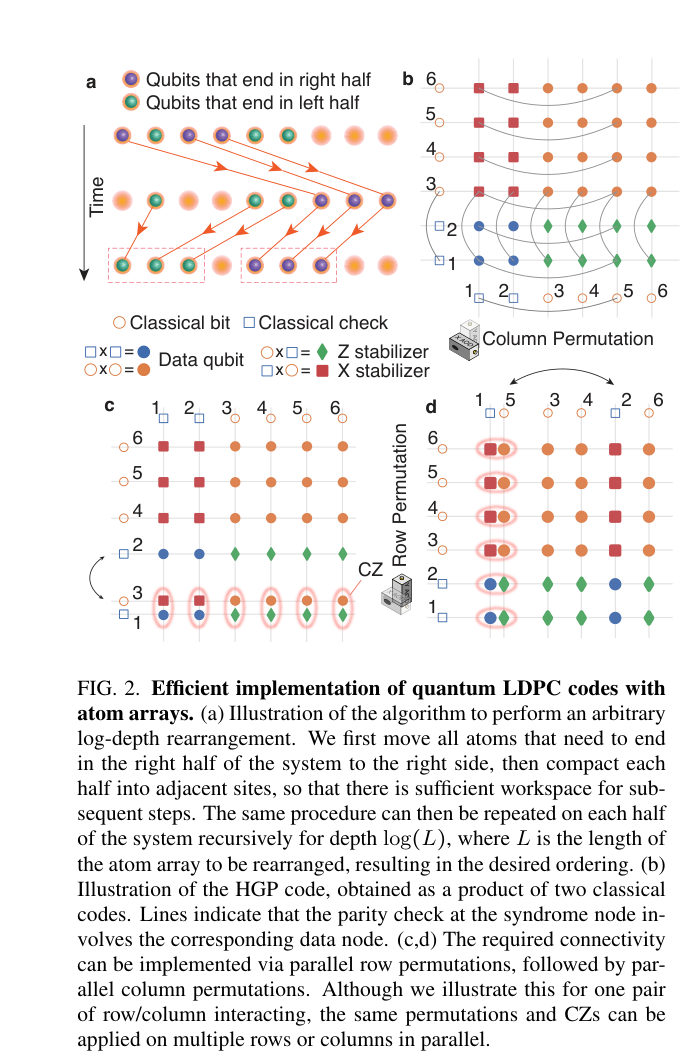
分治对半重排算法与 HGP 码行/列置换综合征提取(图源:Xu 2024 Fig. 2)
参数与量级
| 量 | 典型值 | 来源 |
|---|---|---|
| 电路级阈值(无空转) | HGP / LP | Xu 2024 |
| 超越表面码的起点 | 数百物理比特() | Xu 2024 |
| 25 逻辑比特所需物理比特 | HGP 1235 / LP 851 | Xu 2024 |
| 数量级节省所需规模 | 物理比特(200 逻辑比特)省 | Xu 2024 |
| 数千逻辑比特总开销 | 物理比特 | Xu 2024 |
| SE 纠缠门深度 | HGP 16 / LP 20 层 | Xu 2024 |
| 每层重排时间 | ms(万比特 HGP)vs 相干时间 s | Xu 2024 |
| LP 码实例 | 、、、 | Xu 2024 |
| 重排深度 / 每步传送比特数 | / (开销保持常数的条件) | Xu 2024 |
与其他概念的关系
- 常数开销的渐近蓝本来自 Gottesman 的 qLDPC 容错构造;本词条是它在可重构阵列上的电路级落地,与qLDPC 码架构共享”乘积结构 × AOD 行列并行”的核心观察,BB 码则是码率–距离权衡的另一支。
- 处理器补丁与存储块之间的传送建立在格手术与量子隐形传态之上;若处理器采用表面码,其逻辑门可用横向逻辑 Clifford 门加速。
- 分治重排与行列置换调度是原子搬运与相干输运、最优重排与置换路由在纠错场景的实例,也是FPQA 计算模型能力边界的正面用例。
- 时空 BP+OSD 译码与Stim 稳定子模拟与探测器错误模型的方法论一脉相承;更大规模的匹配译码见Sparse Blossom 最小权匹配。
- 原子重排期间的空转错误是”时间开销换空间开销”的代价,属于误差预算与真实建模的典型问题;若采用擦除偏置码(擦除转换)可进一步抬高阈值。
- 处理器比特读出与存储块 syndrome 提取依赖中电路测量与非破坏读出技术。
参考文献
- Q. Xu, J. P. Bonilla Ataides, C. A. Pattison, N. Raveendran, D. Bluvstein, J. Wurtz, B. Vasić, M. D. Lukin, L. Jiang, H. Zhou, “Constant-overhead fault-tolerant quantum computation with reconfigurable atom arrays”, Nature Physics (2024). NA158 · DOI 10.1038/s41567-024-02479-z
- D. Gottesman, “Fault-Tolerant Quantum Computation with Constant Overhead”, Quantum Inf. Comput. 14, 1338 (2013). (NA158 引文 [17]:常数开销容错的理论蓝本)
- P. Panteleev, G. Kalachev, “Degenerate quantum LDPC codes with good finite length performance”, IEEE Trans. Inf. Theory 68, 213 (2022). (NA158 引文 [8]:准循环 LP 码)
- J.-P. Tillich, G. Zémor, “Quantum LDPC codes with positive rate and minimum distance proportional to the square root of the blocklength”, IEEE Trans. Inf. Theory 60, 1193 (2014). (NA158 引文 [6]:超图乘积构造)