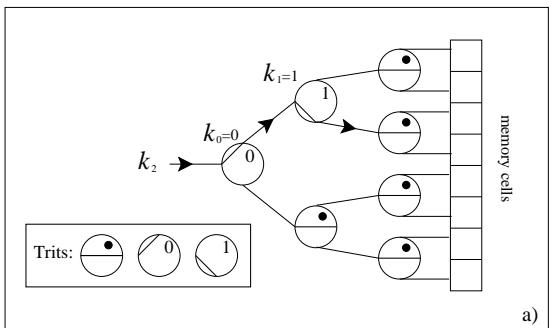
机制回顾:接力寻址
树节点为三能级 qutrit,取一个等待态 与两个指向态 。查询开始后, 个地址比特依次进树:第 个比特被第 层的激活节点”接力”吸收,并把该节点置向左或右;如此沿途 carve 出唯一一条从根到叶的路径。数据读出完成后,再按逆序 uncompute 把全部节点复位。“救火队传水桶”的比喻正由此而来——每个地址比特只在树中停留一段,把方向信息交给下一层就功成身退。
关键的结构性质是:任意时刻只有 个 qutrit 处于激活态并与地址纠缠,其余 个节点始终停在等待态;存储量子数据时,受不可克隆定理限制,读出必须是 SWAP 型的”取出并搬走”。
GLM 两篇论文给出的标志性账目,本词条逐一推导:
- 经典对照:传统 RAM 每次存储调用需扳动 个开关( 维阵列),bucket-brigade 降至 ;量子情形下需要纠缠的两体相互作用门从 降至 GLM 2008 (PRL)。
- 误差标度:若单开关错误率为 ,每次查询的总错误率为 ; 时可对 个地址做叠加寻址而总误差仅 10%GLM 2008 (PRA)。
- 关键噪声约束:指数多数量的等待态节点不被意外激发到激活态。
综述汇总表(表 B)的账目:查询深度 (流水线化后)、比特 、门 、不保真度 至 (后者为一般噪声下的严格上界)Phalak 2023。以下按「机制演算 → 计数 → 三本误差账(GLM / Hann / Arunachalam)→ 实验验算」展开;union bound 等通用工具只引 评价指标,不整段重复。
推导一:n=3 全过程的态矢演化
记号与初始态
取 、:路由树共 个 qutrit 节点、 个叶子存储单元。节点按堆式编号:根为 ,节点 的左、右子节点为 与 ;三层节点为 、、。叶子 挂在第三层之下, 的父节点为 。
地址 ,叶子指标 。路由规则:指向态 把来者送往左子()、 送往右子()。树上有一种两体操作——前沿节点上的吸收门
其中 。 是幺正的:它把正交基 映到正交基 ,其余基矢上的延拓任意(如恒等)。地址寄存器不被消耗——指针与地址是幺正关联而非测量式复制;GLM 光学实现中,这对应”光子被吸收、原子翻转到指向态、再以标准态发射光子”的图像。
查询开始前的总态(地址寄存器 、树寄存器 ):
逐层演化:三步进树
第一步, 与根 (当前唯一前沿)作用:
第二步, 被接力:根已指向 ,把 引导至节点 ,后者处于等待态、将其吸收:
每条分支里第二层的 恰有一个被激活、另一个仍在等待——前沿唯一。
第三步, 穿过两个已激活节点(根、第二层前沿各一次两体通过),在第三层被吸收:
以 为例逐步代入:;(因 );(因 ),其余四个节点保持 ;总线随后沿 下行到达 ()✓。
路径构型表与两个结构引理
八个地址的树构型 (只列激活节点):
| 000 | 100 | ||
| 001 | 101 | ||
| 010 | 110 | ||
| 011 | 111 |
每个构型恰 3 个激活节点、4 个等待节点; 是地址的单值函数,不同地址的构型互不相同。两条引理把这张表升级为一般 的结构定理。
引理 1(前沿唯一性,归纳)。 第 步后,激活节点集恰为根到第 层那条链上的 个节点。归纳:第 个比特从根出发,沿链上各节点指向逐层下行(每节点一次两体通过),抵达唯一前沿并被 吸收;激活集延长一节。∎
引理 2(carve 是等距映射)。 时 :两条路径第一处分叉的节点上一个取 、一个取 ,节点态正交。故
范数守恒;树寄存器以”路径码”形式无损持有地址——这正是 QRAM 总览 中查询等距映射在电路级的实现。
读出与逆序 uncompute
总线(初态 ,经典数据)沿 下行(每分支 次两体通过),与被寻址单元交换:
量子数据情形,同一位置换成总线与单元态的 SWAP(不可克隆约束)。随后按逆序复位:先以 作用在 上(用 :),再以 复位第二层、 复位根:
树寄存器与地址解纠缠,对树求迹不留任何 which-path 记录。uncompute 不是可选清理,而是查询幺正性的构成部分: 是地址的确定函数、可被逆序收回;噪声若把构型随机化为 ,干涉块系数退化为 ,无法事后修复(相干条件见 QRAM 总览)。
推导二:激活计数与操作账
激活数是逐分支恒等式,不是平均值
定义激活数算符 (对每个节点投影到指向态子空间)。由引理 1,第 步后 在 的每个计算分支上都取确定值 ,查询全程峰值 (一般 )。两点值得强调:
- 零方差:「任意时刻仅 激活」是对每条计算分支同时成立的算符恒等式,强于期望值陈述;
- 对照 fanout:fanout 中每条分支都要扳动全部 个开关,激活数恒为 。 时两者是 对 ,优劣尚不分明——桶队的优势是渐近性的, 时为 对 ,激活占比 。2026 年实验选 是器件规模所限,检验的是机制而非标度。
交互事件计数:
要区分”激活的组件数”与”两体交互事件数”两本账:
- 组件口径(GLM PRL 的口径):每条分支被置离等待态的节点恰 个,即”扳动的开关数”;
- 事件口径:第 个比特要穿过 个已激活节点(每次穿过是一次两体散射),再被前沿吸收(又一次),共 个事件;逐比特求和
等价数法:深度 的被激活节点”花费” 个事件( 次通过 次吸收),每层恰一个,求和相同。与 fanout 对比( 个事件):
| fanout 事件 | 桶队事件 | ||
|---|---|---|---|
| 3 | 8 | 14 | 6 |
| 10 | 2 046 | 55 | |
| 30 | 465 | ||
| 100 | 5 050 |
处相差约 27 个数量级——这就是”纠缠两体门 “的出处 GLM 2008 (PRL)。Hong 等按自己的口径统计完整存储调用(地址进树 总线读出 逆序 uncompute)需对控制节点做 次量子操作,并提出两能级方案把平均操作数压到 Hong 2012;与事件口径同为 ,差别只在计入哪些辅助操作(见 两能级路由器)。
时间账: 步与流水线
第 个比特的前沿由第 个比特定义,进树严格串行:单次相干检索耗时 个交互步(地址进树 总线 uncompute ),并要求单步错误率显著小于 ——这是该架构最常被诟病的账目 GLM 2008 (PRA)。缓解有二:门级并行化与地址流水线把摊销深度压回 层 Paler 2020(见 电路级优化);现代硬件方案(如浙大实验)以量子隐形传态保持层间 延迟(见 BB-QRAM 实验)。流水线只改善吞吐,噪声账里的 不因此减小。
推导三:GLM 误差账
开关口径:从 到
模型:每个激活开关每次调用以概率 出错、相互独立;保守假设任一错误毁掉所在分支的输出。分支”全程无错”的概率为 —— 来自推导二的组件口径。二项式展开:
末步即 Bernoulli 不等式,也正是 union bound 的”预算”读法(一般证明见 评价指标):给 个激活开关各分配 预算,失败概率自动 ,无需任何相关性假设。于是每查询总错误率
乘法结构: 翻倍只让 加一、 只多付一个 。反解:要求 需 ;、 给 ,即 GLM 口号”0.1% 够用”的来源 GLM 2008 (PRA)。
操作口径与
若错误不是只挂在 个开关上,而是均摊到全部 个交互事件上(事件口径),则 ,恒定 要求 。Arunachalam 等转述 GLM 原始主张时用的正是这个口径 Arunachalam et al. 2015。两口径差因子 ,但都远优于 fanout 的 (要求 )。
数值表
| 开关口径 | 精确 | 事件口径 | |||
|---|---|---|---|---|---|
| 0.1% | 100 | 10% | 9.52% | 10(界空洞) | |
| 1% | 10 | 10% | 9.56% | 1(界空洞) | |
| 1% | 20 | 20% | 18.21% | 4(界空洞) | |
| 1% | 30 | 30% | 26.03% | 9(界空洞) |
线性列与精确列之差是二阶项 (如 、:,把 10% 拉到 9.52%)。事件口径列在所有行都 :招牌数字「0.1%@2^100」依赖开关口径——假定错误只发生在 个激活开关上。两口径的分歧正是 Hann 定理与 Arunachalam 负结果的攻击点(编年对账见 十八年时间线)。
关键前提:指数多的等待态必须沉睡
开关口径有一条隐含前提(即上节 GLM 的关键噪声约束 GLM 2008 (PRA)):未被激活的 个节点整个查询期间不被意外激发——否则它们也须计入预算,朴素修正后 ,韧性消失。这个前提能否放宽,是 2015–2021 年理论的主战场,见推导四。
推导四:Hann 一般噪声界与韧性的真正来源
定理设定
Hann、Lee、Girvin 与 Jiang 考虑最不利设定:全部 个路由器(含等待态)每时间步各经受任意 CPTP 噪声信道(去极化、相干转角、常数范围串扰均可),单操作错误率 ,电路深度 Hann et al. 2021。结论:
完全一般信道的常数稍差()。定理完整陈述与证明骨架见 噪声韧性;这里推导桶队特有的两块:逐层对消与有限纠缠。
逐层对消:错误数目与杀伤半径相消
推导一的 carve 结构给出每层两个数:
- 数目:第 层()有 个节点;
- 杀伤半径:深度 节点只在前缀匹配的 条分支上被激活,故它的一个错误至多波及全部 条分支中 的份额。
对照 fanout:每个开关在所有分支上激活(杀伤半径恒为 1),数目 半径逐层相乘发散。桶队中两者逐层精确相消:
每层只留下常数 ,与层号无关——标度已现。严格的因子 4 来自把相干错误先用迹距离记账、再换算回保真度时的两次范数放缩(相干错误对 是二阶小量、对可观测偏差是一阶;换算细节见 评价指标 的相干错误二次律与 噪声韧性)。
具体化:均匀地址下,根上的一个错误毁掉全部 8 条分支,第三层某节点的错误只毁掉 2 条(份额 )——杀伤半径逐层减半,即逐层对消的微观机制。
数值验算():
| () | () | 所需 | |
|---|---|---|---|
| 10 | 0.4 | ||
| 30 | 3.6(空洞) | 0.036 | |
| 50 | 10(空洞) | 0.1 | |
| 100 | 40(空洞) | 0.4 |
对照当前超导路由器保真度 95.3%()Miao 2025: 要保真 90% 还差约四个数量级。与 GLM 开关口径相比,Hann 界多付因子 的保守性,买到的是”对任意信道、含等待态退相干成立”。
纠缠熵的显式计算:韧性的物理来源
「韧性的真正来源是路由器间有限纠缠,而非激活门少」可以算成数字。取均匀地址 ,考察深度 节点的约化密度阵:在前缀匹配的 份额分支上它被激活(指向态 各占一半),其余分支保持 :
本征值 。对该节点与其余全部自由度的割,纠缠熵为
其中 为二元熵。 逐层代入:(根在所有分支激活,完全携带 )、、、 比特——自第一层起逐层递减(根是唯一例外:它总被激活)。深层路由器与整体的纠缠指数小,其错误只波及指数少的分支:这就是逐层对消中 因子的物理身份,也解释了为何两能级化、纠错化、资源态化等改动不破坏韧性——只要不动树上的纠缠结构。2026 年实验实测各层路由比特纠缠熵随深度递减,把这条计算第一次变成测量 Shen et al. 2026(见 误差局域化)。
双能级修正: 从哪来
把 qutrit 换成更易实现的两能级路由器(无等待态兜底),错误可沿树向上游泄漏:从路径上每个节点出发,经错误指向的端口可达一条长度 的上行链; 个路径节点合计至多 个节点须悲观计入易错集合,
dephasing 噪声下泄漏通道关闭、回到 Hann et al. 2021。综述汇总表” 至 “的两端,恰是 qutrit 理想账与 qubit 保守账 Phalak 2023。
推导五:Grover 预言机下的负结果
right / wrong / no-path:三类错误在树上的身份
Arunachalam 等为桶队电路构造了三类错误 Arunachalam et al. 2015:right(路径内)——激活节点上的门错误,直接污染该分支输出;wrong(路径外误激发)——等待态节点被误激发,当次输出仍正确,但残留激活误导后续比特的接力;no-path(无路径)——地址比特吸收失败,根到叶路径没有 carve 成,查询整体失效。no-path 是主导项,且对纠错最不友好。
从 Regev–Schiff 到
桶队用作 Grover 搜索的预言机时,迭代需 次调用。Regev–Schiff 定理(故障预言机下二次加速消失;证明骨架见 十八年时间线)给出:每次调用以概率 故障时,保住二次加速要求
第二步把每次调用的故障率 换算成单门错误率 :每次调用有 个可能出错的操作(事件口径, 量级),则
(推导:。)合并 与 :
远比 GLM 的 严苛 Arunachalam et al. 2015。
数值算例与算法分流
| 对照 GLM 事件口径 | |||
|---|---|---|---|
| 10 | |||
| 30 | |||
| 100 |
时与 GLM 口径相差约 16 个数量级。但负结果惩罚的是用法而非器件本身:指数要求来自 次查询的误差线性累积()。多项式次查询的算法(HHL 型矩阵求逆、qPCA 型量子机器学习)按 union bound 只需每次调用故障率 ,GLM 账本够用、可能免纠错 Arunachalam et al. 2015。同一个 器件:做搜索预言机要求 ,做多项式次查询的数据装载则 量级即可——误差要求是器件-算法的耦合属性,非器件固有标签。
纠错悖论与反转
更棘手的是:给桶队套上传统 CSS 纠错,症状提取每轮须触及全部 个节点——所有组件被纳入主动纠错,“激活门少”的优势在物理层面瓦解,架构退化为 fanout 式 Arunachalam et al. 2015。这段悲观在 2021 年被部分反转:Hann 等证明桶队韧性在纠错框架下依然成立,且硬件效率与逻辑错误韧性反而改善 Hann et al. 2021;论战编年见 鲁棒性论战。
实验验算:错误注入斜率与局域化预测
2025 年浙江大学的三层桶队实验(8 叶子)给出机制级验算 Shen et al. 2026:向第三层一个路由比特注入可调去极化误差()后,被查询路径(经过该节点的分支)保真度以斜率 近线性下降;三个未查询路径平均斜率 ;距被注入节点最远的分支斜率 ,在误差棒内近乎为零。
与推导四的预测对账:第三层节点只在前缀匹配的 分支上激活,局域化预测:(i) 被注入节点所在分支陡降;(ii) 其余分支只经残余耦合(串扰、SPAM、错误传播)缓慢退化;(iii) 理想极限下两组斜率比无穷大。实测斜率比 、对未查询路径平均约 12 倍:方向与量级均与局域化一致,有限比值对应非理想局域;若桶队如 fanout 全局耦合,各分支斜率应同量级(比值 )——被数据排除。同期实测的逐层纠缠熵递减与 计算同构。「有限纠缠 韧性」由此完成从定理到测量的闭环(完整账目见 BB-QRAM 实验 与 误差局域化)。
三种原理性实现
GLM 长文给出三种实现,均止步于 proof-of-principle、无数值保真度GLM 2008 (PRA):
- 光学 fanout:光晶格或磁光阱中的原子存地址,单光子总线经 CNOT 级联(基于 Jaynes-Cummings 循环跃迁)展开到 个空间模式;
- 相位门 fanout: 个腔加条件相移器,要求分束器透过率 (指数小),可由超导量子比特加微波腔实现——腔的相干时间(微秒级)远优于电荷量子比特(纳秒级);
- 耦合腔 bucket-brigade:耦合腔网络中的陷俘原子作 qutrit,能级 ,Raman 跃迁的吸收-重发光子实现存储与路由。
GLM 还指出该架构对经典 RAM 同样把激活晶体管数降到 、可降低解码能耗,但论文自承当前 RAM 的功耗主要在存储单元泄漏与刷新,寻址能耗尚非瓶颈。
定位与边界
bucket-brigade 之所以成为”标准架构”,不在于任何单项指标最优,而在于它在深度、资源与噪声三方面同时给出可接受的账目,并为后续所有创新(虚拟化、胖树、资源态化)提供了共同的语义基底。综述的判断是:QRAM 的出路不在单一架构,而 bucket-brigade 的”器件韧性”是三重组合中已被严格证明并实验证实的那一环。
三条边界须同时记牢:
- 运行时账不是器件账:多对数的是每次查询的激活门;器件本身仍需 个节点、 比特与 总门数 Hann et al. 2021;
- 优势是渐近的: 时激活占比 3/7,与 fanout 差距有限;小规模实验检验的是机制(接力、uncompute、局域化)而非标度;
- 口径依赖:主动/被动与能量口径的质疑未被韧性定理消解,见 成本口径。