机制回顾:工厂供给什么,在线消费什么
在资源态 QRAM 的统一框架 中,查询的全部非 Clifford 复杂性被搬进一个与数据无关的资源态(resource state):在线侧只做 Bell 测量、条件 Clifford 门与单比特 Pauli 测量,以 消费掉一份现成的 (框架与查询协议见资源态 QRAM与Clifford 容错接口)。工厂的定义性角色由此确定:以稳态产率 持续制备 ,使供给率不低于消费率。本词条把这两个时间量——工厂周期 与查询时间 ——作为全部推导的主角。以下数值均取 为存储的数据比特数(, 为地址比特数;“1 kB 存储”即 )。
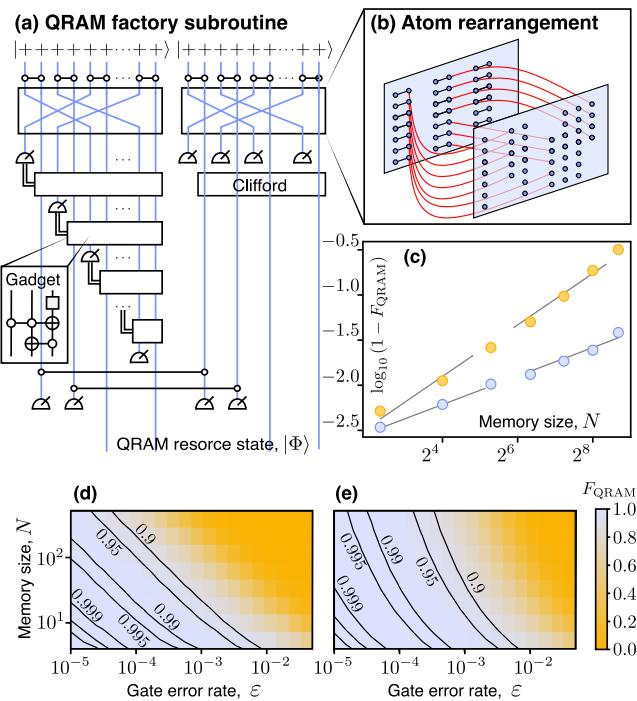
工厂的制备流程分三步Cesa et al. 2026:
- Bell 对制备:先制备 个 Bell 对,作为资源态的原料;
- 动态重排:利用中性原子光镊的相干动态重排完成布图重构,把原子搬运到目标几何位置——这是中性原子平台相对其他平台的独门能力,也是整个架构选择该平台的直接原因;
- 资源态组装:以 个 Toffoli 门组装出资源态 ,电路深度 ,每个 Toffoli 注入 4 个 T 态。
三步的精确计数值得先钉死,后面反复用到。对查询 比特存储所需的 ,Toffoli 门数为
即 而非 ( 是把”深度 宽度”合在一起的时空量级口径);按每个 Toffoli 4 个 T 型门的最省分解(以牺牲深度换 T 数),单份 的 T 态消耗为 。组装电路经并行化恰为 层,门时间( ns)远小于中途测量时间(),故周期由测量与原子搬运主导。在容错语境下,工厂以四层并行运转:层 1 为 Toffoli 态工厂(空间 , 为码距,周期 );层 2 为 Bell 对重排(每周期 次长程搬运,速率 );层 3 为测量式组装(周期 ,每周期消耗 个 Toffoli 态与 Bell 态);层 4 为 try-until-succeed 式 heralding 制备(见推导三)。
推导一:工厂周期的两项账
工厂周期由文献给出为Cesa et al. 2026:
其中 为原子移过一个最小陷阱间距的搬运时间, 为一轮非破坏单比特测量(SQPM)时间。两项各有独立来源,逐项推。
测量项:
组装(与在线查询同构)电路共 层,每层以一轮 SQPM 收尾,一轮耗时约 ;单比特与 Clifford 门时间 ns 可忽略。故
这恰等于查询时间 ——在线查询与离线组装的测量负载相同,这是后面流水线论证的关键对称性。数值: 时 ,与文献一致。
重排项: 的完整推导
第一步:单原子搬运的恒加速度标度。 光镊移动原子时损失率随速度上升,故优化目标是在损失率不增的约束下最短时间到达——等价于恒加速度的”半程加速、半程减速”轨迹:路程 ,解得
实验拟合同标度:,以 @ 外推到最小间距 ,得每间距搬运时间
与文献取值吻合。注意 依赖是重排项只贡献 而非 的第一个原因。
第二步:布图压缩给出最大搬运距离。 Bell 对按列扇区 packing:第 扇区占用的纵向尺度从 压到 的方块,于是整个阵列的线性尺度为 个陷阱间距,单次长程搬运的最长距离为
第三步:常数次搬运合成周期。 压缩方案下每个工厂周期含 次长程搬运,文献给的是 6 次,故
末步是恒等式 (两边平方均为 54)。直觉: 是两个平方根的复合——布图压缩把阵列尺度从 压到 (第一个根),恒加速度轨迹再把距离 的时间压到 (第二个根)。这也是”重排看似全局重构、实为浅层开销”的原因。
两个标度的竞争与交叉点
重排与测量的占比由比值
决定(代入 、)。令两项相等,解 ()得 :即 (约 16 MB)以内测量项主导,重排不构成主要瓶颈;文献把”重排可忽略”的安全区划在 (约 2 MB)。
| 重排占比 | ||||||
|---|---|---|---|---|---|---|
| (1 kB) | 13 | 9.5 | 2.3 ms | 13 ms | 15.3 ms | ≈15% |
| (128 kB) | 20 | 32 | 7.8 ms | 20 ms | 27.8 ms | ≈28% |
| (2 MB) | 24 | 64 | 15.5 ms | 24 ms | 39.5 ms | ≈39% |
文献对 1 kB 工作点报的搬运占比约 13%,与按上式直算的 15% 同量级(常数取整差异)。趋势清楚:占比随 缓慢上涨,到 仍是次主导项,越过 后才反超。
推导二:流水线与吞吐——供给的排队账
工厂化方案的运行学核心问题:给定工厂周期 与查询时间 ,系统稳态能以多高速率回答查询?延迟由什么决定?以下把工厂当作服务站、资源态当作不可存储太久的车票,做一套排队(queueing)核算;模型假设(到达独立、服务指数分布)在节末讨论。
确定性流水线:工厂恒为瓶颈
由推导一,,等号仅当重排为零。设单工厂连续运转、查询按节拍到达:长期看每 产出一份 、每 消耗一份,稳态供给率必须不小于消费率,故单工厂可持续查询速率为
关键在 而非 :查询与下一份资源态的制备在时间上错开并行,周期墙钟由二者中较长者决定。对比串行执行(查询完再制一份):1 kB 时串行节拍 (35 Hz),流水节拍 (65 Hz),省掉整整一个 。文献”并行化不增加实质运行时间”的论断即此:,记作 Cesa et al. 2026。代价之一是首份延迟:冷启动到第一份 就绪需等满 。
多工厂:吞吐线性,延迟有下界
设 个工厂错相运转(相位间隔 ),则供给率 ,任一时刻最近的一份 距就绪不超过 ,故最坏延迟为
即在线测量时间是延迟的不可压缩下界——加工厂只消等待、不消查询本身。吞吐上界 同理。“工厂不再拖累速率”的临界工厂条件是 ,即
代入 1 kB:,故 即消除供给瓶颈——这正是 的直接推论,也解释了为何该蓝图在甜蜜区内”工厂便宜”。
随机到达:M/M/1 缓存账
若查询到达是速率 的泊松过程、产出是速率 的指数过程,缓存中的 构成一个 M/M/1 队列(稳态要求 )。生灭平衡方程
缓存平均存态数与单次查询平均等待:
数值:1 kB 单工厂 。取 ():、;取 ():、。利用率从 0.5 提到 0.8,延迟翻倍还多——排队账的第一课:靠近饱和运行的代价是非线性延迟。
缓存存态不是免费的:资源态在缓存中龄期越长,退相干越深。龄期 的态保真度按 折损,被消费态的平均龄期即 ,故缓存引入的额外不保真度 。示例(假设值,仅演示量纲):取 (相干时间 10 s 量级), 时 ,尚可;若因扩容 而 涨到秒级,缓存反而成为保真度漏洞。缓存深度因此不是越大越好:它以相干龄期换吞吐平滑。
突发需求:缓存量化条件
算法常以突发方式查询(如 次振幅放大迭代背靠背)。 连发以 速率消耗、 工厂以 速率补充,净消耗速率 ,突发期间的总缺口
单工厂 1 kB、: 份预存; 时缺口归零,无需缓存。结论与上一小节一致:重排项越小,供给越接近”无限快”,缓存越可省; 这一个比值同时控制临界工厂个数与突发缓存深度。
推导三:heralded 制备的产率–保真度账
资源态制备离线,意味着可以”失败即弃、重来一次”(try-until-succeed):制备中插入错误检测,检出错误就整份丢弃重来。这正是文献所谓 heralded(可判别)QRAM 工厂Cesa et al. 2026。heralding 的具体方案:选整数 ,记 ,约束 ( 为单步操作错误率);对前 个地址比特充当控制端的所有门做错误检测,出错即弃。需 herald 的门数 ,占总门数 的可忽略份额。下面算三笔账:吞吐折扣、资源浪费、保真度增益。
重试经济:接受率与有效周期
前 层累计约 个门(第 层),一次尝试在某一 herald 层首次检出错误的概率按一阶展开为
约束 恰好保证接受率 接近 1——自洽。重试次数服从几何分布,期望 ,故有效工厂周期
数值(、、):,(1 kB)——五分之一的机会重试,只花 5% 的时间。
浪费账:平均废弃 Toffoli 数
第 层失败会废弃已注入的前 层共 个 Toffoli。期望浪费:
与文献给出的 一致(相差常数 3)。数值:、 时浪费约 8.7 个 Toffoli,对照总量 (1 kB),占比 0.05%——“高接受率、低浪费”不是口号而是上面两行的代数推论。
保真度增益:好比特计数的修正界
文献对查询不保真度的解析界为 ( 为组合常数, 依赖噪声模型,主文连续去极化拟合 ;模型相关取值见噪声韧性)。其推导按”好比特计数”进行:期望完好辅助比特数 。对前 层 heralding 后,浅层错误贡献被切除,修正为
与文献”增益 “相容。数值(、): 时上式 ,即不保真度上界削去约 55%,代价是 5% 重试与 8.7 个废弃门;(逻辑级错误率)时受 约束只能取 ,削去约 18%、重试 6.4%。
为什么浅层最值钱?NOHE/桶队电路逐层指数生长:浅层一个门的错误经树状拓扑向下游大量节点传播,单位门的保真度权重最高;而浅层门数最少、herald 成本最低。切除”权重最大、门数最少”的部分,是误差局域化结构给 heralding 送的礼(机制见误差局域化与桶队架构)。这也说明 heralding 的有效性不是普适的态制备技巧,而是绑定在桶队型误差结构上的。
推导四:工厂化 vs 单体相干器件的账目
把”直接在线执行 “的单体相干器件与”工厂产 + Clifford 查询”并排对账Cesa et al. 2026:
| 账目项 | 单体相干器件(在线执行 ) | 资源态 + 工厂 |
|---|---|---|
| 在线非 Clifford 门 | 个长程门,每次查询重付 | 0(全 Clifford + 测量) |
| 在线深度 | (与工厂方案同阶) | 层 |
| 非 Clifford 总功 | 个 Toffoli、约 个 T 态,离线一次 | |
| 非 Clifford 时间归属 | 占用主算法墙钟 | 折入 ,与查询流水并行 |
| 失败语义 | 无中间检验,出错整查询报废 | try-until-succeed:废弃一份 ,接受率 |
| T 态精度 | 需在线实时供给 | 精度只需 ;含蒸馏的噪声 T 消耗较非韧性方案降 polylog 因子 |
| 空间 | 辅助比特 | 同左,另加工厂区(,容错)与缓存 |
| 每查询墙钟 | 且含 在线非 Clifford | ,非 Clifford 全离线 |
可以把”硬件复杂度转移为制备复杂度”表述成一个守恒式论断:非 Clifford 总功在同阶内不变(甚至因并行分解从 长程门变为 个 Toffoli),变的是它的记账科目——从”每次查询的在线时间与相干暴露”改为”稳态吞吐约束下的离线制备率”。由此派生三个自由度,都是单体器件没有的:其一,离线功可按 份并行摊薄();其二,失败可以从查询语义中剥离(heralding,推导三);其三,非 Clifford 暴露窗口限于 而非全算法时长,与纠错层的接口因此透明(在线横向 Clifford,免魔态注入)。Jaques–Rattew 批判所要求的”主动干预成本必须显式计账”在此得到字面满足:干预被计为 与 两个参数Jaques & Rattew 2025(批判全文的定位见成本口径)。
数值算例:两个工作点的完整账单
物理级,1 kB(): ;T 态 份/周期;,产率 65 Hz;T 态供给率 。组装 23 层,每层约 712 个 Toffoli、2850 个 T 态,层时间 内注入,瞬时 T 流约 ,与均值同量级(自洽)。按 Bravyi–Kitaev 15→1 蒸馏粗算,噪声 T 态需求约 。运行参数: 消除瓶颈;100 连发需 16 份预存(单工厂)或 0 份(双工厂)。
容错级,QEC 处方: 文献给出码距 下的工厂周期
其中重排项被纠错层的并行化摊薄了 因子。取表面码达到查询保真度 所需的码距 、Cesa et al. 2026:
| 项 | , | , |
|---|---|---|
| 507 ms | 1080 ms | |
| ms | ms | |
| 293 ms | 338 ms | |
| 814 ms | 1522 ms | |
| ≈1.61 | ≈1.41 |
比值 1.61/1.41 与文献报的 ≈1.6/≈1.4 逐项吻合:即便计入综合征提取与蒸馏开销,离线工厂时间仍与在线查询时间相差不过一个 O(1) 因子,流水线论证在容错语境下原样成立。此时的 T 态供给率: 约 份蒸馏 T/s(噪声 T 约 /s);2 MB 约 /s(噪声 T 约 /s)——工厂化把”每查询 个在线非 Clifford 门”换成的是每秒上亿份的 T 态供应链,这正是账目对比表中”T 态精度只需 “一条之所以要紧的原因:精度要求降了 倍,供应链才要得起。
适用边界与开放问题
规模上限。 推导一给出交叉点 :越过之后 ,工厂产率按 衰减。维持恒定查询速率需 个工厂——从 到 , 从 9.5 涨到 64,同速率要多雇约 7 倍工厂。“空间换时间”在工厂侧同样成立,只是汇率是 。
模型假设。 推导二的排队账假设到达独立同分布、服务指数、稳态;真实算法的查询节奏由算法本身决定(如 Grover 迭代深度),突发条件 是确定性包络而非统计保证。推导三的 heralding 账依赖错误可检测:容错语境由综合征免费提供,无纠错语境则依赖泄漏的物理探测与擦除转换Scholl et al. 2023;静默错误的危害回到噪声韧性账目,不受 heralding 保护。缓存的 以龄期换吞吐,相干预算(推导二)约束了缓存深度与利用率的上限。
实验空白。 工厂吞吐随 的标度、大规模布图下重排的调度与碰撞规避、吞吐–保真度权衡,均尚无实验验证;文献明确指出该思想可迁移到囚禁离子、超导、光子等具备搬运能力的平台,但各平台的”工厂”形态(尤其是非原子平台的 项由什么物理过程承担)仍是空白。在线接口一侧,逻辑块间原子搬运已被逻辑原子处理器实验证明可行Bluvstein et al. 2024;离线侧的完整工厂演示是中性原子社区未来数年最明确的发力点。平台对比的整体定位见中性原子平台;把”资源态制备”与一般态制备问题切割的概念边界见态制备边界。