账本科目
以表面码架构为例(各组件的词条见交叉链接):
- 数据 patch:距离 的方形 patch 含 个物理比特(数据加测量)Litinski 2019 (Quantum);码距由”逻辑错误率 ≤ 目标”反解,资源估计常用每比特每轮 级目标Gidney 2025 (arXiv)。
- 魔法态供给:蒸馏厂(15-to-1 及其改进版,见magic-state-distillation)或培育厂(见magic-state-injection);蒸馏的输入态数以 标度。
- 路由走廊:可扩展布局必须留白——Horsman 论文的布局只有约四分之一的面存数据,其余供 CNOT/手术操作Horsman et al. 2012 (NJP);Litinski 的贴砖游戏把这类时空成本统一为 主阶Litinski 2019 (Quantum)。
- 反应限制:经典反应时间(10 µs 级)约束测量依赖运算的布局Gidney & Ekerå 2021 (Quantum)。
Gidney–Ekerå 2019:2000 万比特、8 小时
假设平面二维近邻、物理门错误 、周期 1 µs、反应时间 10 µs,优化链为:Zalka coset 表示(模算术改非模加法器,Toffoli 主项从 降到 )→ 窗口算术(QROM 查表加基于测量的反计算,主项 )→ oblivious carry runways(加法深度减半)→ 反应限制布局。抽象电路: 逻辑比特、 个 Toffoli、 测量深度;容错层用 CCZ 工厂(AutoCCZ 态)与三级区域布局,码距 (二级)/17(一级)Gidney & Ekerå 2021 (Quantum)。对比前史:Van Meter 2009 需 6500 万比特、410 天;Fowler 2012 需 1000 万比特、1.1 天;本文以并行化换机器规模,落到 2000 万比特、0.31 天——较此前估计时空体积降 100 倍。
Gidney 2025:100 万比特以内、一周以内
同一标准假设(0.1% 均匀去极化、1 µs 周期、10 µs 反应、平面 2DNN)下的新账本靠三根支柱达成 20 倍缩减Gidney 2025 (arXiv):
- 算法侧:CFS24 的 Shor 变体用掩码与相位估计技巧把逻辑比特压到约 (本文又把其 Toffoli 代价改善了数量级);
- 存储侧:yoked surface codes(上轭表面码)——在数据 patch 下方并联一维/二维奇偶校验码”轭”,冷存储区的存储密度大增(二维轭的抑制增益参数约 150),布局分计算区/热存储/冷存储三区;
- 魔法态侧:培育加 8T-to-CCZ 蒸馏——培育把 态做到 逻辑误差只需约 3 万物理比特·轮时空,8T-to-CCZ 工厂把错误压制到 、CCZ 误差 ; 时晶格手术周期 25 µs 恰与 CCZ 周期匹配。
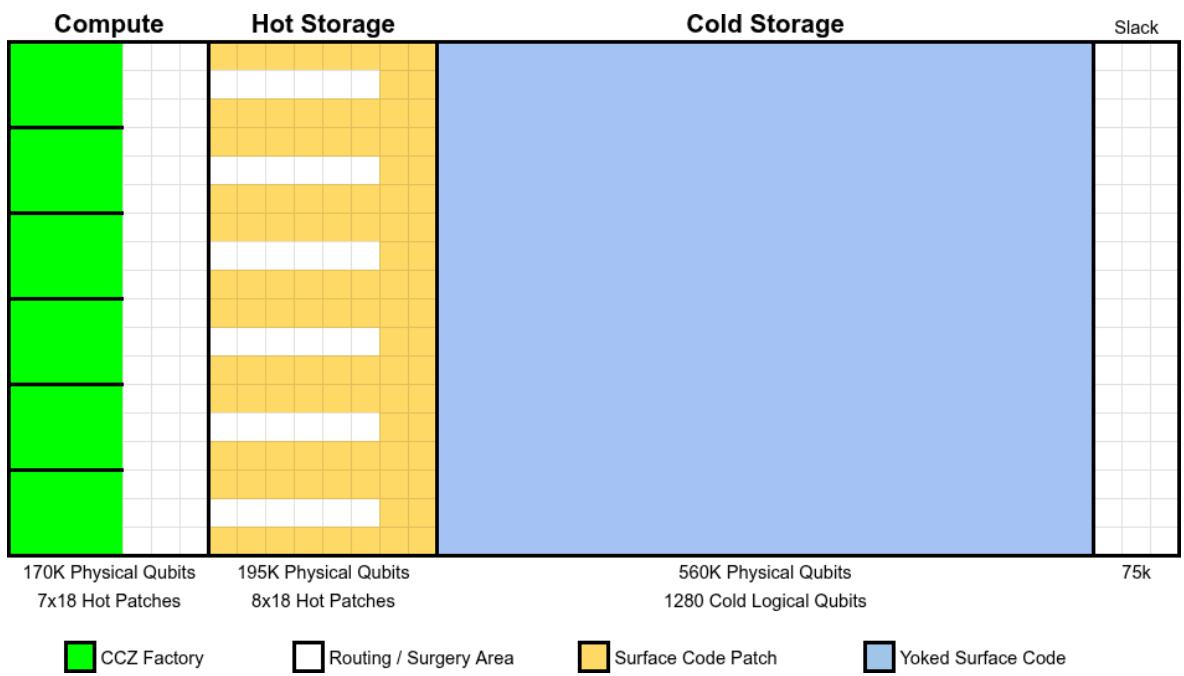
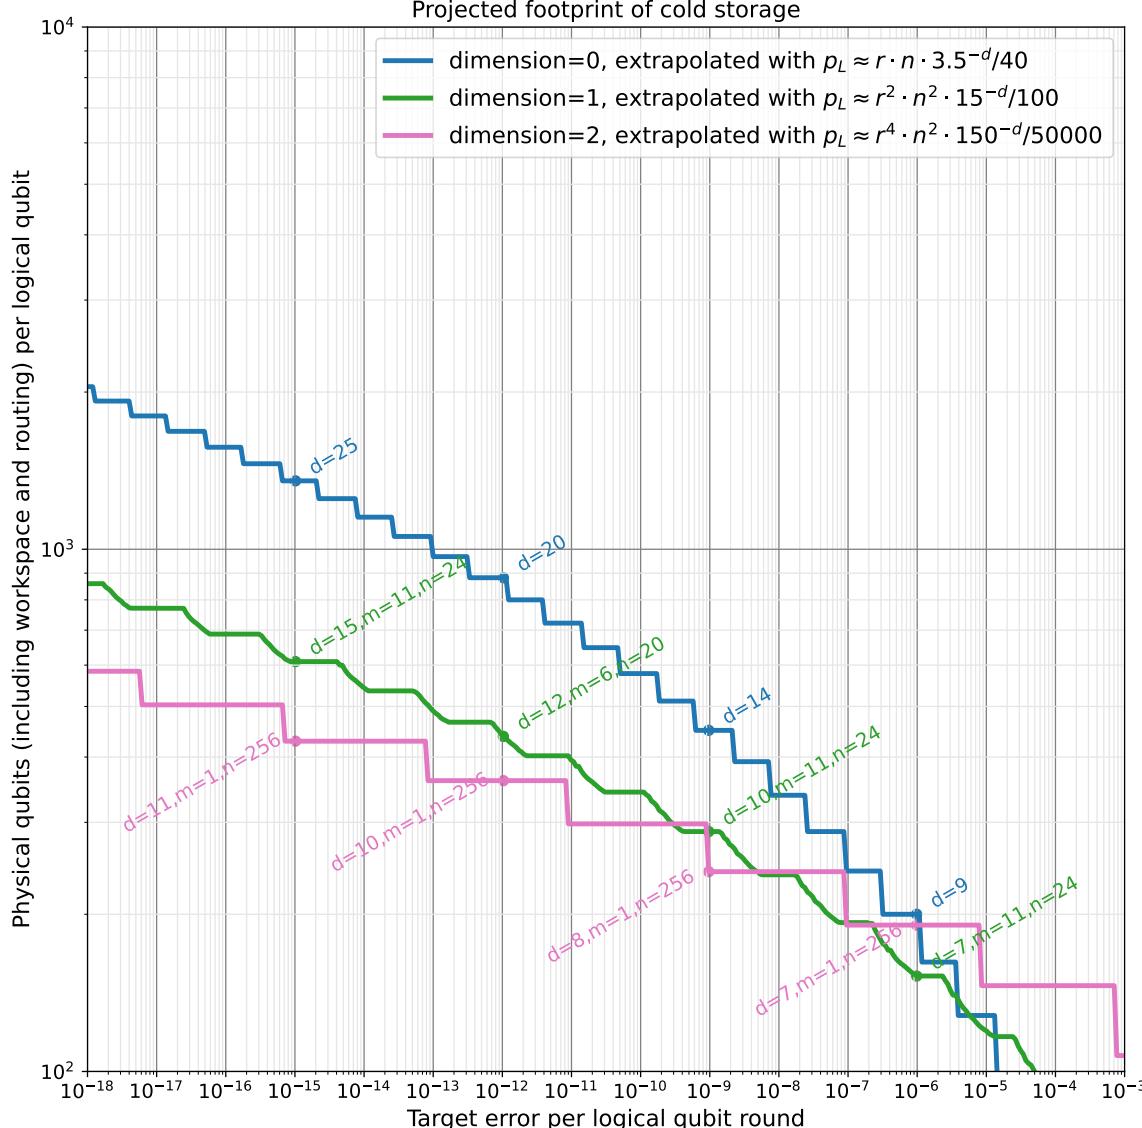
运行时账:单次运行 12.07 小时,按每比特每轮 的逻辑错误率预算,整轮无错概率 93.3%,期望 9.2 次运行得到一个成功 shot,总时长 4.96 天(报告”一周以内”)、约 比特(报告”一百万以内”)Gidney 2025 (arXiv)。
时空权衡与蒸馏成本
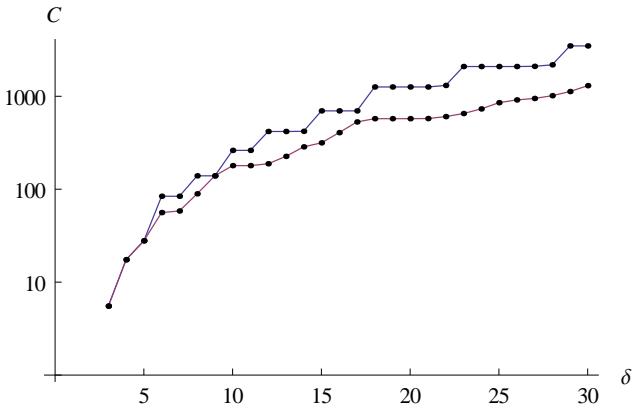
Litinski 的三级时空权衡给同一问题的另一组坐标( 个 门、、1 µs 周期):紧凑布局 5.5 万比特、4 小时;10 个蒸馏块 12 万比特、22 分钟;Fowler 式时间最优并行 3.3 亿比特、1 秒Litinski 2019 (Quantum)。蒸馏本身的成本随目标精度按 增长:Bravyi–Haah 的 15-24-36 协议序列在目标 时需 个输入态Bravyi & Haah 2012 (PRA)。
其它平台与码的账本
资源账本不是表面码专利:中性原子加重配置横向门的路线声称用约 物理比特跑 Shor(东拼西凑的横向门靠原子重排实现,见eastin-knill的绕过方案)2026 (arXiv);qLDPC 码以更高码率换连通度,批量高率逻辑操作协议给出另一套账(见qldpc-vs-surface与qldpc-hardware)2025 (arXiv);近期窗口的”够用就好”账本见 FLASQ 成本模型与early-fault-tolerance。