分区架构与横传门
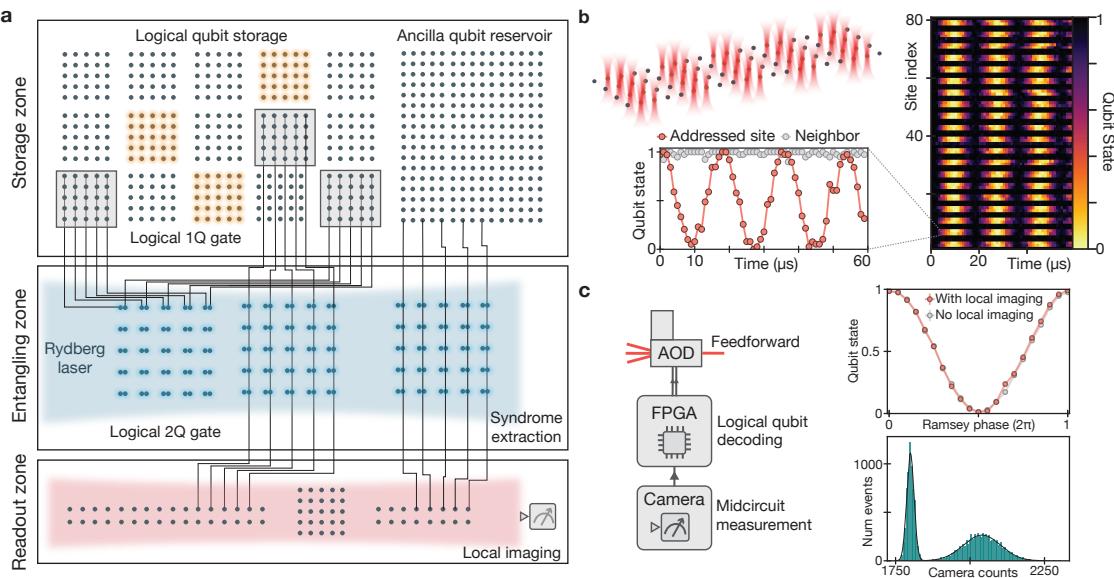
处理器把原子分成三个功能区:storage(存储)→ entangling(纠缠)→ readout(读出),光镊在区间搬运原子。所有逻辑单/双比特门用横传(transversal)实现——物理门逐比特作用于码块内对应位置,错误不在码块内扩散,天然容错(横传性的判据见transversal-gates)。两比特门的做法尤其高效:把两个码块的原子网格交错叠放,一次全局 Rydberg 脉冲同时完成整块横传 CNOT。
中途读出是分区架构的隐藏王牌:把选定原子移到读出区成像(500 µs),保真度 ≈99.8%,其余比特相干不受影响(串扰 p~10⁻³);FPGA 实时图像处理加前馈,让”测量-分支”的容错流程能跑起来。
相关译码:横传门的代价与红利
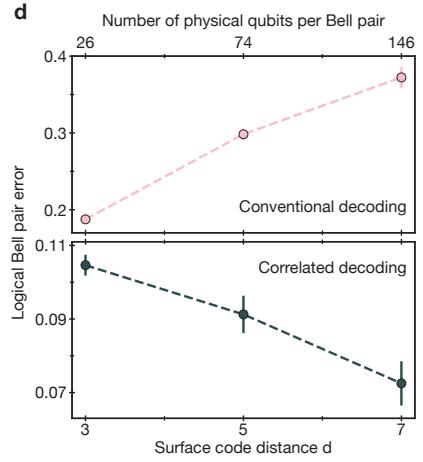
横传 CNOT 有一个结构性代价:物理错误会在两个码块之间确定性传播。Bluvstein 等把它变成红利——相关译码(correlated decoding):把两个码块的译码图用边/超边连接做联合译码,d=7 Bell 对的错误率显著低于独立译码。码距扫描(d=3→7)显示横传 CNOT 错误率随 d 单调下降,说明该电路已越过有效阈值。
规模演示:48 逻辑比特
两个数字值得并读:
- 深码距:d=3→7 的表面码块上横传门随距离改善;
- 大规模:40 个 d=3 颜色码(280 物理原子)分批”编码→存储→取用”,每增加一批仅引入 ~1% 逻辑退相干——规模与控制线不再互斥。
算法演示用 码块组成 48 逻辑比特的超立方连接采样电路(228 个逻辑两比特门 + 48 个逻辑 CCZ),带错误检测时 XEB 与 fast-scrambling 模拟优于物理比特直接执行Bluvstein et al. 2023 (Nature)。
可重构几何:中性原子的结构性优势
与固定布局的超导芯片相比,中性原子阵列的连接性由每次实验前重排光镊定义,带来三种自由度:
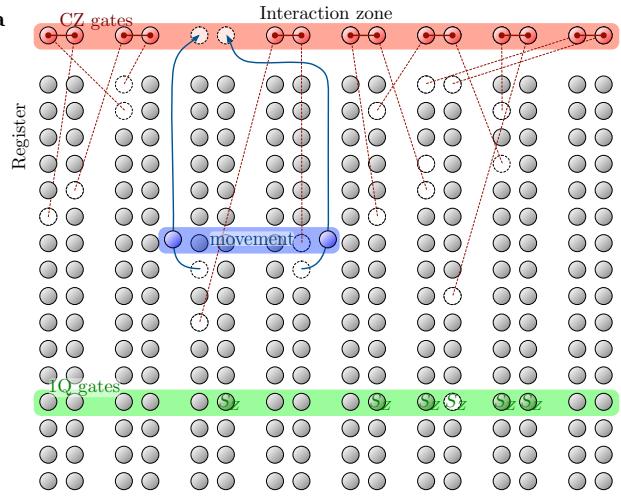
- 任意连接:非局域码(qLDPC)的校验图可以靠移动原子”摆”出来,不必靠长程布线;
- 换码距:同一台机器今天跑 d=3 的 48 逻辑,明天跑 d=7 的少数逻辑;
- 换码型:表面码、颜色码、乃至横传门需要的”网格交错”都是重排问题。
这个结构性优势是后续高码率 qLDPC 处理器路线(见qldpc-hardware)与”一万原子跑 Shor”资源估计的物理基础。
后续:2024–2026
- 微软+Atom Computing(arXiv:2411.11822):256 个 Yb 原子上的容错计算——关键错误源转换为原子丢失(成像可检),移动原子实现全连通;24 个逻辑比特(48 原子)纠缠的同时实时捕错并平均纠正 1.8 个丢失原子;Bernstein–Vazirani 算法在 28 个逻辑比特(112 原子)上错误率优于物理比特Reichardt et al. 2024 (arXiv)。
- 架构机制(arXiv:2506.20661):可重构几何 + 横传/传送操作 + 存储补位的系统化架构设计,是 48 逻辑处理器的正式蓝图Bluvstein et al. 2025 (arXiv)。
- Atom Computing toric 码(arXiv:2606.04079):首个任意深度可扩展的重复纠错中性原子演示——toric 码多周期综合征提取至 90 周期、中途测量+丢失比特补位、补充比特库(reservoir)重装载实现无限相干运行;两个码距对比至 8 轮,大码距的绝对逻辑错误率更低Atom Computing et al. 2026 (arXiv)。
- 资源估计(arXiv:2603.28627):配合高码率码与高效逻辑指令集,Shor 算法可压缩到 10,000 个可重构原子比特;26,000 比特系统上 P-256 离散对数只需数天Cain et al. 2026 (arXiv)(资源估计方法论见ft-resource-overhead)。
- 高码率 qLDPC 处理器(arXiv:2607.28795):mitten 码等非阿贝尔群构造把”可重构几何+高码率”推成处理器设计(见qldpc-frontier-2026)。
批判性平衡
中性原子路线的弱点同样明确:Rydberg 两比特门误差(~10⁻² 量级)仍高于离子阱与超导,靠横传+相关译码+后选择补;原子丢失是独有错误通道,需要擦除检测与补位(见neutral-atom-erasure);“48 逻辑比特”是 距离 2 的码,深码距下的多逻辑还有待补齐。它与离子阱(全连通、高保真、慢)、超导(快、近邻、深码距)构成三足鼎立,横向比较见qec-2026-state-of-art。