qLDPC 与表面码的开销对比回答一个工程问题:给定目标逻辑错误率与物理错误率,两条路线各要多少物理比特?账本结果一边倒地利好 qLDPC——BB 码 以 288 比特守住 12 个逻辑比特,同性能表面码需约 3000;Pinnacle 架构把 RSA-2048 分解压到 10 万物理比特以内,对比经典表面码估算的约两千万,缩减约 200 倍。但账本的另一面——长程耦合、译码吞吐、门实现——同样必须计入。
方法:开销账本
对比的公平做法不是看单个码参数,而是开销账本(overhead accounting):固定物理错误率 p 与目标逻辑错误率 ,分别数出两条架构达到目标所需的数据比特、校验比特、魔法态工厂与互联,加总成物理比特数。单一码层面的快速指标是复合参数 (同距离下的比特效率):gross code 给出 ,而任意距离的表面码恒为 1( 比特编码 1 个逻辑比特)——一个数量级的”单位效率”差是所有后续节省的源头Bravyi et al. 2023 (Nature)。
存储对比:288 对 3000
BB 码原文的旗舰对比: 码用 144 数据比特 + 144 校验量子比特(共 288),在 电路噪声下把每周期逻辑错误率压到 ,可支撑约一百万个综合征周期;要 12 个逻辑比特达到同等抑制,表面码方案需 12 片距离 12 的码片(每片 数据比特、连校验共 ),合计近 3000 物理比特——超过 10 倍节省(论文结论按同等抑制水平给出近 15 倍)Bravyi et al. 2023 (Nature)。
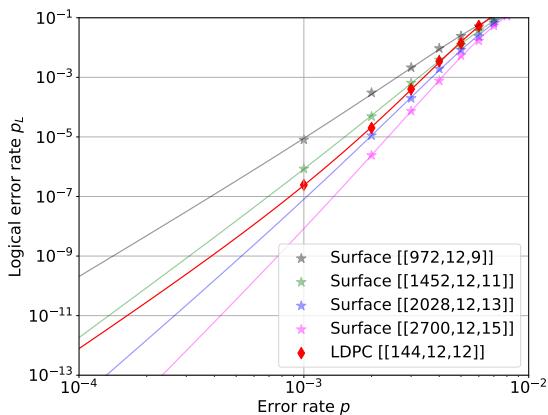
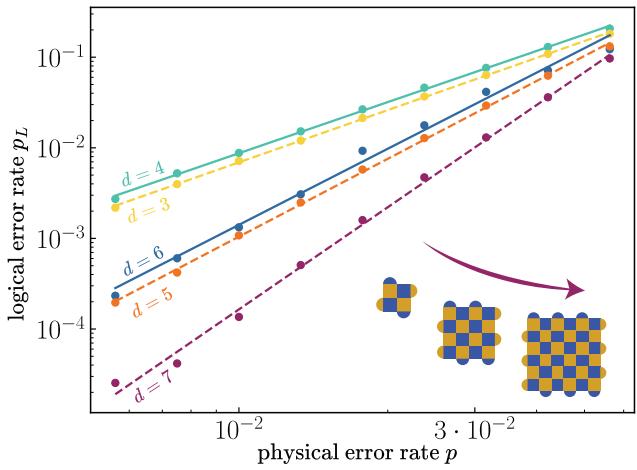
小码尺度上同样的账也成立:Postema–Kokkelans 的对比显示 BB 码与 4 片 旋转表面码纠错能力相当,后者需要 100 个数据比特Postema & Kokkelans 2025 (IEEE-IT)。
端到端架构对比:从 10 倍到 200 倍
存储只是账本的一页。自行车架构(Tour de gross)把 BB 码模块、LPU、T 工厂与适配器组成完整机器,端到端资源估计显示:同等物理比特数下可运行约 10 倍规模的逻辑电路,8138 个物理比特()即可触达 TFIM 模拟的应用区间Yoder et al. 2025 (arXiv)。Pinnacle 架构更进一步:桥接 GB 码块 + 广义手术 gadget + 单块内魔法态引擎 + Clifford 帧清洗,把 RSA-2048 分解压到 10 万物理比特以内(、码周期 1 μs、反应时间 10 μs),论文自比”此前最好”(约一百万物理比特的表面码改良估算)再省约 10 倍;对照 Gidney–Ekerå 2019 经典表面码估算的约 比特,累计约 200 倍缩减。其他点位:Fermi–Hubbard L=16 需 62k 比特(表面码分析 940k);1 ms 码周期(离子阱典型)时 1 个月任务需 310 万比特()Webster et al. 2026 (arXiv)。谱系一句话:(Gidney–Ekerå 表面码)→ 约 10 倍(BB/自行车)→ 再 10 倍(Pinnacle)。
计算侧(而非存储侧)的对比由 SHYPS 码补齐:任意 m 比特 Clifford 只需 个逻辑周期,深度 126 的编译电路在电路级噪声下接近纯存储性能——qLDPC 从”便宜的内存”变成”能算的内存”Malcolm et al. 2025 (Nat. Commun.)(见qldpc-logical-ops)。
批判性平衡:账本的另一页
数量级的节省不是免费的,至少四项代价必须诚实计入:
- 连通性:每比特 2 条长程边 + 双层布线(qldpc-hardware),长程耦合的保真度仍落后本地门(自行车架构引用的 0.6 m transmon 态传输实验保真度为 98.8%);
- 译码吞吐:BP-OSD 类译码比表面码 MWPM/UF 慢且无专用硬件传统,实时性靠 FPGA 与滑动窗口追赶(real-time-decoding);
- 门实现:表面码的晶格手术与横向门成熟,qLDPC 的逻辑门(自同构、传送、手术)仍在快速演化(qldpc-logical-ops);
- 噪声敏感性:高码率码的伪阈值对噪声结构(如测量噪声占比)更敏感,BB 码原文把”偏置噪声下的阈值变化”列为开放问题。
相反方向的平衡同样成立:表面码的 阈值、成熟译码与平面工艺是 20 年积累的资产;qLDPC 的账本优势要兑换成实际节省,前提是物理错误率已压到阈值以下且互联工艺达标。2026 年的判断是互补而非替代——存储密度敏感的场景 qLDPC 先行,通用计算的默认架构之争仍未定局(另见ft-resource-overhead与qec-2026-state-of-art)。