gross 码:从码到记忆
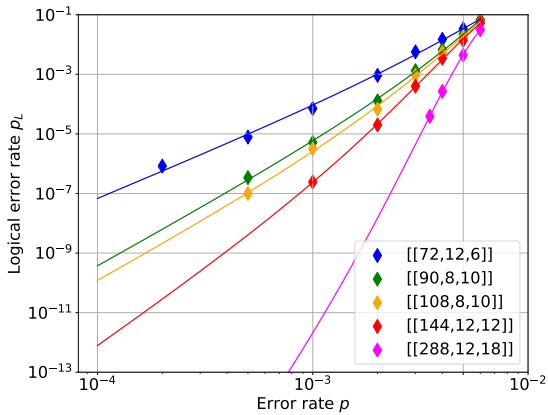
BB 码的构造(群环 上两个三项多项式生成校验矩阵、校验重量恒 6)与 的交换性论证在bivariate-bicycle中完整展开,这里只列实验相关的性能账: 时 的每周期逻辑错误率约 ,同等性能的表面码方案需要近 3000 个物理比特(>10× 节省);综合征提取周期恒为 7 层 CNOT,与码长无关;译码用 BP+OSD(见bp-osd-decoding)Bravyi et al. 2023 (Nature)。码族的代数理论与渐近坏性定理见 Postema–KokkelansPostema & Kokkelans 2025 (IEEE-IT)。
硬件演示状态:如实盘点
“IBM gross 码硬件演示”是 2025 年常见宣传语,但 arXiv 全文检索未找到独立的 IBM gross 码硬件实验论文(截至 2026-09)。IBM 系可引的 arXiv 证据是三块拼图:
| 组件 | 工作 | 性质 |
|---|---|---|
| 码与译码理论 | arXiv:2308.07915(Nature 627, 2024) | 理论+数值 |
| 模块化架构 | arXiv:2506.03094 Tour de gross | 架构+编译+资源估计 |
| FPGA 实时译码 | arXiv:2510.21600 | 译码硬件(gross 码存储器) |
| 纠错版计算 | arXiv:2505.09133 | 逻辑算法实验(Steane 码) |
锚点:BB 码理论见bivariate-bicycle,qLDPC 硬件落地全景(多层布线、长程耦合、中性原子布局)见qldpc-hardware,开销对比见qldpc-vs-surface。
FPGA 实时译码(IBM 作者,arXiv:2510.21600):在 FPGA 上对 gross 码存储器做实时 BP 类译码——Relay-BP 每迭代 24 ns、整个纠错周期 <1 µs,与超导周期时间对齐Maurer et al. 2025 (arXiv)。这回应了 qLDPC 的老质疑”BP+OSD 太慢做不了实时”;译码吞吐的完整讨论见real-time-decoding。
纠错版分子能计算(IBM+Quantinuum,arXiv:2505.09133):在 Quantinuum 离子阱上用 Steane 码加 Steane 型综合征提取 gadget,做误差缓解与纠错结合的分子能量相位估计Yamamoto et al. 2025 (arXiv)。注意这是 Steane 码而非 gross 码——它证明的是”IBM 的逻辑算法栈能在真机上跑”,不是 gross 码硬件化。
Tour de gross(arXiv:2506.03094):以 d=12/18 两个 BB 码为核心的模块化量子计算机设计——完整指令集、编译器与端到端资源估计;同比特数下逻辑电路比表面码方案大约 10×(换取物理比特数大减),见qldpc-vs-surface的账本对比Yoder et al. 2025 (arXiv)。
Starling 路线图:读法与边界
IBM 于 2025 年 2 月公布 Starling 路线图:2029 年交付 200 个逻辑比特、10⁸ 门规模的容错量子计算机,技术栈以 gross 码存储 + 晶格手术式逻辑操作 + 实时译码为主轴,后续机型再向百万级物理比特扩展。来源性质必须标注:这是官方路线图公告(IBM 新闻稿与白皮书),无 arXiv 论文锚点,不属于同行评审文献;其依赖的每个组件(长程耦合工艺、实时译码吞吐、逻辑编译)在 2026 年仍各有公开差距。路线图的价值在于把 IBM 的工程优先级写成可核对的清单,而非性能承诺。
批判性平衡
qLDPC 路线的收益与代价在 IBM 案例里最典型:收益是每逻辑比特的物理比特数( 指标远超表面码)与 0.8% 的宽容阈值;代价是校验重量 6 的非局域连接(多层布线或长程耦合器)、BP 类译码的实时吞吐、以及逻辑门比表面码晶格手术更陌生的指令集。2026 年的诚实记分是:码与译码的纸面优势已被反复验证,硬件侧的公开证据仍以 FPGA 译码与路线图为主——这与 Google 表面码(有硬件、开销大)、Quantinuum 高码率小码(有硬件、距离浅)构成三种不同的”证据结构”,横向比较见qec-2026-state-of-art。