延迟预算表
| 平台 | SEC 周期量级 | 译码预算 | 反馈需求 |
|---|---|---|---|
| 超导(Sycamore 系) | 约 1 µs | 每轮每码 µs 级 | Pauli 帧更新可延迟;中途反馈需亚微秒闭环 |
| 离子阱 | 1–5 ms | 毫秒级,宽松 | 传送/重排类协议依赖实时反馈 |
| 中性原子 | 亚毫秒–毫秒 | 介于两者之间 | 阵列重排可异步 |
两个指标分开算:吞吐决定平均意义下能否跟上(每 SEC 摊销的译码时间小于 SEC 本身);闭环延迟决定依赖测量结果的反馈(非 Clifford 门的中途测量、T 门传送)能否执行。backlog 问题恰恰出在两者的缝隙里——平均吞吐达标但峰值抖动超限,队列照样雪崩,因此延迟要看 p99.9 而非均值。
硬件路线:FPGA/ASIC 对 GPU/CPU
- FPGA/ASIC:时序确定、无操作系统抖动,适合闭环反馈路径与 Pauli 帧单元(PFU);代价是算力有限、开发周期长。
- CPU:算法足够快时最省事——sparse blossom 在 0.1% 电路级噪声下 表面码 两基单核低于 1 µs/轮,首次用单核跟上超导综合征提取速率,约每核每秒一百万个错误Higgott & Gidney 2023 (arXiv)。
- GPU/TPU:吞吐高,服务神经网络译码器与批量模拟;延迟抖动由流水线与窗口掩盖Senior et al. 2025 (arXiv)。
FPGA 神经译码闭环实验
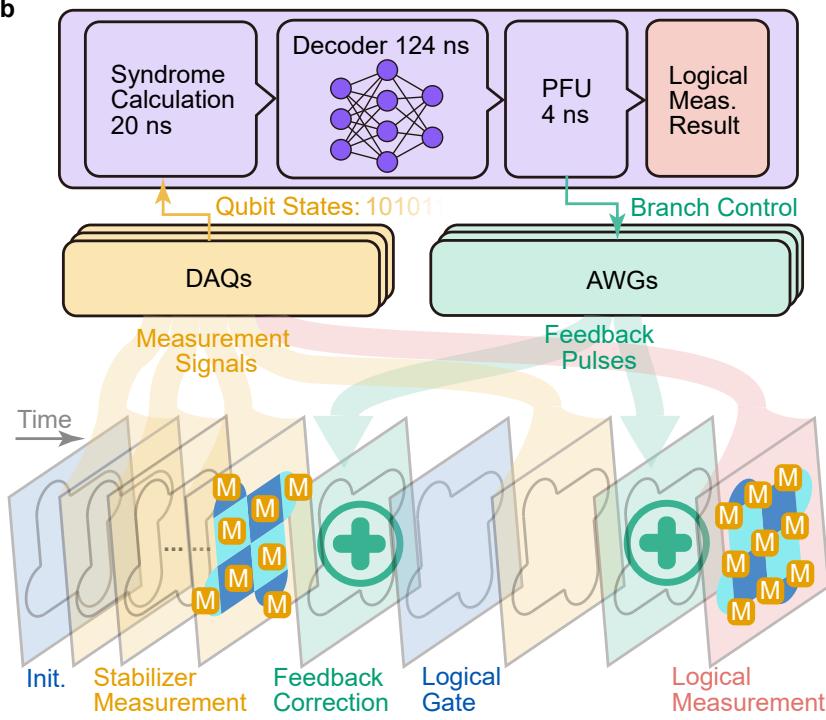
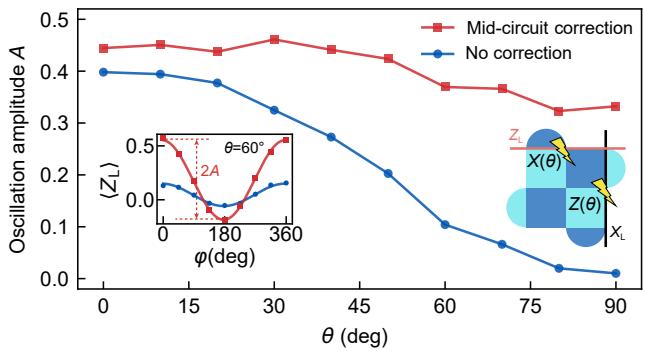
南方科大(IQA)2026 年实现首个 FPGA 神经网络译码器实时闭环纠错: 表面码、66 比特超导处理器。LSTM(32 隐单元)+稠密层, 两路独立译码器;Stim 生成训练集再实验数据微调;权重 6-bit 量化、激活函数简化、4 级流水线。250 MHz 时钟下译码确定性延迟 124 ns、吞吐周期 184 ns;完整闭环——读出→DAQ→综合征计算(CFM)20 ns→NN 124 ns→Pauli 帧更新(PFU)4 ns→任意波形发生器反馈——共 550 ns,快于 1.25 µs 的纠错周期。实时逻辑错误率 ,与离线 MWPM 的 相当,注入误差下鲁棒性亦相当;并在非 Clifford 逻辑电路中完成中途反馈Yang et al. 2026 (arXiv)。
窗口化、流水线与单 CPU MegaQuOp
大系统的做法不是把每轮都即时译完,而是窗口化(windowed)译码+批处理:把综合征流切成窗口,各窗口并行译码,译码吞吐预算按 SEC 摊销。IonQ 的端到端实时译码栈(含即时 DEM 生成、覆盖全部逻辑比特+逻辑操作+魔法态工厂的解码)在单个 CPU 上支撑 MegaQuOp 级负载:MIPT 等真实应用 408 逻辑比特、百万 T 门的基准;离子阱 1–5 ms 周期假设下, 时译码把计算拉长不到 0.3%, 时不到 12%Ye et al. 2026 (arXiv)。并行化谱系还有:自协调神经译码器让各窗口互相校准边界决策Zhang et al. 2026 (arXiv)、时间-空间双可扩展的 LATTE 架构Zhang et al. 2025 (arXiv)、HPC 集群上的实时译码Lao et al. 2026 (arXiv),以及亚微秒解码-反馈的开源 QEC 控制系统Liu et al. 2026 (arXiv)。
预解码
预解码(predecoding)思想在数据进主流译码器前先用极轻量的局部规则消化大部分平凡事件:Google 低于阈值实验用的 local predecoder 以微小延迟代价大幅压缩送入完整译码器的数据带宽与延迟Google Quantum AI 2024 (arXiv)。它与窗口化、流水线共同构成”分层消化综合征流”的实时架构观——每一层只做自己延迟预算内的事。
延迟里程碑一览
| 系统 | 平台 | 关键数字 | 属性 |
|---|---|---|---|
| sparse blossom | 单核 CPU | d=17 双基低于 1 µs/轮 | 吞吐指标 |
| FPGA 神经译码器 | FPGA 250 MHz | 译码 124 ns,闭环 550 ns | 闭环延迟指标 |
| 开源 QEC 控制系统 | FPGA/ASIC 栈 | 亚微秒解码-反馈 | 开源可复现 |
| MegaQuOp 译码栈 | 单 CPU | 408 逻辑比特,拉长 <0.3% | 端到端应用指标 |
| DeepMind 实时版 | GPU | 滑动窗口并行吞吐 | 神经译码实时化 |
这组数字说明实时译码不再是原理性障碍:超导节拍下 CPU 单核与 FPGA 都已达标,真正的开放问题移向大码规模下(数千逻辑比特、魔法态工厂全解码)的持续吞吐与自适应 DEM——译码图的生成速度本身也开始进入延迟预算(即时解码超图Ziad et al. 2026 (arXiv),另见transformer-foundation-decoding)。