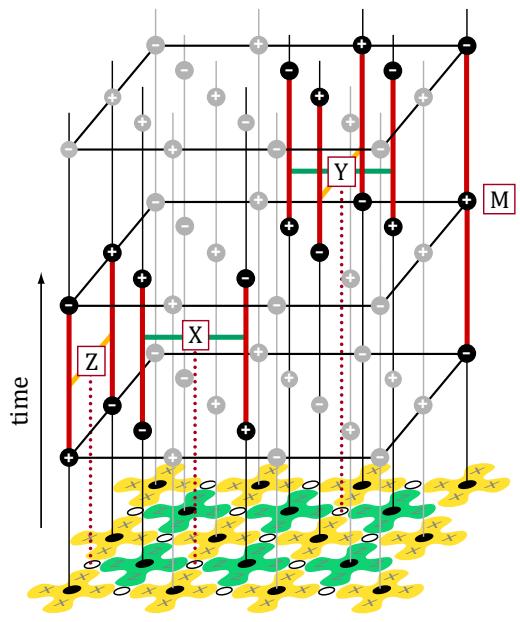
译码要做什么:从综合征到余等价类
设稳定子码的校验算符组 每轮给出综合征 。发生错误 后,译码器看到 ,要输出恢复算符 。量子译码与经典译码的本质差别在这里:只要 与真实错误落在同一”余等价类”, 就是稳定子或平凡逻辑算符,逻辑信息无损——恢复不必猜中错误本身,只需猜中错误的等价类。
把每个错误乘上全部稳定子生成的群 ,综合征为 的错误集合被划分成若干余等价类(coset)。编码单个逻辑比特时恰有四个类,Bravyi–Suchara–Vargo 记为 (恒等、逻辑 、逻辑 、逻辑 )Bravyi, Suchara & Vargo 2014 (PRA)。最大似然(ML)译码的目标是选后验概率最大的类:
其中类概率是整个类的概率之和:。对 CSS 码, 与 错误通常分别译码,各剩两个候选类。这个”类概率而非错误概率”的目标函数是简并码译码一切特殊性的根源(见degeneracy与ml-exact-decoding)。
三层噪声模型与各自阈值
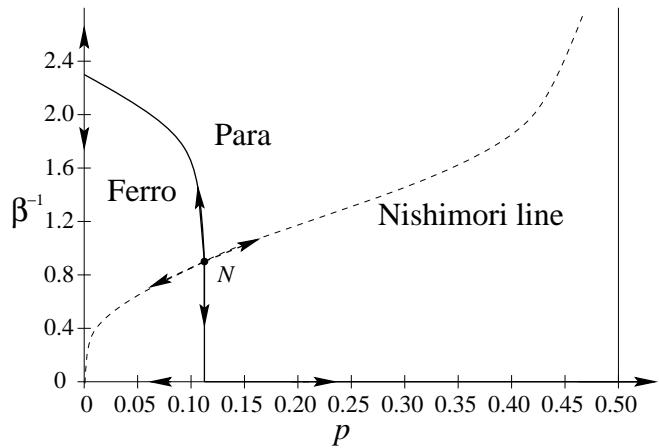
同一个码在不同噪声假设下的译码难度与可达精度完全不同,讨论任何阈值数字前必须先说清是哪一层:
| 层级 | 假设 | 表面码代表阈值 | 备注 |
|---|---|---|---|
| 码容量(code-capacity) | 数据比特独立翻转,测量完美 | 约 10.3%(MWPM)/10.32% 精确值 | DKLP 与 PyMatching 给出 |
| 现象学(phenomenological) | 数据与测量比特都独立出错 | 约 2.9%(MWPM) | 2+1 维时空图译码 |
| 电路级(circuit-level) | 完整门、 resets、读出噪声 | 约 0.5%–1%,随电路而异 | 现代实验的实际战场 |
码容量层的 10.3% 来自 Dennis 等的匹配映射Dennis et al. 2002 (J. Math. Phys.),PyMatching 论文给出更精确的 0.10321(1)Higgott 2021 (arXiv);现象学层约 2.9%Higgott 2021 (arXiv);电路级阈值依赖综合征电路细节,旋转表面码在标准 CNOT 电路下约 0.5%–0.7%(据 Gidney 等 2021 对蜂窝码的对照基准Gidney et al. 2021 (Quantum)),多数现代工作直接在 量级的工作点报告性能。阈值本身的统计力学内涵见surface-code-threshold。
五条路线的权衡矩阵
| 路线 | 核心思想 | 复杂度 | 精度定位 | 实时性 |
|---|---|---|---|---|
| MWPM 匹配 | 缺陷配对=最小权重完美匹配 | 最坏 ,sparse blossom 实测近线性 | 忽略简并与 X/Z 相关 | 单核已达 1 µs/轮 |
| Union-Find | 簇生长-合并+擦除译码 | 近线性 | 阈值比 MWPM 低约 4%(9.9% 对 10.3%) | 极快,可硬件化 |
| 张量网络 | 类概率=配分函数收缩 | , 控精度 | 近 ML,去极化下比匹配好两个数量级 | 离线基准为主 |
| BP+OSD | Tanner 图消息传递+高斯消去兜底 | 每 BP 轮线性,OSD 内 | qLDPC 事实标准 | GPU 可实时 |
| 神经网络 | 端到端学习噪声结构 | 推理快、训练贵 | 真机最高精度(AlphaQubit) | FPGA/GPU 实时化进行中 |
没有全能冠军:匹配与 Union-Find 胜在速度与可证明性,是表面码默认选择;张量网络与精确 ML 是精度天花板,用于校准其它译码器;BP+OSD 支撑 qLDPC 码族;神经网络吃进模拟量与真实硬件噪声,但要面对训练成本与泛化质疑Yan, Li & Du 2026 (arXiv)。各路线细节见后续词条。
简并性:量子译码为何 p 难
经典线性码的最大似然译码是 NP 完全问题;量子情形更糟——Chubb 指出理想(精确 ML)译码的复杂度升到 #P 完全Chubb 2021 (arXiv)。原因有二。其一,目标不是单个最概然错误而是整个余等价类的概率之和,这把”搜索”问题变成了”计数”问题;其二,简并性使得权重最小的错误不代表概率最大的类——一个高权重错误可能与大量低权重错误同类,类概率反超。因此所有实用译码器都是 ML 的某种多项式时间近似,衡量近似好坏的标准正是它们各自给出的阈值与逻辑错误率。简并性并非只添麻烦:它也让 Union-Find 这类”只求覆盖、不求最短”的算法天然适配量子码(见union-find-decoding)。