神经网络译码(neural network decoding)用学习到的映射替代手工算法:输入综合征历史,输出逻辑翻转的判断。Torlai 与 Melko 2017 年用受限玻尔兹曼机译 toric 码开了先河;此后十年形成 RBM→CNN→LSTM→GNN/Transformer 的完整谱系。它的独特优势是能吃进算法译码器难以利用的东西—— 错误的 X/Z 相关、模拟量软信息、真实硬件的噪声细节;2026 年南方科大的 FPGA 部署把神经网络译码延迟做到 124 纳秒。与此同时,训练数据随码距离指数增长、真实增益的度量等质疑也由同批研究者自己提出。
谱系:四代架构
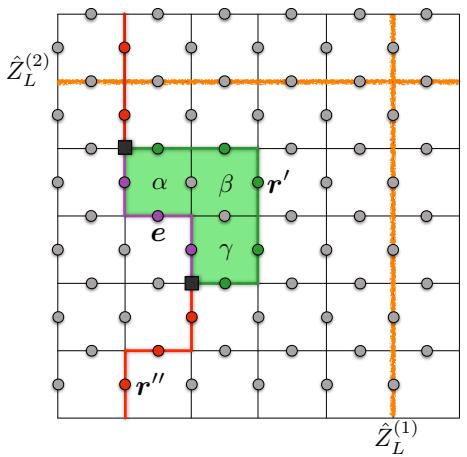
- RBM(2017):Torlai–Melko 的三层随机网络——综合征层 、错误层 、隐层 ,对称权重加外场,用对比散度学联合分布 。译码是条件采样循环:固定 ,交替采样 与 直到 。网络全连接、几何无关(不编码任何局域性),却能采样多条链统计同调类直方图——天然可改造为 ML 译码。2D toric 相位翻转噪声下,低于阈值区与 MWPM 几乎一致;高于阈值区更差Torlai & Melko 2017 (PRL)。
- CNN(2021–2022):Meinerz、Park 与 Trebst 的可扩展卷积译码器把网格几何编码进网络,能随码距离扩展训练,是”深度学习译码”路线的代表Meinerz, Park & Trebst 2022 (PRL)。
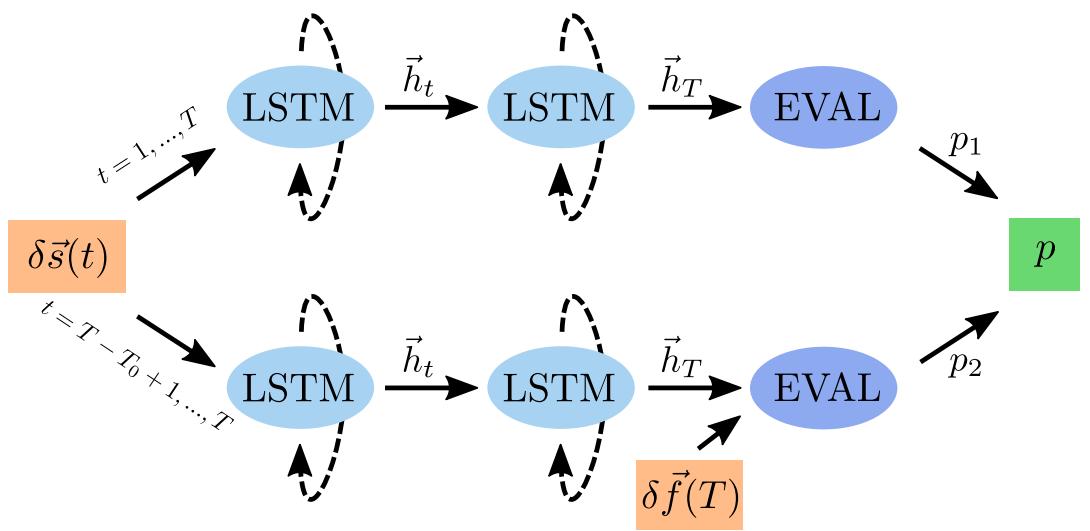
- LSTM/循环(2018):Baireuther 等的循环网络译码器引入记忆——输入是探测事件的时间窗历史(当前轮+缩短的历史窗,以处理含错测量),LSTM 隐状态跨轮传递。两个关键设计:一,只用实验可得数据训练(不需噪声模型先验);二,输出是单一校验位(logical parity bit)而非完整 Pauli 帧——Pauli 帧的真实值依赖数据比特测量结果的量子随机性,网络只预测可预测的部分(gauge freedom)Baireuther et al. 2018 (Quantum)。同组随后把该架构推广到 颜色码的电路级噪声Baireuther et al. 2019 (NJP)。
- GNN/通用框架(2025–2026):图神经网络把探测器图作为输入图,摆脱网格假设、适配任意稳定子码Hu et al. 2025 (arXiv);利用码对称性的通用译码框架见 USDsOhnishi & Mukai 2026 (arXiv);BB 码电路级噪声的机器学习译码Blue et al. 2025 (Quantum)与面向通用量子算法(而非纯存储)的神经译码器Bonilla Ataides et al. 2025 (arXiv)把适用面继续推开。
为什么能赢:Y 错误相关
Baireuther 等给出神经网络胜过 MWPM 的机理实验: 错误=同时的 ,匹配译码拆成两个独立问题丢弃了相关,神经网络直接学。固定 调大 的模型实验里,循环译码器误差全面低于 blossom;Surface-17 的密度矩阵电路模拟下每周期逻辑错误率 ,对 blossom 的 (多轮完美测量上界 ),数千轮稳定Baireuther et al. 2018 (Quantum)。
输入表征与训练
- 输入:探测事件(相邻轮测量结果的异或)优于原始测量;AlphaQubit 进一步加入软信息——I/Q 读出概率、泄漏概率等模拟量,传统译码器几乎无法利用Bausch et al. 2024 (Nature)。
- 训练数据:主流是 Stim 按 DEM 采样的模拟数据(标签为逻辑翻转位),再在实验数据上微调(见decoding-toolchain-benchmarks)。
- 端到端 vs 混合:端到端网络直接输出逻辑翻转概率;混合范式让网络学局部消息传递规则、逻辑奇偶校验由确定性后处理收尾(如 NTU-Neural-BP,见transformer-foundation-decoding)——把”必须满足综合征”的硬约束留给算法层。
部署:从 GPU 到 FPGA
南方科大(IQA)2026 年实现首个 FPGA 神经网络译码器实时闭环纠错: 表面码、66 比特超导处理器上,LSTM(32 隐单元)+稠密层、 两路独立,权重 6-bit 量化、4 级流水线,250 MHz 时钟下确定性延迟 124 ns、吞吐周期 184 ns,闭环(读出→综合征→NN→Pauli 帧更新→反馈)共 550 ns,快于 1.25 µs 的纠错周期;实时逻辑错误率 ,与离线 MWPM 的 相当Yang et al. 2026 (arXiv)(详见real-time-decoding)。
批判性平衡
神经译码的三笔账必须摆在一起算。数据账:训练样本需求随码距离指数增长——AlphaQubit 从 训到 需要百倍样本,外推 要 样本Bausch et al. 2024 (Nature)。泛化账:噪声模型漂移即需重训;RBM 在高于阈值区比 MWPM 更差Torlai & Melko 2017 (PRL)。增益账:Yan、Li 与 Du(NTU 团队自己)2026 年系统质疑 NN 译码器报告的增益有多少来自实验设置而非网络本身,呼吁在与最强算法译码器严格对齐的基准上重新计量Yan, Li & Du 2026 (arXiv)。这些批评没有否定路线本身,而是把它推向预训练+迁移+微调的基础模型范式。