AlphaQubit:架构与关键数字
架构按纠错轮迭代:一个时间不变的循环计算块(CNN+Transformer)逐轮消化测量结果,每个稳定子一个嵌入向量 直接加进 decoder state,输出为每个逻辑可观测量的翻转概率——校准过的概率输出可作置信度,支撑后选择Bausch et al. 2024 (Nature)。输入表征用测量结果+探测事件(比只用事件更易训练),并可无缝扩展软信息:I/Q 读出概率(以信噪比与归一化测量时间参数化的衰减模型)、泄漏概率——这些模拟量正是传统译码器难以利用的部分。
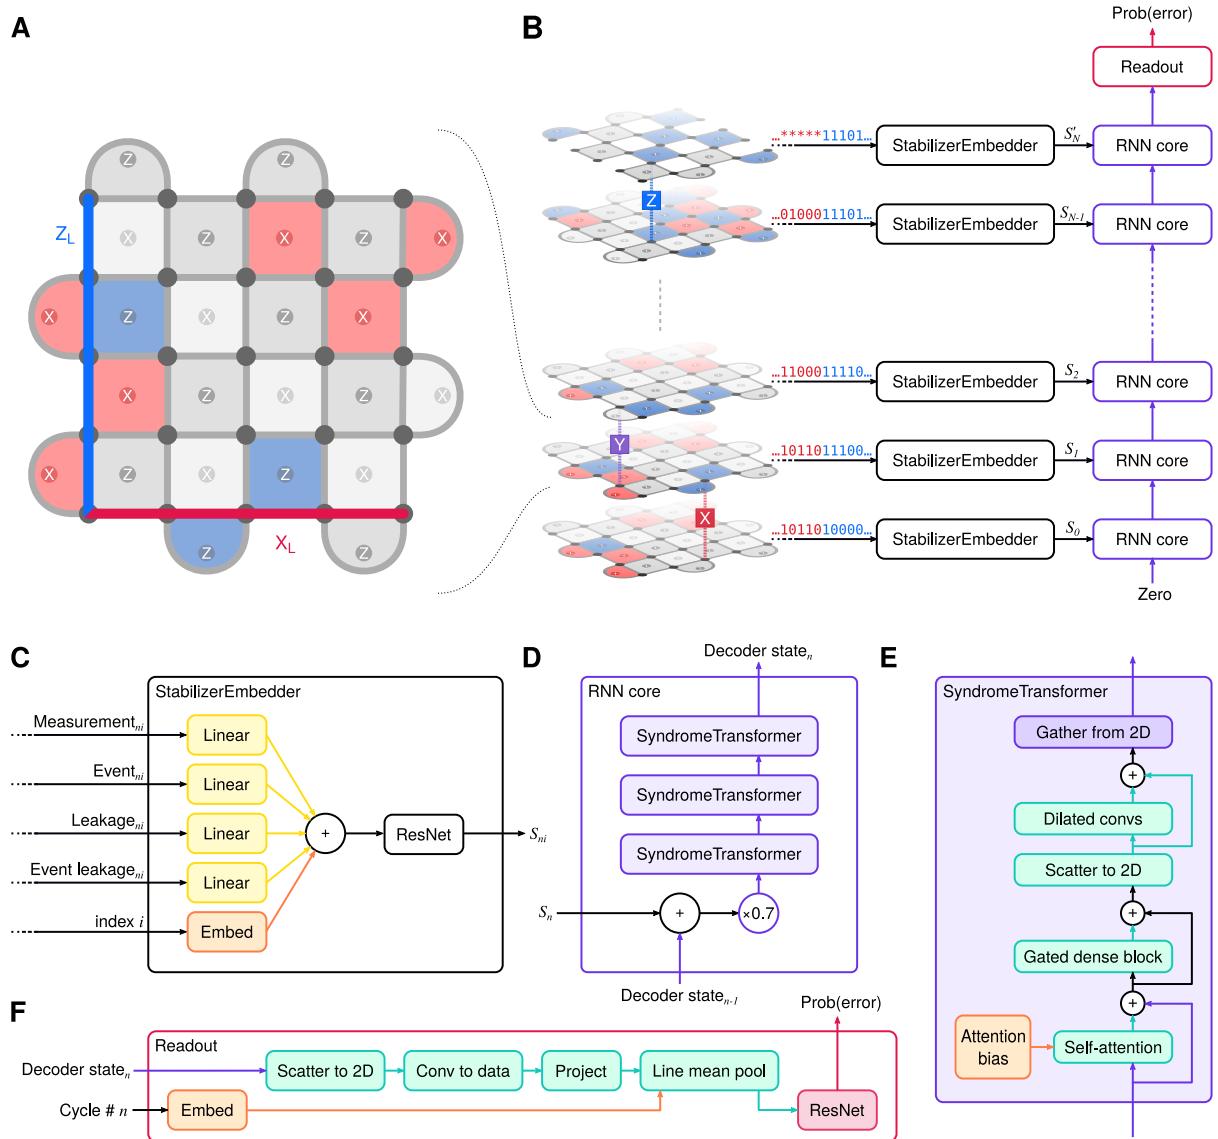
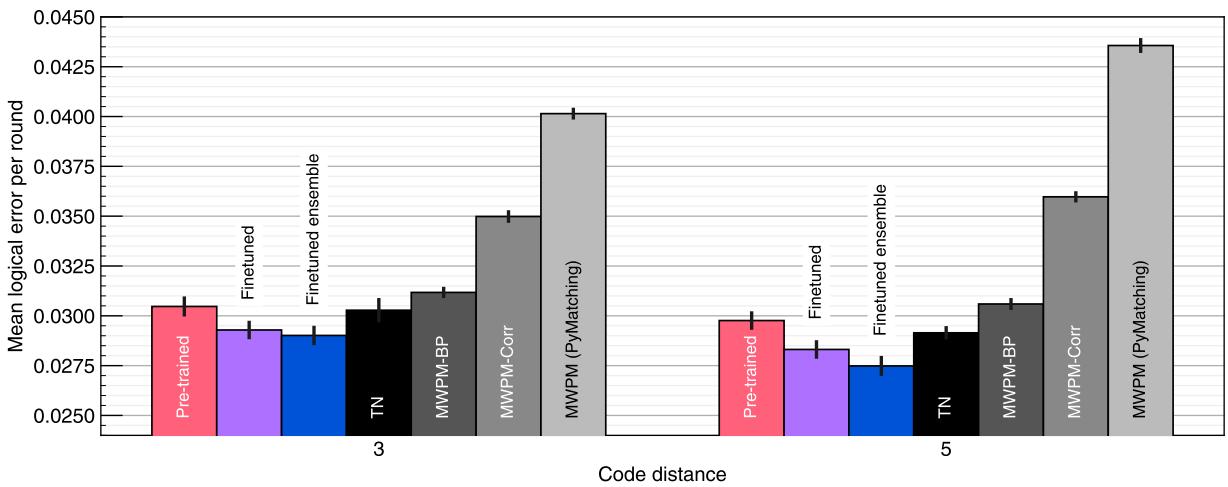
在真实 Sycamore 数据上( 与 ):逻辑错误率 与 ,均优于最强算法基线张量网络译码器的 与 ,误差抑制因子 对 。模拟(Pauli+ 噪声、SI1000 类) 时每轮逻辑错误率 ,优于相关匹配 MWPM-Corr 的 ; 全程 。抗泄漏: 泄漏下 逻辑错误率仅增约 30%(MWPM 增 60–80%)。置信度后选择:拒掉 0.2% 样本即可把错误率降约 10 倍(拒 10% 降约 250 倍)。最关键的鲁棒性证据:只用 25 轮训练,精度在 100,000 轮的连续纠错中保持——循环结构带来的时间外推能力Bausch et al. 2024 (Nature)。
训练数据指数墙与基础模型范式
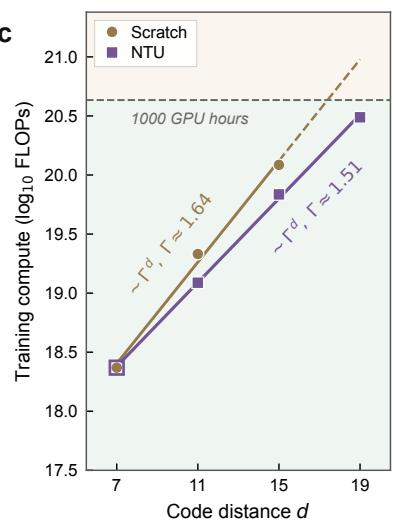
AlphaQubit 的训练协议是”Pauli+ 模拟数据预训练 + 实验数据微调 + 多模型集成”。但样本需求随距离指数爬升: 需要约百倍样本,外推 需要 量级样本——直接训练在大距离上不可行,必须转向”预训练一个基础译码器、到硬件上微调”的范式Bausch et al. 2024 (Nature)。这正是后续两条技术线的出发点。
NTU:用尺度不变性做跨距离迁移
NTU(neural transfer unification,NTU/SUTD 的 Yan、Li、Xiao 等)的观察是:表面码与准循环 BB 码的探测子代数坐标 在距离改变时平移不变——邻域模板 不随 变。于是架构解耦为尺度不变的局部感知 backbone(小码上学的参数直接搬到大码)+尺度相关的全局决策层(迁移后微调)+ 几何感知旋转位置编码(RoPE)。效果:训练计算指数 从头训练的 1.64 降到 1.51;冷启动平台期消失——从头训练的 模型 2000 步仍卡在 50% 精度,迁移初始化即刻收敛;()超过 correlation-aware matching,迁移到 超过标准匹配,BB 低错误率区超过 Relay-BPYan et al. 2026 (arXiv)。
实时化:滑动窗口与并行
AlphaQubit 原型并非实时译码器;DeepMind 2025 年 12 月的续作给出可扩展实时版本:滑动窗口并行、GPU 吞吐设计,面向拓扑码实时纠错Senior et al. 2025 (arXiv)。并行窗口的自协调版本(各窗口译码器互相校准边界决策)同期刊出Zhang et al. 2026 (arXiv);混合专家视觉 Transformer 则把架构开销进一步压缩Nguyen et al. 2026 (ISIT)。实时部署的完整图景见real-time-decoding。
RL 运行时:校准与计算合一
Google 与 DeepMind 2026 年发表于 Nature 的强化学习译码器走了更远的一步:探测事件流既用于译码,又作为 RL 智能体的学习信号,持续在线调整控制参数——校准与计算合一,免停机。策略从错误检测事件反推控制参数漂移(探测器到控制空间的敏感度映射);在 Willow 芯片的表面码实验中,注入漂移下逻辑稳定性提升 3.5 倍;合成全部技术后表面码与色码平均每周期逻辑错误率达 与 (当时的纪录值);数万控制参数的大码仿真验证了可扩展性。论文并论证:深低于阈值区仅靠计量学+定向校准将不可行,需要模型无关的 in-context 微调——QEC 自适应控制的新叙事Sivak et al. 2026 (Nature)。附录将该数据与 Sparse Blossom、Tesseract、AlphaQubit 式译码做了系统对比。
生态注脚与批判
即时解码超图(just-in-time decoding hypergraph)让译码图随电路在线生成,支撑自适应纠错Ziad et al. 2026 (arXiv)。批判侧,同属 NTU 系统的 Rethink 论文对神经译码器的真实增益提出系统性质疑(见neural-network-decoding):基础模型路线的算力账、泛化账与增益账仍需在严格基准上持续核验Yan, Li & Du 2026 (arXiv)。