现代译码研究跑在一套事实标准工具链上:Stim 负责高速采样综合征数据,detector error model(DEM)充当译码问题的通用接口,PyMatching、ldpc、Chromobius 等译码器即插即用,sinter 汇总基准结果。Gidney 2021 年的 Stim 论文是这套生态的起点—— 表面码(两万比特、八百万门、百万测量)15 秒分析完毕并以 1 kHz 起采样。与之配套的是一套约定俗成的基准方法学:阈值与 Λ 因子报告精度,p99.9 延迟与每 SEC 吞吐报告速度,足迹对比报告资源效率。
Stim:十五秒的 d=100
Stim 是稳定子电路模拟器,速度来自三件事Gidney 2021 (Quantum):
- Tableau 模拟:Aaronson–Gottesman CHP 方法的改进版——跟踪逆 tableau,把确定性测量的开销从平方降到线性;256-bit SIMD 与缓存友好的数据布局。
- 参考样本 + 批量 Pauli frame:先无噪声采一个参考样本;此后每个样本只存”相对参考的翻转信息”(Pauli 帧),测量结果=参考值与帧异或;1024 个帧按位打包并行演化,误差间隔按几何分布采样(均摊 )——不做完整量子态模拟就能批量出含噪数据。
- 结果: 表面码电路(约 2 万比特、800 万门、100 万测量)15 秒完成分析,采样速率从 1 kHz 起。
detector 与 DEM:译码问题的通用语言
Stim 贡献的两个概念重塑了译码器的输入格式Gidney 2021 (Quantum):
- detector:一组测量位置的 XOR,在无噪声电路下取值确定(通常为 )。它不问”哪个稳定子这一轮值多少”,只问”哪个应该确定的量翻转了”。
- detection event:取值翻转的 detector。所有现代译码器(匹配、UF、神经网络)的输入都是检测事件流而非原始测量。
- detector error model(DEM):把每种错误机制写成”翻转哪些 detector+翻转哪些逻辑可观测”的概率表——从电路到译码图的中间层,
--detector_hypergraph用稠密位打包的 XOR 同步计算(比稀疏集合快千倍)。sparse blossom 的”探测图”、神经网络训练数据的采样分布都从 DEM 派生。
配套工具:Crumble 可视化电路并手动编辑缺陷(调试噪声模型的利器);sinter 把多译码器、多噪声强度、多距离的基准跑成汇总表。
译码器生态
| 工具 | 内核 | 定位 |
|---|---|---|
| PyMatching 2 | sparse blossom | 表面码族匹配译码标准实现(Python 接口+C++ 内核) |
| mwpm 库(fusion blossom) | Rust 匹配 | Google 实验与 sinter 基准所用 |
| ldpc | BP+OSD 系 | qLDPC 码标准配置,Roffe 等维护 |
| Chromobius | 匹配+投影 | 颜色码译码器 |
| SweepContractor.jl | 张量网络 | 近 ML 精度基准 |
PyMatching 论文本身也是基准方法学的一次示范:local matching 变体在 时阈值与精确匹配一致(0.10321(1),现象学 0.0292)Higgott 2021 (arXiv);BP+OSD 的系统化论文则以 ldpc 包落地Roffe et al. 2020 (PRR)。
基准方法学
报告一个译码器至少要交代四类数字:
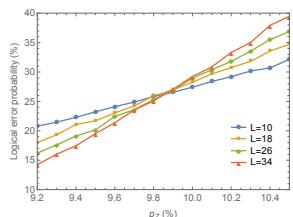
- 阈值(threshold):逻辑错误率曲线随物理错误率增长时的交汇点——低于它,码越大越好。附图即典型画法:不同距离的逻辑错误率随噪声强度的曲线族交汇于阈值。PyMatching 给出 toric 码 0.10321(1) 的精确匹配阈值与 0.0292 的现象学阈值Higgott 2021 (arXiv);BP+OSD-CS 的 toric 阈值 9.9±0.2%Roffe et al. 2020 (PRR)。
- Λ 因子:距离每增加 2 的逻辑错误率抑制比——Google Willow 用 表征低于阈值运行(见google-willow);AlphaQubit 报告 ()Bausch et al. 2024 (Nature)。
- 速度:吞吐(错误数/秒/核,如 sparse blossom 的百万级Higgott & Gidney 2023 (arXiv))与延迟(含 p99.9 尾部;实时系统看闭环延迟,见real-time-decoding)。
- 足迹(footprint):达到目标逻辑错误率所需的物理比特数——VibeLSD 正是用足迹对比宣布颜色码追平表面码Koutsioumpas et al. 2025 (arXiv)。
大系统基准的端到端样本:IonQ 的 MegaQuOp 译码栈报告”译码把计算拉长的百分比”( 时 <0.3%)作为面向应用的汇总指标Ye et al. 2026 (arXiv)——这大概是未来工具链报告的最自然语言:不问译码器多快,问它让量子计算机慢了多少。