cycle benchmarking:Pauli 谱与 SPAM 鲁棒
Erhard 等 2019 年的循环基准测试(CB)面向固定 Clifford 目标循环 :把 夹在 个随机 Pauli 循环里构成”dressed cycle”,制备 本征态、末测 本征值。过程保真度按 Pauli 分解
其中 是含噪实现; 随长度 指数衰减 ,每个 Pauli 的衰减率 恰是 Pauli 信道的特征值——整套 给出完整 Pauli 噪声谱,而随机化把非 Pauli 成分”缝”进等效 Pauli 信道Erhard et al. 2019 (Nat. Commun.)。实验(Innsbruck 离子阱 10 比特)证明采样开销与比特数无关: 个 Pauli 即可把 估到 的不确定度;4 比特上穷举 255 个 Pauli 验证收敛;交织 MS 门误差 /耦合对。CB 的 SPAM 鲁棒性来自随机化夹层——初末态误差不进入衰减率。
logical RB
Combes、Granade、Ferrie 与 Flammia 2017 年提出逻辑随机基准测试:对逻辑 Clifford 门集做标准 RB,测逻辑门错误率;难点在逻辑空间有非平凡结构(逻辑门集在码空间上的作用可能与物理 Pauli 群纠缠),需要码切换或随机化处理Combes et al. 2017 (arXiv)。逻辑 RB 与 CB 是互补的:前者按门集计分,后者按循环计分——这正好引出下一个问题。
陷阱一:每周期还是每门
逻辑错误率的分母选择不是排版问题。表面码架构的逻辑操作以纠错周期为节拍,Google 的逻辑量子比特错误率(每周期每比特)沿用的是 CB 的 per-cycle 视角Erhard et al. 2019 (Nat. Commun.);而与物理门、与算法门数比较时又需要 per-gate 口径。一个周期含 6–8 个时间步、若干次综合征提取,两套分母换算出的”逻辑错误率”可以差数倍到一个数量级——跨论文比数字前必须先对齐分母(以及周期时长、码距、噪声模型),这也是decoding-toolchain-benchmarks反复强调的口径问题。
陷阱二:kickback 层析与相干噪声
魔法态培育实验催生了新的表征协议。Google 2025 年的 kickback tomography(KT)用培育电路自身当测量装置:培育的相位反冲把 的误差转移到可测的 helper 比特上,单电路自洽地给出 误差上界,把投影噪声需求从约 shots 降到 量级Google Quantum AI 2025 (arXiv)。
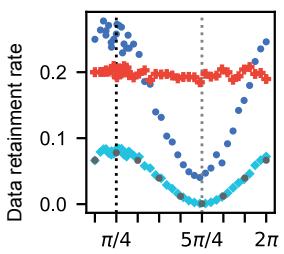
KT 存在的动机正是后选择层析的陷阱:相干噪声下,后选择后的态层析可以给出非物理的 Bloch 矢量(范数小于 1 却指向错误方向,或后选择偏置把纯度伪装成保真度),而 Pauli twirling 的可靠性没有保证——Google 的补充材料里有纯态反例。任何”先过滤再层析”的协议都要过这一关。
陷阱三:名义距离不等于 fault distance
Wan 与 Zapirain 的精确计算给出第三个教训:培育电路的名义码距(d=3/d=5)与真实 fault distance(2/3)不一致——d=5 培育电路逻辑误差率级数的首项是 而非 ,因为双故障路径在测量后选择下未被完全压制Wan & Zapirain 2026 (arXiv)。他们用 Pauli 传播加二进制张量收缩(模算术精确分数与 的 10 阶级数两种算术)算出 时 d=5 培育的接受率 14.395%、逻辑误差率 ,且 首项在该工作点不足总值一半——高阶项不可忽略,用首项外推会系统性低估误差。
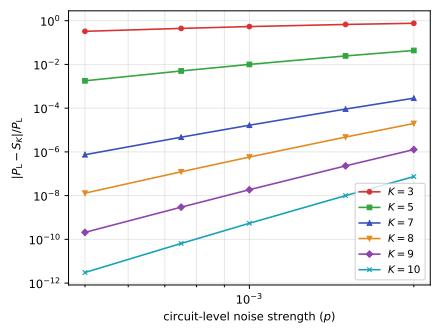
对基准测试的含义:报告”逻辑错误率”时必须同时报告它相对哪个 fault distance 标度,仅引用码的名义距离会高估压制能力。逻辑错误率的测量与译码器质量纠缠在一起,相关基准见decoding-toolchain-benchmarks;实验侧的里程碑数字见logical-records-timeline。