Union-Find 译码器(UF decoder)由 Delfosse 与 Nickerson 于 2017 年提出,首次把拓扑码译码压到近线性时间 ( 为反 Ackermann 函数,实际不超过 3)。它的核心洞察是:量子码的简并性允许译码器放弃”找最短错误链”,只需求一个覆盖错误、又不含逻辑算符的连通边集——这件事用并查集的簇生长-合并就能做到。代价是阈值略低于 MWPM(相位翻转 9.9% 对 10.3%),换来的是极简结构、天然并行与对擦除噪声的完美适配。
两阶段算法:验证再剥离
UF 译码分两步Delfosse & Nickerson 2017 (arXiv):
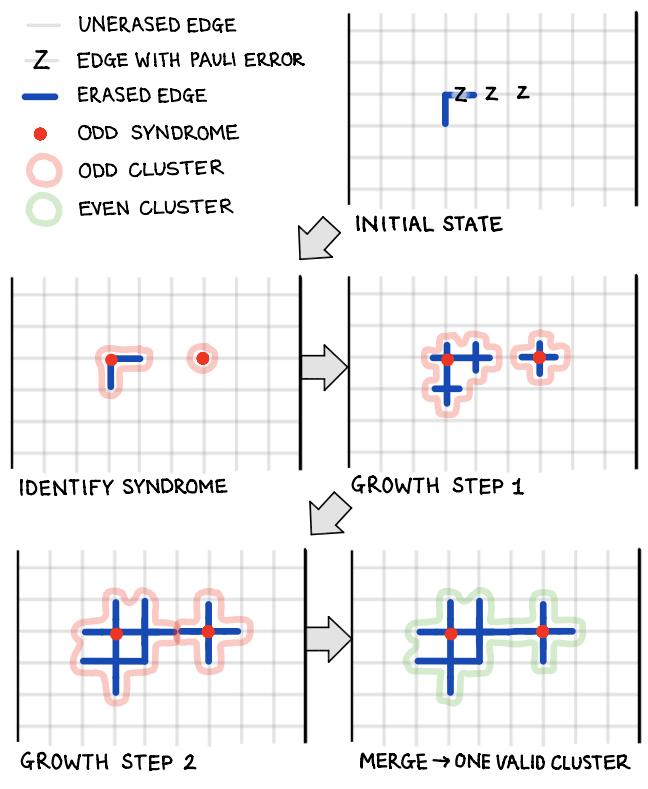
- 综合征验证(syndrome validation):初始每个缺陷自成一簇;每轮所有”奇簇”(含奇数个缺陷的连通分量)同步生长半边(half-edge);两个簇相遇即合并(Union);两个奇簇合并成偶簇即视为”验证通过”,移出奇簇列表。全部簇变偶后,把完全长成的边并入扩充擦除集 。
- 剥离译码(peeling decoder):把 当作擦除错误,用经典的 peeling 算法求出满足综合征的具体恢复。
奇偶判据与正确性定理
引理(奇偶判据):连通边集 上存在产生综合征 的 错误,当且仅当 的缺陷数为偶数。证明只需一个观察:每个 错误恰翻转两个缺陷,故簇内缺陷数必为偶。这个判据正是”奇簇必有一条错误链伸出”的根据——奇簇不可能自洽,必须继续生长Delfosse & Nickerson 2017 (arXiv)。
正确性定理:设真实错误为 个擦除比特加 个 Pauli 错,只要
UF 译码必然纠对。论证:每个 Pauli 错最多把两个奇簇各驱动一次生长,故生长至多进行 轮,最大簇直径 ;于是最终擦除集覆盖了全部错误、又不含任何非平凡逻辑算符,peeling 在这样的擦除集上必然成功Delfosse & Nickerson 2017 (arXiv)。
近线性的来源:数据结构
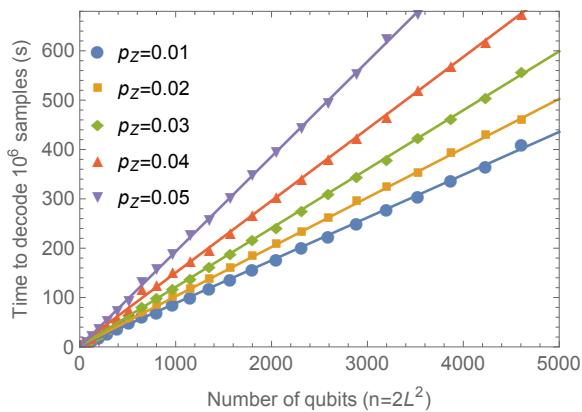
UF 的复杂度全靠三件并查集武器:簇树(cluster tree,任意根节点存 size+parity,奇偶查询 )、加权并(总把小树挂到大树根下,每次 Union 使小簇规模翻倍)与路径压缩(Find 后把路径上节点直连根)。Tarjan 1975 年定理给出加权并+路径压缩的总代价 ,且 Fredman–Saks 证明这已是最优;边界表(boundary list)避免每轮重扫簇边界。实测平均运行时间随码规模严格线性(C 实现、单核 2.9 GHz)Delfosse & Nickerson 2017 (arXiv)。
阈值与加权生长变体
均匀生长的 UF 在 2D toric 码完美测量下阈值为 9.2%。加权生长(weighted growth)变体每轮优先生长边界最小的簇(大边界簇乱加边会引入更多”错误”擦除),把相位翻转阈值提到 9.9%(MWPM 为 10.3%);含错测量的现象学阈值 2.6%(MWPM 2.9%);配合 Delfosse 投影法译码 颜色码阈值 8.4%(MWPM 8.7%)Delfosse & Nickerson 2017 (arXiv)。约 4% 的阈值损失换来了速度与结构简单。算法不依赖几何:双曲码、任意维度无需改动;后续还有 evolving、weighted 等加速变体,而匹配类译码的速度极限仍在被继续推进——2026 年已出现 sparse blossom 的亚常数摊销时间版本Mikami & Yamasaki 2026 (arXiv)。
为什么天然适配擦除信道
定理里擦除只计一次而 Pauli 错计两次——UF 对擦除噪声的容忍度天生高一档。这对擦除占主导的硬件极具价值:光量子比特的光子损失、超导比特的泄漏(leakage)都可转换为擦除错误再交 UF 处理。中性原子的擦除转换实验(见neutral-atom-erasure)正是这条路线的硬件落地;对一般码族的稳定子辅助失活译码把擦除信息并入译码图,进一步压缩逻辑错误率Pech et al. 2026 (ISIT)。