精确最大似然(maximum likelihood,ML)译码是译码问题的理论最优解:在全部余等价类中选后验概率最大者。它几乎从不可直接计算——简并性把问题从经典 ML 译码的 NP 完全抬高到 p 完全——但它的两个侧面都极有价值:正面,比特翻转噪声下的表面码有 matchgate 归约的 精确算法,张量网络方法给出可控近似;侧面,Dumer、Kovalev 与 Pryadko 的”能量最小译码”框架证明了简并 qLDPC 码在 ML 下阈值存在的一般条件。工程上它是校准一切实用译码器的精度上界与离线基准。
目标定义:选最大的类,不是最像的错误
设综合征 把错误空间切成余等价类 。ML 译码输出
对单逻辑比特即比较 四个类的概率和Bravyi, Suchara & Vargo 2014 (PRA)。简并性使”最小权重错误”≠“最大类”:一个高权重的代表元可能与指数多条低权重错误同类,类概率反超最短链——这正是 MWPM 类算法精度损失的根源,也是精确 ML 值得追求的原因。
复杂度:从 NP 到 p
经典线性码的 ML 译码是 NP 完全;量子情形要给整个 coset 的概率求和,理想译码的复杂度升到 #P 完全Chubb 2021 (arXiv)。因此”精确 ML”只在特殊结构下可行(下两节),一般场景靠近似谱系:张量网络( 截断,见tensor-network-decoding)、 个最小权重匹配采样的 K-MWMLin 2025 (PRA)、截断自由能展开Liu et al. 2026 (arXiv)。
高效特例:matchgate 的
Bravyi–Suchara–Vargo 证明:比特翻转噪声下,表面码类概率的配分函数可映射为 1D 链的 matchgate(费米子高斯)电路模拟,精确 ML 在 完成。此情形下 MWPM 与 ML 差距在 2 倍以内——纯 (或纯 )噪声下简并性危害有限;去极化噪声下 MPS 近似 ML 则比匹配好两个数量级以上Bravyi, Suchara & Vargo 2014 (PRA)。
阈值存在性:能量最小译码
Dumer、Kovalev 与 Pryadko(DKP)回答的是另一个问题:哪些简并码在(理想 ML 或其近似下)有正阈值? 他们的框架把纠错、擦除与含错测量统一进一个界Dumer, Kovalev & Pryadko 2015 (PRL):
- 能量最小译码(energy-minimizing decoding):完整 ML 等价于最小化自由能(能量+熵);DKP 只最小化”能量” ——忽略简并熵项的更简单目标。关键定理:只要”坏错误集”(译码后逻辑出错)的概率和在能量最小译码下收敛,同一界对完整 ML 也成立——简化目标不损失阈值的可证性。
- 不可约算符(irreducible operators):把每个错误类关联到去掉冗余后的最短代表元 ,坏事件化为对可数个 的概率求和;阈值条件即该级数收敛。
- 擦除界:等效距离 、稳定子权重上限 时,可容擦除率
- 由此得到: 的码族即可有有限阈值——亚线性距离的”坏”码在 ML 下照样容错;该界比 percolation 型论证参数更优Dumer, Kovalev & Pryadko 2015 (PRL)。
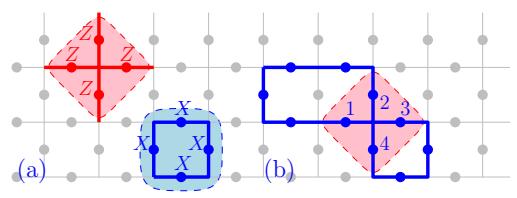
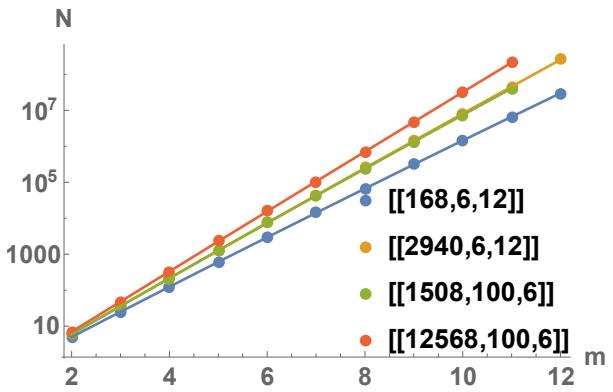
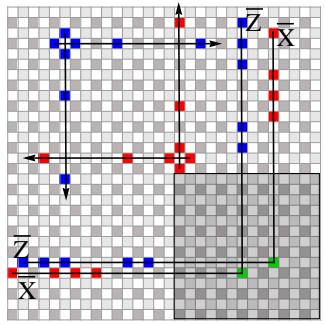
前奏是 Kovalev–Pryadko 2013:超积型”坏”qLDPC(速率有限、相对距离趋于 0)在 ML 译码下有有限阈值——错误分离成小独立簇的 cluster 定理论证;测量错误用辅助经典码把时间层缝合成 3D 图 再分析Kovalev & Pryadko 2013 (PRA)。这条理论线是后来”好码不必好距离”的 qLDPC 复兴(见qldpc-overview与good-quantum-codes)在译码侧的根据。
何时值得做精确 ML
可行场景清单:小中规模码的离线精度基准(AlphaQubit 用张量网络译码器作最强算法基线Bausch et al. 2024 (Nature))、比特翻转模型的理论研究、色码等小码族的阈值标定、以及作为近似 ML 方法(K-MWM、截断自由能)的对照真值。不可行场景同样明确:电路级噪声、大距离、实时约束——那里的战场属于本卷其余词条。