merge:稳定子合并规则
设两块 patch 的稳定子集合为 、。rough merge 在两面的 rough 边之间插入一行新数据比特(制备 ),随后把整体当作单一表面做 轮纠错——稳定子集合变为 加上跨接边界的新 X 稳定子,而这些新稳定子的乘积恰是 :merge 的逻辑效果就是测量 。smooth merge 对偶地在 smooth 边之间插入 行,测量 Horsman et al. 2012 (NJP)。
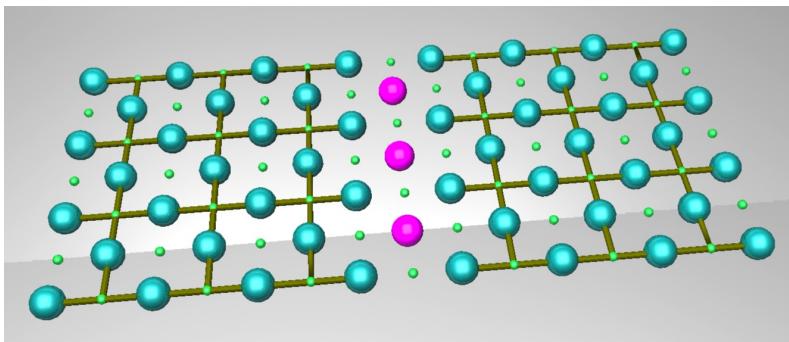
两 patch 均处计算基时,merge 结果的经典真值表是 XOR:测量值 ;smooth merge 则在 Hadamard 基做 XOR。后测量态按结果条件映射(奇偶重排),每个结果分支上恢复确定的编码态;merge 不改变码距(最短错误链长不变),完整容错需 轮纠错给足时空体积。
| 操作 | 中间行制备 | 测量算符 | 真值表(对应基) |
|---|---|---|---|
| rough merge | 计算基 XOR | ||
| smooth merge | Hadamard 基 XOR |
split:逻辑算符的分裂
smooth split 把中间行数据比特在 基测量移除: 保持为单一逻辑算符, 则分裂到两个面上——拆分后的两块 patch 处于 纠缠态(编码单比特的纠缠对)。边界处三体 稳定子的读数需与测量结果做奇偶配对追踪(或物理配对修正)。rough split 对偶(保 分裂 )。对称分裂使距离减半:要得到两个距离 的面需从 面出发;split 不损失逻辑信息,可用反向 merge 恢复Horsman et al. 2012 (NJP)。
CNOT 的四步构造
控制面 与目标面 各距离 ,中间放制备 的 INT 面Horsman et al. 2012 (NJP):
- smooth merge 与 INT(读出 ,结果 由软件追踪相位修正);
- smooth split 回两面;
- rough merge INT 与 (测量 );
- X 基测量 INT——三个测量结果联合给出确定性的 CNOT。
每步 轮纠错、任何时刻码距不低于 。原始论文还给出优化:控制面制备成 时第一步可省,split 与第二 merge 相互对易可并行,总轮数与编织方案持平。
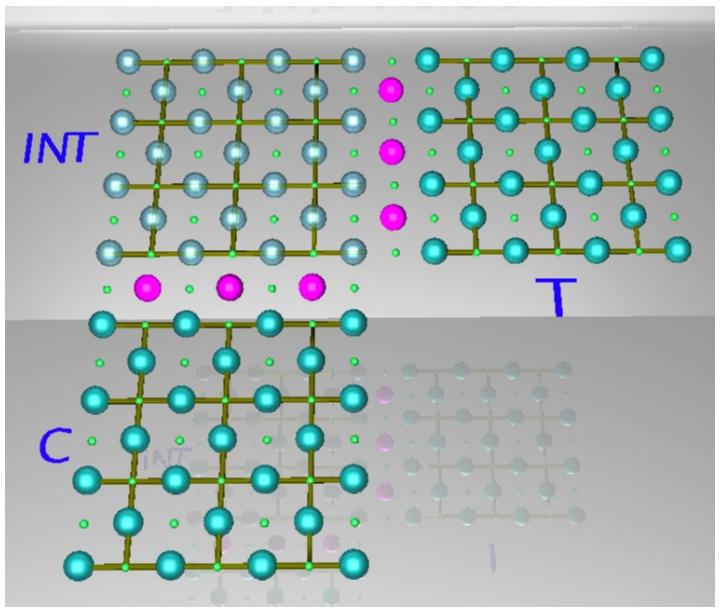
资源对比:d=3 CNOT 在旋转布局下共 53 个物理比特(33 数据加 20 测量),约为已知最小编织方案(104–143 比特)的一半;大面积下晶格手术 CNOT 的截面 对比双缺陷编织 ,缩小约 6 倍,但可扩展布局要预留空白面(只有约四分之一的面存数据)Horsman et al. 2012 (NJP)。
贴砖游戏:Litinski 的抽象层
Litinski 把晶格手术计算抽象为贴砖游戏:patch 初始化与单面测量 0 步,两面测量( 型)、任意形状辅助面的多面测量( 型)与 patch 变形各 1 步,1 时间步 轮码循环;一个距离 的方形 patch 含 个物理比特,时空成本主阶为 (物理数据比特乘码循环数)Litinski 2019 (Quantum)。电路先用对易规则改写成 Pauli 积旋转 ( 等),全部 Clifford 推到末端被最终 Pauli 测量吸收,剩下 旋转层由蒸馏块供给的 态经传送消耗。时空权衡三级示例( 个 门、、1 µs 循环):紧凑布局 5.5 万物理比特跑 4 小时;10 个蒸馏块 12 万比特 22 分钟;Fowler 式时间最优并行则用 3.3 亿比特 1 秒。与编织方案相比,蒸馏块布局节省约 90% 时空体积Litinski 2019 (Quantum)。
延伸与现状
晶格手术已从协议语言变成实验对象:2026 年国产超导团队在处理器级实现了晶格手术逻辑操作Wang et al. 2026 (arXiv);理论侧的推广包括多比特晶格手术(multiqubit lattice surgery,一面辅助 patch 同时测多面的 Pauli 积)2025 (arXiv)与向 qLDPC 码的移植2026 (arXiv)。魔法态注入的 merge 长大构造见magic-state-injection;把周期性综合征提取与 hook 传播一起设计的工程细节见ft-ec-cycle。