输入侧:态制备的 Θ(2ⁿ) 下界
个量子比特的振幅编码可容纳 个流场自由度(见state-preparation),但装填不免费:Shende-Bullock-Markov 证明合成任意 比特态需要 个 CNOT 门,且这是下界Shende et al. 2004 (arXiv)。也就是说,把一个”一般”的经典场写进振幅,代价与经典模拟同阶——指数容量在装填环节就被没收。可行的出路是只装可高效制备的数据类:
- 光滑/解析函数(Fourier 或多项式基系数稀疏);
- 张量网络可压缩的低秩场(MPS 态制备代价随键维数多项式增长,见tensor-network-fluids);
- QRAM 类预言机支持的随机访问(下文)。
Tennie 等综述把初态制备列为四大前提挑战之首,并对比角度编码( 个值要 比特,但制备便宜)与振幅编码( 比特,但制备昂贵)的基本权衡Tennie et al. 2024 (Nat. Rev. Phys.)。
QRAM 之辩
量子随机存取存储器(QRAM)承诺 地装入 个经典数据,是许多块编码算法(见block-encoding)的隐含前提。争议在于硬件:近年判断认为”廉价、可扩展的无源 QRAM 在现有提案中不太可能”实现。Tennie 等的立场是——QRAM 是一切实用量子计算的共性需求,而非湍流问题特有的额外负担;不能拿 QRAM 的困难单独否定量子 CFD,但端到端账本里必须如实记上Tennie et al. 2024 (Nat. Rev. Phys.)。工程侧的替代思路是本源量子的子空间迭代:把问题切成量子硬件装得下的小块,避开一次性大数据装载Ye et al. 2024 (PoF)。
输出侧:层析、隐含假设与泛函读出
全态层析(quantum tomography)需 组测量设置与样本,直接对应”重构整个流场”——通常不可行。HHL 的复杂度声明默认输入 与输出 都以振幅形式存在、不读出Harrow et al. 2009 (PRL);把这个隐含假设搬到 CFD 时必须显式披露。
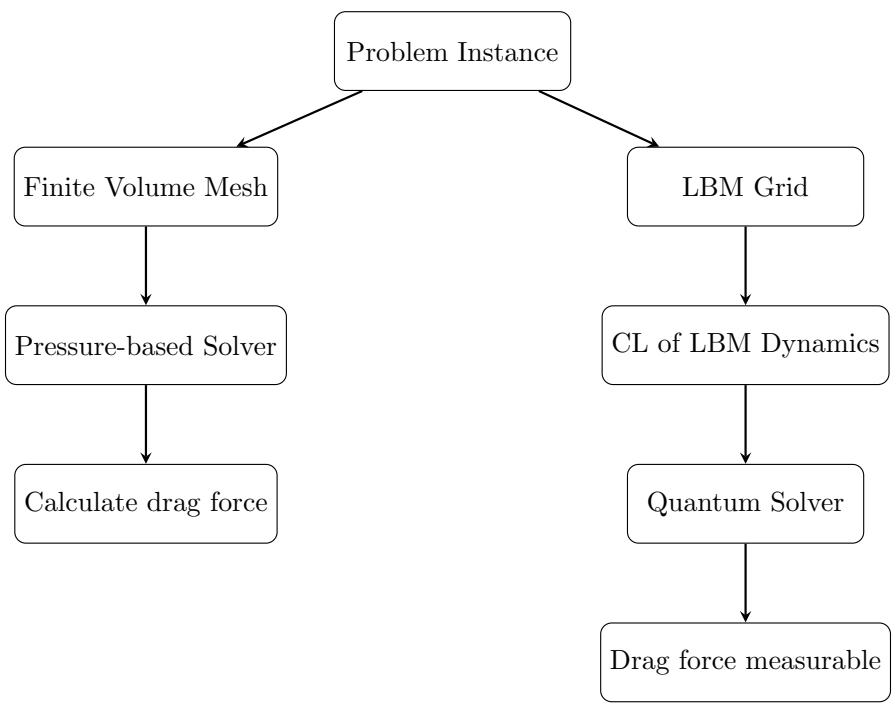
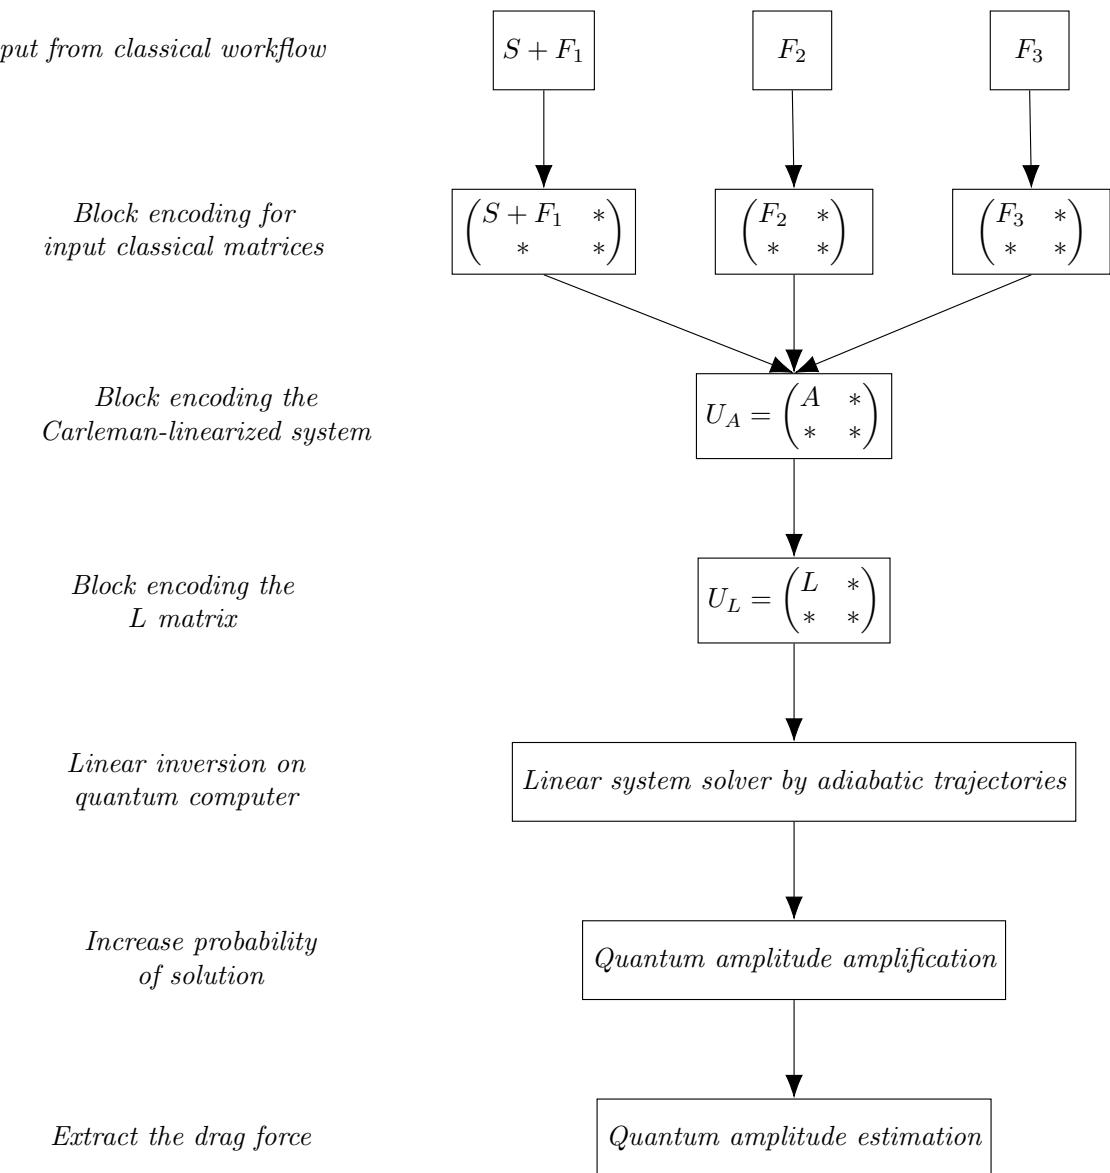
现实策略是只读关心的量(quantity of interest, QoI):阻力/升力系数、壁面通量、能谱等标量泛函可表示为振幅的内积或算符期望,用量子振幅估计(见quantum-amplitude-estimation)以平方级加速采样。Penuel 等的船舶阻力方案即把阻力系数编成 的振幅估计再经 QAE 提取:
代价是统计噪声与多时间步累积:每步读出的采样误差会随步数漂移积累,读出侧的完整谱系(全场重构 vs QoI 估计、HTree、classical shadows 等)见readout-strategies。
审计清单:端到端成本核算的必要性
读任何一篇宣称量子加速的 CFD 论文,建议逐项核对:
- 态制备:初值场属不属于可高效制备类?制备成本计入总复杂度了吗?
- 矩阵装载:离散算子经块编码装载的成本(稀疏度、重复度、几何复杂度)是多少?Penuel 等为 LBM 矩阵开发专用块编码省下约 倍资源,说明通用块编码的代价可以被问题特定结构大幅压缩——也说明忽略它的声明不可信Penuel et al. 2024 (arXiv)。
- 读出:输出是标量 QoI 还是全场?采样次数、多步累积计入了吗?
- 时间步数:CFL 约束下的步数是否隐式依赖网格规模(见quantum-advantage-debate的抵消机理)?
- 物理比特:逻辑比特账是否乘上了纠错开销(见resource-estimation)?
反面教材:Tu 等的容错 HHL 资源估计明确声明不含矩阵/向量上传(QRAM)与解下载(层析)——作者自己引用 Aaronson 的”read the fine print”提醒读者,这两项恰是 CFD 场景的最大隐患Tu et al. 2025 (arXiv)。正面教材:Jennings 等的端到端算法把编码、块编码、求解与阻力测量全链条计入,结论从”指数优势”降级为”有界的弱多项式优势”Jennings et al. 2025 (arXiv)。端到端核算不是泼冷水,而是唯一能区分”门票”与”账单”的方法。