计算流体力学要的往往是整个流场(每个格点的速度/压力),而量子算法交付的是 比特态 ——一次投影测量只吐出一个基态标号。读出因此是量子 CFD 最隐蔽的指数墙(总论见 io-problem 词条):测量全部振幅需指数次重复,HHL 原论文自己就把算法定位为”估计解的性质而非解本身”(Harrow–Hassidim–Lloyd, PRL 103, 150502 (2009))。工程出路有三条——只读关心的量(QoI 估计)、只读结构的量(低秩/树状读出)、把统计成本算清楚(幅值估计 vs 采样)——加上一个绕道:把多个时间步装进一个态一次读出(时空编码,浙大 8 比特超导实验)。
问题回顾:全场重构的指数账
幅度编码把 个格点值装进 比特,读出就是逆操作:要重构含复振幅的一般态,量子态层析(quantum state tomography, QST)需在 基下收集 组期望值再做最大似然重构;Song 等实测的测量设置数从 2 比特的 3 组涨到 6 比特的 939 组Song et al. 2024 (arXiv)。更基本的信息论账:把幅度按精度 全部读出,朴素采样的执行次数下界由 Chernoff–Hoeffding 型集中不等式给出Kösel et al. 2026 (arXiv):
要相对精度就得 ——指数回来(实测参考分布下约按 、 增长)。所以”读全场”在量子 CFD 里基本被放弃,策略都围绕”少读、巧读”展开。
出路一:QoI/泛函估计——只读工程要的量
CFD 工程交付的常常不是流场而是标量泛函:阻力、升力、通量、热流。这些是 上的线性泛函 ,可用 Hadamard test 直接估计而无需重构全场——HHL 的原始定位正是如此Harrow et al. 2009 (PRL)(复杂度分析见hhl)。Penuel 等的阻力计算给出最完整的流水线:把阻力系数编成振幅内积 ,用量子幅值估计(quantum amplitude estimation, QAE)提取,再对振幅估计电路做 Grover 迭代放大精度Penuel et al. 2024 (arXiv)。这一”内积-幅值估计”结构是所有 QoI 读出的模板(QAE 细节见quantum-amplitude-estimation);代价是阻力泛函的参考态 本身也要能高效制备——否则读出问题只是被搬运到了态制备(见state-preparation)。
出路二:HTree 与低秩读出——利用解的结构
HTree(Hadamard 树)读出面向实值问题:CFD 离散系统的解常可取实振幅 (对称化后的实矩阵特征向量),此时 可直接从测量分布 采样,而相对符号由逐比特 Hadamard 门确定——对第 比特作用 Hadamard 后的测量统计给出 与 的符号关系, 比特态只需 组设置(对比 QST 的 :实测 6 比特 17 组 vs 939 组)Song et al. 2024 (arXiv)。Song 等把 HTree 首次用于物理问题(压力泊松解的读出),真机保真度 95–99%。
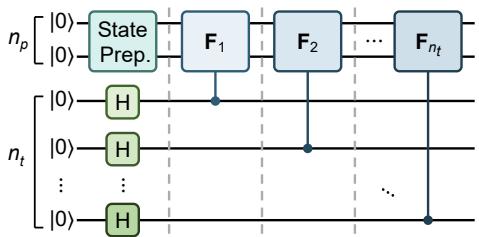
时空编码读出(QC091)从编码端消灭重复测量:把时间步均匀叠加进 个时间比特(),用受控演化模块 (演化 步)做树状分支,末态是所有时间步的叠加 ——单次执行后测时间寄存器即可抽任一时间步,免去逐步测量+重初始化的开销;浙大 8 比特超导实验用它再现涡对蛙跳(见nisq-experiments)Wang et al. 2025 (arXiv)。npj QI 的量子 LBM 同理”仅在末端测量”Wang et al. 2025 (npj QI)。与 HTree 的互补关系:HTree 压缩的是空间维度的读出设置数,时空编码压缩的是时间维度的重复执行数。
出路三:幅值估计的统计成本核算
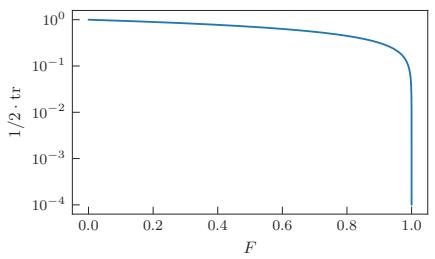
QoI 估计的精度-成本账是读出策略的定量核心。经典蒙特卡洛采样估计概率 到加性误差 需 次采样(中心极限定理);QAE 用幅值放大 + 相位估计达到 ——Heisenberg 极限,这是 HHL/QPE 体系对统计量的二次加速(见quantum-amplitude-estimation、quantum-phase-estimation)。但两个附带条件常被忽略:其一,QAE 线路含受控 Grover 迭代,深度 ——精度每进一位,线路深十倍,NISQ 设备上不可行(这也是 Ali–Kabel 观察到”泛函估计近期不现实”的根源Ali & Kabel 2023 (PR Applied));其二,加性误差 是对单个泛函的——要读 个量,预算按 线性叠。Ali–Kabel 还给出真机必备的换算曲线:对纯态,迹距离 (),保真度 10.89% 对应迹距离 0.944;要迹误差 ,保真度须 ——把”保真度 99% 看起来不错”的直觉直接换成工程语言Ali & Kabel 2023 (PR Applied)。
多时间步的读出累积误差
时间推进类问题把读出问题乘上时间步数:每个物理时间步都要读出场量(喂给下一步的非线性计算),每步的读出误差 与态制备误差一起累积。Song 等的定量结论最直接:方腔流收敛要求每步 ,而真机 HTree 读出只能做到 95–99%(–),数百步累积后残差停在 ——显式时间推进在 NISQ 上不可行的机理正是读出累积,而非单步能力Song et al. 2024 (arXiv)。这解释了两条设计趋势:时空编码把多步读出合并成单次读出(QC091);系综/末端测量把读出推迟到演化终点(npj QI)——都在把读出次数从 压向 。
最后提一句经典阴影(classical shadows):对由少数泡利字符串张成的观测量集合,随机基测量能以 因子而非指数开销预测大量期望值Tennie et al. 2025 (Nat. Rev. Phys.)——它是”少读、巧读”思想的最新通用工具,在 CFD 观测量(局域通量、低阶矩)上有天然适配面。