量子-HPC 集成研究的问题是:当 QPU 真的接入数据中心,流体软件栈会长什么样、瓶颈在哪里。现实答案与 GPU 的历史惊人相似——QPU 作为协处理器挂在经典求解器旁边,只接管它擅长的内核(线性代数),数据在两域之间来回搬运;与 GPU 不同的是,经典→量子的数据装载本身就是指数开销(见 io-problem 词条),所以”哪些数据值得过河”成了第一设计决策。三个工程样本给出了可操作的经验:Quanscient 用 Intel Quantum SDK 的模块化实现把混合 QLBM 做到与经典 LBM 符合 ,本源量子的 QLAS 框架让量子线性求解器像经典库一样即插即用(Physics of Fluids 36, 2024),Syamlal 等则给出对标 Frontier 超算的 性能模型。
系统架构:QPU 作为协处理器
主流架构(见hybrid-quantum-classical)把 CFD 时间推进拆成经典主循环 + 量子内核调用:经典侧做非线性步、边界条件、网格管理与收敛控制;量子侧解压力泊松(投影法的大头,见projection-method、quantum-poisson-solver)或每步的线性系统。Song 等的混合 NS 方案是这个架构的教科书实现——经典设备算动量方程,量子 VQLS 解压力泊松,多重网格预条件压条件数Song et al. 2024 (arXiv)(结果见nisq-experiments)。
与 GPU 类比有助也有害。相似处:主机-加速器编程模型、kernel 式调用、把热点循环外包。根本差异在数据经济学:GPU 拷贝 个浮点数是 带宽问题,把 个浮点数装进振幅编码态是 门深问题(Shende 分解 级,见state-preparation)——“搬运”本身可能比”计算”贵。因此量子-HPC 集成的设计法则是:让量子态在量子侧尽量长寿(多步演化不测量),跨域传输的只有低维参数(ansatz 参数、代价标量、少量 QoI),这正是 npj QI 量子 LBM”只在末端测量”设计的工程动机Wang et al. 2025 (npj QI)。
Quanscient:模块化软件工程的经验(QC084)
芬兰 Quanscient 团队(Budinski 所在司)把经典软件工程原则——自顶向下、单一职责、模块化——移植到 Intel Quantum SDK 1.0(C++/LLVM 混合量子-经典框架)中实现 D1Q2 对流扩散 QLBMShinde et al. 2025 (TQC):预处理/求解器/后处理三模块、自定义门(CCPHASE、五比特受控 X 按 Nielsen–Chuang 分解)、collision/propagation/宏观量提取三个子线路分层组装。数值验证上 1D 通道输运(32 格点)与解析解、经典 LBM 三方对比,QLBM 与经典 LBM 在 容差内一致——差异来自 Boltzmann 离散与网格分辨率而非量子算法本身。
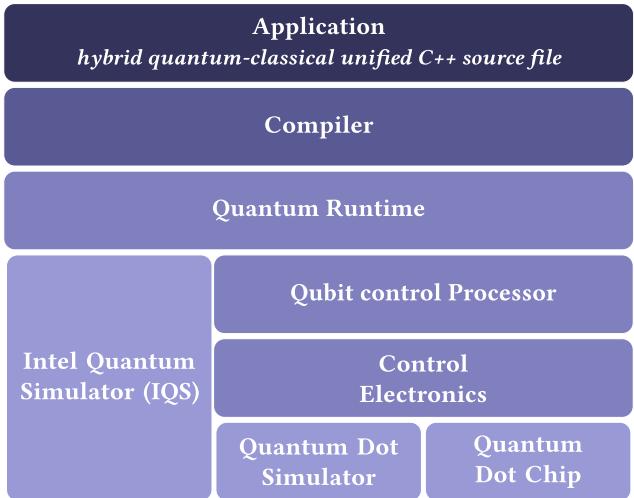
两条工程经验值得记录:其一,除态制备步外复杂度 ,编码步最贵(最坏指数)——数据搬运瓶颈在代码结构上就看得见;其二,混合时间步进每步重新编码初态,作者自己明说该做法”很可能破坏量子加速”,时间步串联要参考 Schalkers–Möller 型设计——工程诚实是这类论文最有价值的部分。
本源 QLAS:求解器即插即用(QC006)
本源量子与中科大的混合框架走了库化路线:传统有限体积 CFD 求解器(可压流守恒律)以弱耦合方式接入量子线性代数库 QLAS——LinSolver 抽象类下并列 CG(经典)、HHL、VQLS 等实现,调用侧代码不变即可替换后端Ye et al. 2024 (Phys. Fluids)。核心创新是 SUB-HHL/SUB-VQLS 子空间迭代:把量子求解器嵌进经典子空间迭代内,问题尺寸被匹配到可用量子资源,同时保住精度。验证案例覆盖定常(无粘 bump 跨声速绕流,Mach/压力等值线与 FGMRES 完全吻合)与非定常(圆柱绕流阻力/升力时间历程、带攻角翼型 与实验对比)。这条”先接管线性代数内核、再逐步扩大量子份额”的渐进路线,与 Quanscient 的”先建立软件工程规范”互为镜像。
Syamlal:对标 Frontier 的性能模型(QC011)
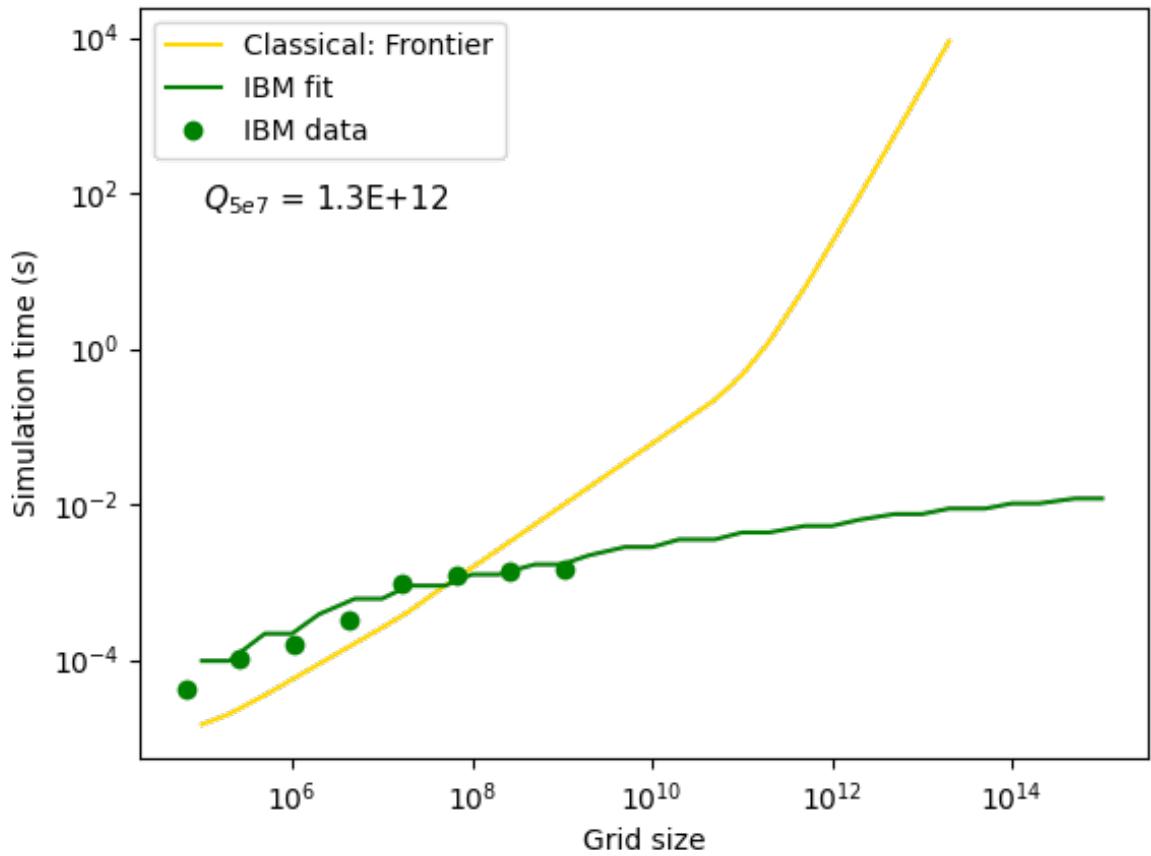
QubitSolve 团队的工业路线图回答的是”还差多远”:先对世界最快超算 Frontier(9408 节点、AMD MI250X)建 roofline 式经典性能模型——CFD 内核算术强度仅 – FLOP/byte,访存主导,各网格规模存在最优 GPU 数;再用 IBM 真机实测电路运行时间外推量子侧,定义关键性能参数Syamlal et al. 2024 (AIAA):
即量子优势。结论直白:未优化 VQCFD 原型 vs 优化经典代码,当前上界 ——悲观,但只是上界;论文列出有望把比值压到 1 以下的技术清单(高效参数化电路、场变量/多积并行化、误差缓解+shot 分配优化、Superstaq 编译、连接性分解、噪声感知映射、最小化测量,见error-mitigation),下一阶段开发 3D 最小可行产品。与 Penuel 的自上而下核算(见resource-estimation)互补,这提供了自下而上的对标方法论。
现实约束与算法-硬件配对
集成不是纯软件问题。Tennie 等的 Nature Reviews Physics 综述给出算法家族与硬件平台的配对建议:混合变分算法 ↔ 超导电路(短深电路、快门操作)、平均场量子求解器 ↔ 囚禁离子(长相干、全连接)、线性化类求解器 ↔ 中性原子(大规模模拟量子计算、并行演化)Tennie et al. 2025 (Nat. Rev. Phys.)——CFD 的变分路线(vqls、variational-pde-solver)因此与超导平台绑定最深,这也是 IBM 设备主导真机演示的原因(见nisq-experiments)。其余硬约束:QRAM 缺位使经典数据装载只能靠结构化态制备(见state-preparation);每分钟级的队列与校准漂移使”量子内核必须无状态、可重试”;而稀释制冷机、激光系统的功耗与占地把 QPU 的数据中心化变成十年尺度的工程问题(能耗账见resource-estimation)。