资源估计(quantum resource estimation, QRE)把”量子算法复杂度 “翻译成工程师能核对的三样东西:需要多少物理量子比特、跑多久、耗多少能量。对量子 CFD 这是生死攸关的翻译——Penuel 等对船体阻力计算的容错级核算给出 (逻辑比特)×(T 门) 积 –、随 幂律增长的结论,直接否定了显式时间演化的指数优势(arXiv:2406.06323);而 Tu 等与 Google 的 FLASQ 成本模型则从另两端给出交叉点与早期容错的可行区间。三条线合起来构成量子 CFD 的”账本”。
方法论:从算法到物理比特的完整账目
QRE 的标准流水线分四级,每一级都要显式给出常数:
- 算法层:确定问题的输入参数——规模 、条件数 、稀疏度 、目标精度 。例如 Tu 等对 HHL 型线性系统求解器推导出带显式常数的 T 门数上界Tu et al. 2025 (arXiv):
并用 Q# 线路实现验证;关键是 这些多项式因子的常数不小,绝不能藏在 里。
-
逻辑层:把算法线路换算成 Clifford + T 门集。非 Clifford 的 T 门是容错瓶颈——表面码下每个逻辑 T 需要魔法态蒸馏(或培养),成本远高于 Clifford 门。
-
纠错层:选纠错码(量子 CFD 文献默认 2D 表面码)与码距 ,由物理错误率 与逻辑错误预算定标:逻辑错误率随 指数压低,而物理比特数 每逻辑比特。蒸馏工厂占用大量辅助比特,往往超过数据比特。
-
物理层:由门时间与比特能耗折算墙钟时间与能量。Tu 等采用 、逻辑周期 10 ns、稀释制冷机冷却能耗 6.25 W/物理比特(按 IBM System Two 的 4158 比特/27 kW 折算)Tu et al. 2025 (arXiv);FLASQ 则用 s、反应时间 10 s 与魔法态培养(cultivation,比传统蒸馏便宜数个量级)Huggins et al. 2025 (arXiv)。
最容易作弊的是两端 I/O:把矩阵/向量装进量子态(QRAM)与把解读出来(tomography/幅值采样)的成本经常被排除在估计之外——Tu 等明确声明其估计不含 I/O,并引 Aaronson 的忠告”read the fine print”(参见io-problem)。
Penuel 阻力计算:Re^2.68 幂律(QC010)
L3Harris/Zapata/MIT-LL 团队(DARPA 量子基准计划)以船舶设计的阻力计算为代表场景,对”Carleman 线性化 LBM(D3Q27、截断至三阶)+ Krovi 类线性微分方程求解器 + 量子幅值估计提取阻力”做了端到端容错核算Penuel et al. 2024 (arXiv):
- bespoke 块编码的红利:为 LBM 矩阵专门构造的块编码(见block-encoding)比通用非结构化块编码削减约 倍资源;
- 绝对量级:圆球绕流 – 的 (逻辑比特)×(T 门) 积从 涨到 ;T 门数 –——对比量子化学基态能量估计典型量级 –,差了 6–8 个数量级;按 T 门 s–ms 与最大并行度折算,最大球算例需数十万年;
- 船体现实:JBC/KCS/MV Regal 三型船体网格 – 格点,Carleman 变量数达 –。
最关键的是标度结论:对 log-log 图做线性拟合,QRE 随 Re 呈 幂律——对比经典 DNS 的 只有弱多项式优势。机理在于:线性微分方程量子求解器的查询复杂度对格点数是 polylog、对时间步数是线性,而 CFL 条件使时间步数隐式多项式依赖于格点数(,见nonlinear-pde-quantum),指数优势就此被吃掉——这是显式时间推进的普适特性,不限于 LBM 路线。
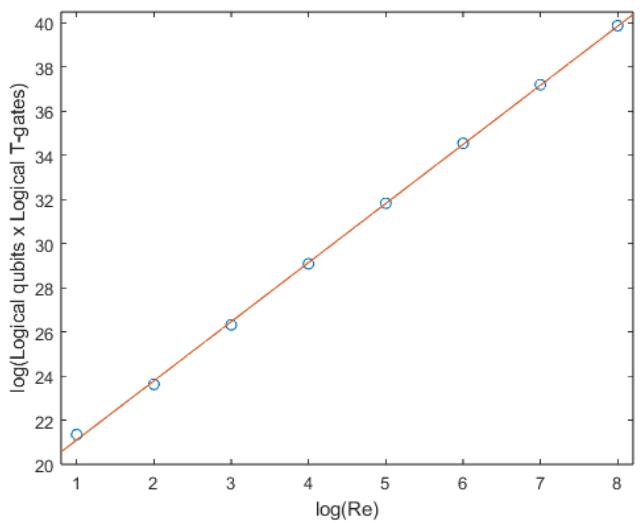
作者给出的出路因此很具体:转向稳态直接求解、隐式格式(松弛 CFL)与耦合振子/FEM 类问题——这为稳态泊松类问题保留了量子线代的机会(见quantum-poisson-solver、quantum-advantage-debate)。
Tu 等:容错 HHL 的时间/空间/能量三维账(QC085)
Tu 等对同一 HHL/QLSA 做了首例时间-空间-能量三维联合估计Tu et al. 2025 (arXiv):经典对照取共轭梯度(CG)在 50 W/GHz 处理器上的 FLOPs 模型,量子侧用 Litinski 表面码 + lattice surgery 框架。结论:
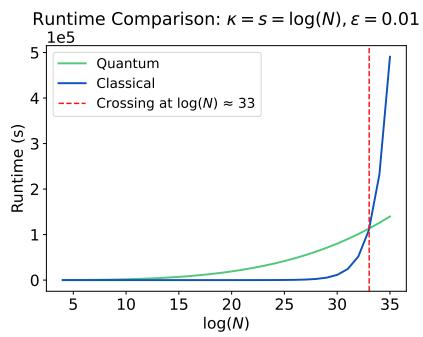
- 交叉点:、 时,时间上可能出现量子优势的规模是 –,需要 物理比特、– J 能量、约 s(十天量级);
- 能量优势晚于时间优势出现:稀释制冷机单位比特能耗高,能量账比时间账更难打平;
- 对更强经典基线:若经典用可并行 Cholesky 上超算,优势推迟到 (届时量子运行时间仍约 200 小时)。
FLASQ:早期容错的时空体积口径(QC086)
Google Quantum AI 的 FLASQ 成本模型换了一个口径:不以 T 门数、而以时空体积(辅助比特的 块)计成本,并计入电路”测量深度 × 处理器反应时间”的硬约束Huggins et al. 2025 (arXiv)。案例研究是 2D 横场 Ising 动力学(、20 个 Trotter 步、目标期望值误差 0.01):FLASQ 预测 下 62,000 物理比特即可完成;手写优化编译验证为码距 13、160 逻辑比特、62,720 物理比特、7,381 个任意旋转(平均 17 T/旋转)、73,810 逻辑时间步——FLASQ 估计仅低 24%。同一口径还揭示”只看 T 数会误导算法设计”:Hamming weight phasing 案例中 2–4 倍的 T 数优势,在时空体积口径下最多缩到 3 倍甚至消失。
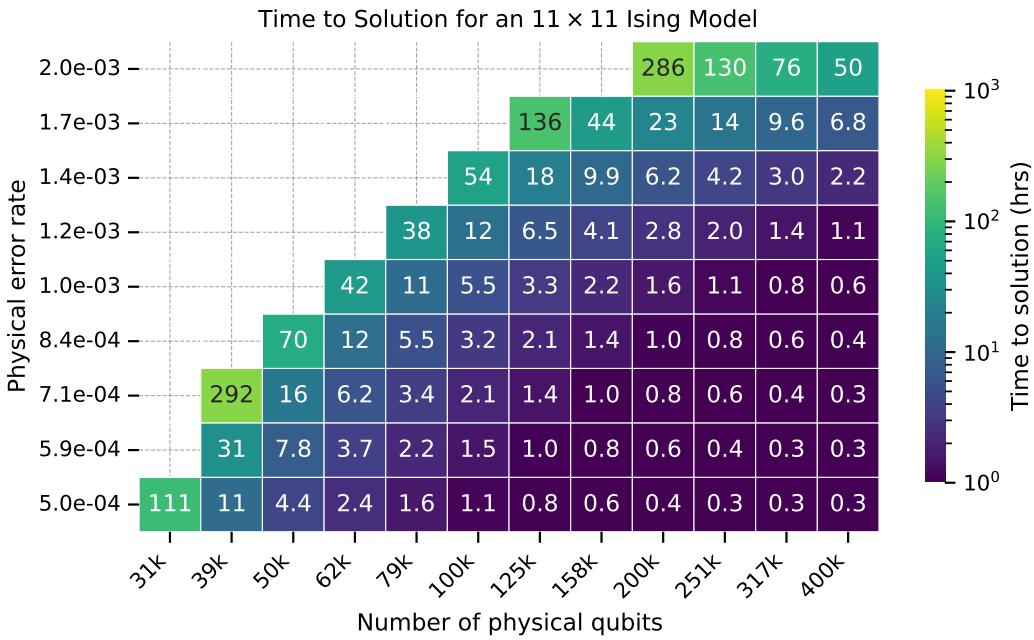
FLASQ 与 Penuel 的关系是互补而非矛盾:前者论证”早期容错区间(– 比特)能做什么”,后者论证”即便全容错、显式时间演化的流体问题也做不动”。
编码选择:账本上最容易被忽略的指数(QC092)
同一算法换编码,资源账可以差指数倍。DLR 的 Kösel–Ewert–Delfs 系统比较了三种编码的初始化与读出代价Kösel et al. 2026 (arXiv):
| 编码 | 初始化深度(旋转门) | 初始化深度(CX 门) | 读出所需执行次数上界 |
|---|---|---|---|
| 一般幅度编码( 比特纠缠态) | |||
| 单比特幅度编码(直积态) | |||
| 比特串编码(无叠加) |
一般幅度编码的初始化深度(Shende 分解,见state-preparation的 下界Shende et al. 2004 (arXiv))与读出采样都是指数墙;实测显示读出次数在参考分布下按 ()增长——比理论上界()乐观,但仍是不可回避的多项式大数。基于此,该文为 LBM 提出了自由设定格点概率的新编码方案,专为每步读出场量的 CAA 类模拟设计。与 Tu/Penuel 的”算法+纠错”账本相比,编码维度提醒我们:算法层省下的指数,可能刚好被 I/O 层补回去。