经典 PINN 及其求值瓶颈
设待解方程 ( 为含空间导数的算子, 为物理参数),边界/初始条件 。PINN 用参数为 的网络 逼近解,损失由两项均方误差组成(QC057 的 Eq. 4–5):
其中 、 分别表示在域内配点与边界配点上的平均。导数项 由自动微分计算——代价是每个训练 epoch 都要对全部 个配点做一次前向求值与反向传播,成本随配点数与网络规模线性增长。QPINN 的第一动机就是改变这笔账:要么让量子模型本身承载解的表示(参数量小),要么把逐点求值整体替换为少数几次量子测量。
DQC 谱系:逐点定义的量子模型
Kyriienko 等的 DQC 把模型定义为量子期望值:数据 经编码门 进入量子态,再作用可训练变分块 ,
为可观测量。梯度无需数值差分——参数移位规则给出解析形式:对第 个参数 (生成元为泡利算符,移位 通常取 ),
即两次同结构线路的期望值之差;对输入的导数 同样成立,因为 也是以旋转角形式进入编码门的。PDE 残差因此可以在任意配点上逐点评估,训练循环与经典 PINN 同构。瓶颈随之而来:其一,逐点残差继承了经典 PINN 的 配点成本;其二,期望值对量子态是线性泛函,方程中的非线性项(如 )无法直接从单条线路读出,需要专门的乘法机制——这正是下一条路线要解决的。
潜空间求解器:重叠损失与 O(N+p) 非线性编码
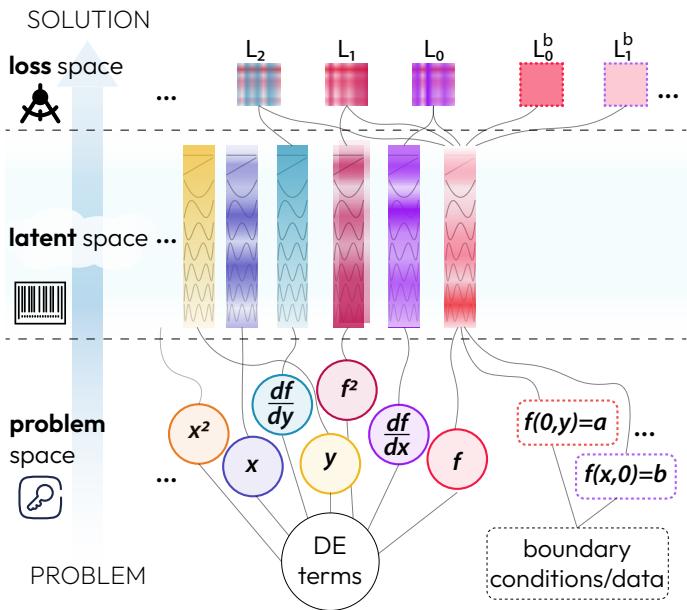
Paine–Elfving–Kyriienko 的方案改变了解的表示方式:不再逐点定义 ,而是把方程的各项——函数 、其导数 、自变量 、边界值——各自映射为 量子比特希尔伯特空间中的量子态 、、,基组取指数规模的 Chebyshev 或 Fourier 编码( 比特天然张成 个基函数)Paine et al. 2023 (arXiv)。可训练模型写成态重叠结构 ,而损失函数本身是态间重叠距离:微分方程约束被转换为”表示 的态与表示右端的态应当重合”的几何条件,形如
其中 为方程项态距离、 为经基映射显式评估的边界项。关键收益:单次测量的统计平均内在并行地覆盖整组基函数上的约束,训练不再需要在网格点上逐点求值——这是对经典 PINN 每 epoch 次配点求值瓶颈的直接回应(论文动机明言流体动力学等工业场景)。
非线性项的编码是第二个关键构件。Chebyshev 基满足乘积恒等式
于是函数乘法在基指标上退化为整数加法与减法——可用 ADD/SUB/MOD 算术电路(QFT 加法器 + CNOT 层)实现的模运算:
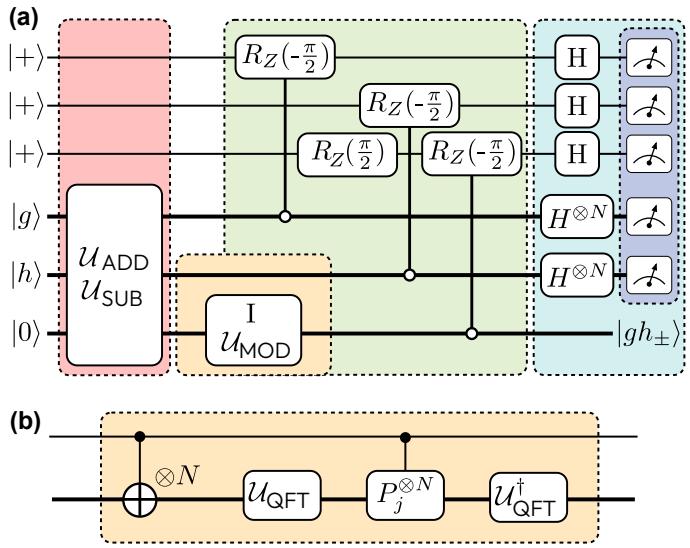
乘积态 由寄存器扩展(副本 + 算术电路 + 重归一化)生成,系统规模只随非线性次数 线性增加—— 项的编码成本为 。自动微分同样被”基感知”算子(在基空间表示 的作用)替代。演示算例从线性 ODE(,)到非线性 ()再到多维 ;“shifted model”(解按基函数平移重整化)比常规缩放模型的训练 epoch 少约一个数量级。
混合 HQPINN:量子深度注入层与 3D CFD
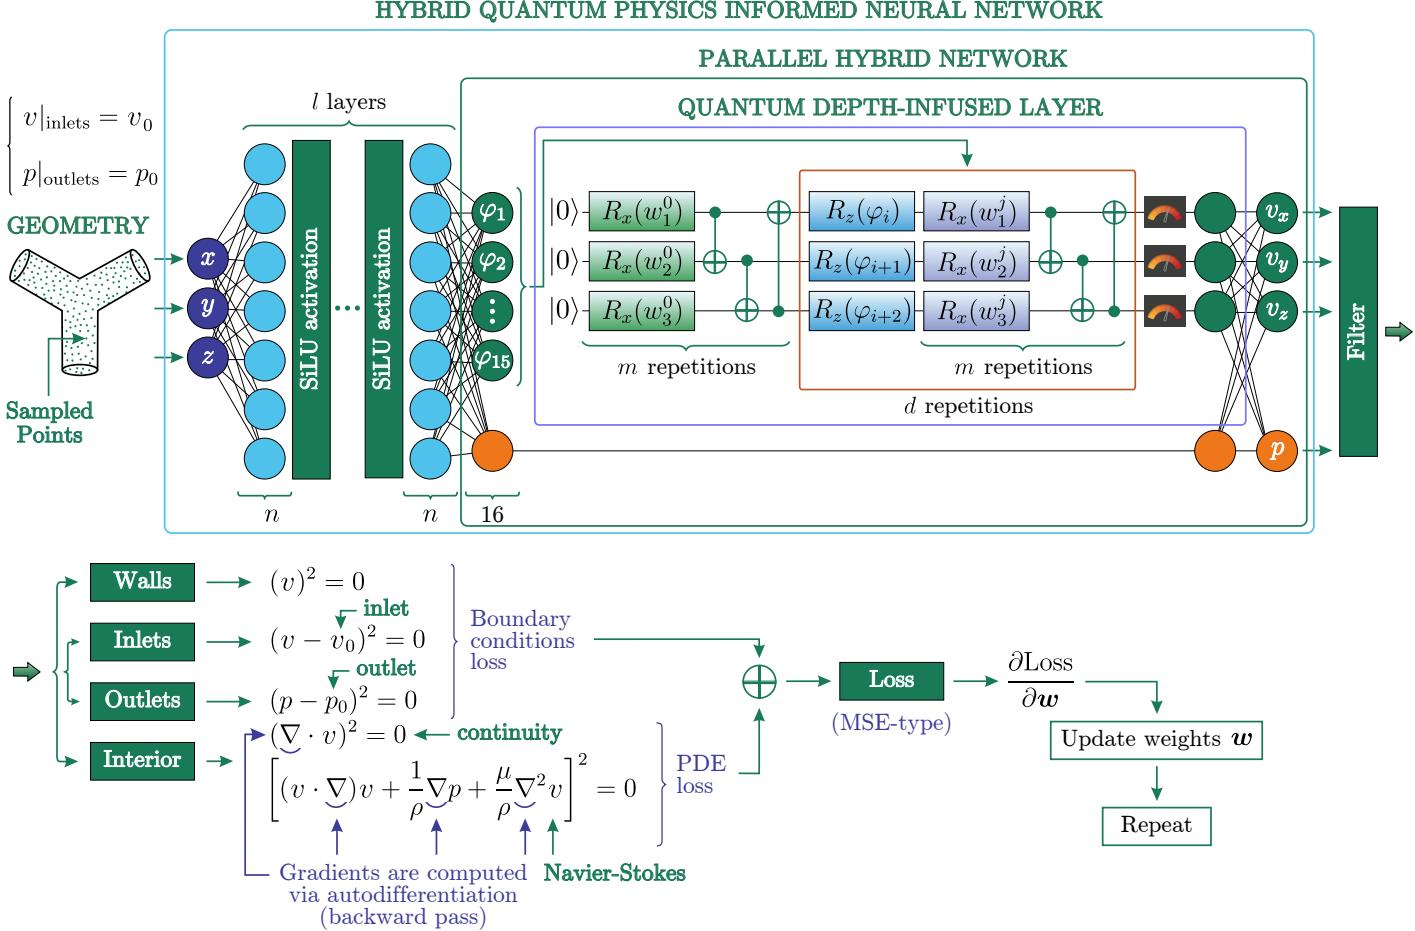
Sedykh 等(Terra Quantum)把量子层嵌入经典 PINN 得到 HQPINN:主干是输入 、输出 的经典 MLP( 个隐层,圆柱算例 、Y 型混合器 ,SiLU 激活),中间插入并行混合层(Parallel Hybrid Network)——16 个并列单元中 15 个由量子线路实现、1 个保留经典通道,量子与经典特征并联后再进入后续层Sedykh et al. 2023 (MLST)。量子单元为 3 比特线路:编码层重复 次叠加变分层 次, 旋转门与 CNOT 纠缠交替,末端测量 期望值作为输出特征。训练用全批次,先 Adam 1000 epochs 再 L-BFGS 100 epochs;配点分为流体域/壁面/入口/出口四组,分别施加定常不可压 NS 方程(四个分量方程各计损失求和)或边界条件。结果:
- 3D 圆柱绕流(Re=10,水,25000 个 OpenFOAM 网格点):HQPINN 对 OpenFOAM 参考解的速度平均相对误差 1.2%、压力 0.8%;
- 3D Y 型混合器层流:经典 PINN 因梯度消失在混合点前退化为零解;HQPINN 配合迁移学习(混合角 逐度传递,每步 L-BFGS 100 epochs)成功跟踪几何参数变化;
- 总体上 HQPINN 相对同规模纯经典 PINN 损失降低 21%——量子层缓解但并不根治 3D 复杂几何下 PINN 的退化。
四条实现路径与批判
按 2025 年综述的分类Amaral et al. 2025 (Braz. J. Phys.),QPINN 的实现路径可归纳为四条:
| 路径 | 非线性来源 | 代表 | 特点 |
|---|---|---|---|
| 显式线性量子模型 | 无(仅线性方程) | 基系数线性组合编码 | 结构最简单,只覆盖线性问题 |
| 非线性增强量子模型 | 乘法算子/数据重上传/多副本 | 潜空间求解器(QC058) | 非线性经算术电路编码, |
| QNN 式 QPINN | 逐点期望值 + 经典组合 | DQC 逐点残差 | 与经典 PINN 同构,继承配点成本 |
| 混合 HQPINN | 经典网络的非线性 + 量子层注入 | Sedykh(QC057) | 工程上最成熟,3D CFD 已验证 |
批判性地看:Sedykh 的 3 比特量子层完全可经典仿真(作者自注超过 20 比特才需真机),“更高表达力”的证据是特定算例的损失下降而非渐近优势;综述给出的 Burgers 示例(HQPINN 321 参数对经典 1341 参数、相同 epoch 下精度超一倍)同样来自仿真。普遍性风险包括变分线路的贫瘠高原(barren plateau)、期望值估计的测量开销、以及数据/解的编码读出成本(见io-problem)。量子侧真正结构性的收益——避免逐点求值的重叠损失、 非线性编码——目前也只在可经典仿真的小规模上验证过。