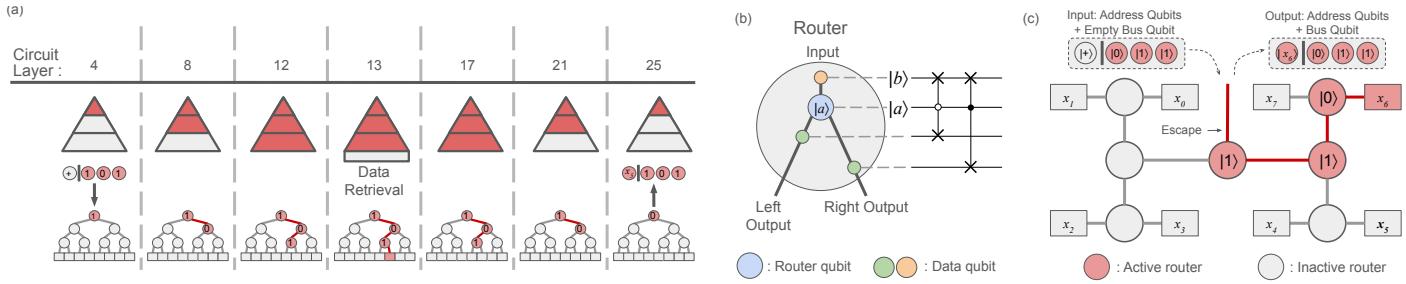
机制回顾:BB 的根瓶颈与胖树的复制
共享内存(shared memory)场景是这条架构线的出发点:多个量子处理单元(QPU)共享同一台 QRAM——量子数据中心(见 量子数据中心 与 Liu et al. 2023)把这一组合定义为第四代量子基础设施。而 bucket-brigade(下称 BB,机制见 bucket-brigade 架构)在这个场景下有一个结构性缺陷:第 0 个地址比特进树后占据根节点直至查询结束,根又是全部地址比特唯一的入口(escape),任何时刻树内只能”刻”出一条查询路径。 个并发请求只能排队串行,总时延 ——BB 的对数时延优势在争用(contention)下被查询数成倍吃掉。
Fat-Tree QRAMXu et al. 2025 的修法是拓扑性的:在 BB 完全二叉树上,把第 层(自根起 ,,本文 均以 2 为底)的路由器复制 份,使节点 内含 个路由器,以三元组 索引( 层号、 节点号、 复本号)。BB 树恰是只保留 号复本的特例。名字取自 Leiserson 1985 年的经典 fat-tree 网络:二者几何同构——越靠近根部节点越”胖”;但论文特别强调路由语义不同:经典 fat-tree 做叶间报文通信,QRAM 查询是自根向叶”刻路径”,加粗的目的因此也不同(见下节)。
最有生产力的等价视角:把同色路由器单独挑出来,Fat-Tree 是 个尺寸递减的 BB 子 QRAM 的复合——子 QRAM 恰含全部深度 的节点中 号复本,地址宽度 ;最大的 就是一棵完整 BB 树。每条查询从最小的子 QRAM(,只有根一个路由器)出发,每装载一层地址就经节点内局域 SWAP 迁移到更大一号的子 QRAM。这个视角立即给出吞吐量的直觉上限:同一时刻每个子 QRAM 至多宿主一条查询,故并行度 ;且任一时刻一条查询的”已刻路径”只 confined 在一个尺寸 的 BB 树里,其余 个路由器仍停在等待态——BB 的噪声图像(任意时刻仅 个激活节点)原封不动地保留。
拓扑账:节点数、边宽度与等分带宽
路由器计数:
第 层有 个节点、每节点 个路由器,总数
两个标准和式:;对第二个,把 按”计入 共 次”重排为 ,内层是几何级数:
代回:
BB 是 ,故比值
逐层指数复制,总量只翻倍。 原因在复制的分布:顶层单节点复制得最厚(根节点 个路由器),但顶层节点少;增量 的质量集中在底部(每个叶父节点只多 1 个路由器,共 个)。按量子比特计(每路由器 4 个量子比特再计入线端辅助),论文给出 (BB 为 )——同样恒为两倍。
边宽度:自根向叶逐层收窄
BB 的父子节点间只有 1 条连线;Fat-Tree 中节点 有 条输入线,向左右子节点各引 条输出线:根 条,每降一层减一,到叶父节点恰剩 1 条(与 BB 相同)。宽度配额不是任意的:子节点边宽 = 子节点内路由器数减一,每条线绑定子节点中一个路由器的输入(模块实现中末位路由器充当年询暂存、没有输出端)。于是在途地址比特各走专线,多路查询的并行门步不会在线路上争用——这正是”胖”的量子语义:经典 fat-tree 按子树规模加宽以买全二分带宽,这里加宽量封顶在 ,因为需要同时过线的查询数本来就至多 。
总连线数可精确记账:
中间一步同上节(把求和拆成 )。恒等式 :每个路由器恰好摊到一条节点间连线——这是一笔可自检的账,任何布图方案若连线数偏离它,说明复本配额没对齐。
等分带宽与聚合带宽:胖在哪里
等分带宽(bisection bandwidth):把叶子对半切开,割口正是根节点向下的两组输出边,计 条;BB 是 2 条。因子 。逐层看,第 层间总边数 (BB 为 );由于 当且仅当 , 向叶单调增大,叶界聚合带宽(aggregate bandwidth) 条两边相同——经典数据的并行写入能力不变。所以 Fat-Tree 的”胖”只发生在 很小的上部 层,底部原封不动;而决定全网吞吐的瓶颈割恰在最上部,二分带宽从 2 提到 。数值: 时 对 ; 时 对 。
但要点在于:查询语义下真正被加宽买到的,不是叶间二分通信,而是根端口注入带宽——根节点 个路由器可同时驻留 条查询的第 0 级路由状态,注入带宽从 1 提到 。这是下节流水线推导的拓扑前提。
查询级流水线:SWAP-I/SWAP-II 与周期账
BB 只有比特级流水线(bit-level pipelining):同一查询内的地址比特错拍进树(成本口径:激活门、干预与能量 推导四的摊销发生在同一棵树、同一条查询上)。Fat-Tree 引入的是查询级流水线(query-level pipelining): 条独立查询同时在树,各占一个子 QRAM,新查询每 10 层启动一条。
机制上,装载/卸载的门步(gate step)与 BB 完全同构:4 层装载一层地址。查询在子 QRAM 完成一层装载后,追加一个交换步(swap step,1 层):节点内局域 SWAP 把查询从 号迁到 号复本——具体是各节点内 与 的输入/路由量子比特互换,且分 SWAP-I(偶 )与 SWAP-II(奇 )奇偶交替,保证不同查询永不同时占用同一路由器(论文图 6 的”同层无同色”条件)。局域 SWAP 只动节点内部量子比特,不需要节点间通信,故深度恒为 1 层;经典数据读出(1 层 CLASSICAL-GATES)则搭在交换步里并行执行(按 奇偶落在 SWAP-I 或 SWAP-II 之一)。流水周期:
单查询时延: 层的账目
对单条查询逐段数:装载 个门步( 层) 个上迁交换步;卸载对称,再 层 个下迁交换步;经典读出 1 层(与某一交换步同拍):
对照 BB 的 (装载 门步 + 读出 + 卸载 门步)。论文图 7 的 "" 与图 6 的 ""()都由此而来。差值 层,全部来自交换步。
真实时间还要给快门打折:节点内 SWAP 125 ns、经典门也快,按 CSWAP 门时 1 μs 的 计。交换步共 个含读出的快层,故加权口径
正是论文 Table 1 的两个数。单查询代价 ,渐近慢 25%——这是买并行度的第一笔单价。
算例(,): 三条查询错拍 10 层。:门步装载第 0 层()→ SWAP-I 迁入 → 门步装载第 1 层 → SWAP-II 迁入 → 门步装载第 2 层、读出 → 对称卸载,共 层。 在第 11、21 层进场。三条查询总层计 层,对照 BB 串行 层;加权计 对 。
流水线总时延:
新查询每 10 层(加权 8.25 时间单位)进场,树内至多 条。第 1 条在 完成,此后每 8.25 完成一条, 条查询()的总时延
取 :
即论文 Table 1 的并行总时延。BB 排队执行同样 条需 ,比值
时 , 时 。
稳态口径另算:连续流下流水线填满后每 8.25 时间单位完成一条,摊销时延
两个”摊销”要分清: 的批口径 含流水线填充开销,论文 Table 1 的 Amortized 行(常数 8.25)取的是稳态速率口径,与最大查询速率互为倒数。
吞吐量账:带宽、时空体积与调度
最大查询速率与带宽
论文新设的三个共享口径:查询并行度(同时在树的查询数上限)、最大查询速率(每秒完成查询数,= 摊销时延的倒数)、带宽(速率 × 总线宽度,单位 qubit/s)。取 CSWAP 门时 1 μs,即时钟 CLOPS:
关键在于与 无关:流水周期是常数个门步,不随树深增长。BB 无流水,速率 随规模衰减: 为 , 为 。提速因子
横向对照同等比特预算:分布式 BB(D-BB, 台 比特)带宽 也是常数、甚至略高,但代价是 比特——渐近多一维;Virtual(虚拟 QRAM,虚拟 QRAM 与系统架构),同样 比特,单查询时延 ,速率仍随 衰减。 比特预算下,Fat-Tree 是唯一的常数带宽者。
时空体积:宽度 × 摊销时延
时空体积(space-time volume)每查询定义为 比特数 × 摊销查询时延,是”占着多宽的硬件干多久的活”的总账:
三式与论文 Table 2 逐一吻合(乘开即得)。比值 : 为 , 为 ,渐近 。Fat-Tree 用恒定两倍的比特,把每查询的时空占用从 压到 —— 比特组里渐近最优。
经典换页预算与 FIFO 调度
并发的代价有一笔记在经典侧:相邻两次数据读出的间隔等于流水周期 ,这是经典存储完成换页(page swap)的全部预算,且为常数——对照 BB 的 反而随规模变宽。查询越并行,经典存储必须越快。
调度侧,论文证明先入先出(First-In-First-Out, FIFO)调度对离线与在线请求都最小化总时延,用的是教科书式交换论证(exchange argument):设某最优调度中相邻两查询 逆序( 却先做 ),交换二者,其余查询时延不变,而二者时延之和
逐项相消、总和不变;反复交换即把最优解变形为 FIFO。故 FIFO 亦最优。利用率(utilization)由此从 BB 的二值(0 或 1)变为 连续:查询间隙可插入新查询,若每个 QPU 在两次查询间有 层本地处理,可共享的 QPU 数可超过 (论文给出 量级)。注意边界:流水收益要求查询相互独立;Grover 型迭代内部查询串行依赖,跨迭代填不了流水,收益要在并行/分段化算法上兑现。
噪声账:三类门的有效误差权重
从单门错误率到 标度
噪声模型沿用 Hann 系的通用信道 。Fat-Tree 的门分三类:节点内 CSWAP(错误率 )、节点间 SWAP()、节点内局域 SWAP()。论文给出
前一步把”无错概率”组合成保真度下界,后一步用 Bernoulli/union 线性化;精确前因子以论文的门数计账为准。为什么有效门数是 而非 ——这是权重账的要点。单个门步中,深度 的全部 个路由器都在执行 CSWAP,但均匀叠加下第 个地址比特使每个深度- 节点以概率 处于该查询的激活路径上;出错要进入干涉路径才毁查询,故深度 的有效误差权重是
与 无关。一个门步扫过 层、权重 ;单查询 个门步(装载 + 卸载 ),合计 ——指数的树被路径概率”除”回了多项式,这正是 成本口径 与 bucket-brigade 架构 中 Hann 界( 系)同一套局域化机制Hann et al. 2021。
Fat-Tree 特有的问题是第二类:交换步中全树所有节点同时做局域 SWAP,物理门数是 量级,为何误差权重仍只有 ?因为有效权重仍按”查询占用”计数: 条在途查询各占 层各一个路由器, 个被占用的 SWAP 位点才是能接触查询幅度的门;空转路由器上被换的两个量子比特都停在等待/闲置态,其错误不进入任何查询的干涉路径。这是胖树保住 BB 噪声标度的关键机制。
与 BB 的对比与数值
BB 无局域 SWAP 类,对应 (即 Xu et al. 2023 韧性分析的形式)。Fat-Tree 的增量恰为常数项 。取论文的实验现实值 、(分束器实现、快且高保真):
不保真度相对增加四分之一,标度不变。自选参数算例:、、(保持论文的 比例),则 (BB 为 ); 时为 对 ——相对劣化恒 25%,绝对值随 增长,固定 下界在 处饱和。这正是引入蒸馏与纠错的动机。论文 Table 3 的实测型数字:()时 (最后一档经 post-selection)对应不保真度 。
并发蒸馏与纠错的复合收益
虚拟蒸馏(virtual distillation)。 对含噪查询态 ,并行制备 份得 ,蒸馏态 把理想分量权重抬到 、主导误差项压到 (二分量模型下 : 时 ,与下例吻合)。Fat-Tree 给出一个并行度-保真度互换旋钮: 份拷贝用于蒸馏,剩 路并行查询。同预算算例(论文 Table 4,各 256 比特):一台 Fat-Tree(,) 路查询,单查询 , 份蒸馏后 ;两台 BB(共 256 比特) 路,, 份蒸馏后仅 ——并行度翻倍让蒸馏份数翻倍,独立随机误差下蒸馏后保真度指数级拉开。
纠错。 全编码方案(每个比特用参数 的稳定子码编码: 个物理比特、维度 1、码距 )需 物理比特;有趣的是 CSWAP 虽非 Clifford,但 QRAM 门集不构成普适门集,Eastin–Knill 定理的前提不成立,可走横向(transversal)非 Clifford 实现(color code 横向 CCZ,[5,1,3] 码的 pieceable 容错 Toffoli 可作容错 CSWAP 候选),免魔态蒸馏。数量级对比:码距 3、物理错误 下,普通电路(不保真度随电路规模线性)只能跑到树深 ,QRAM 靠 标度可跑到 (不保真度 )。更省的变体是噪声 QRAM + 编码地址:只编码 个地址比特与 1 个总线比特,QRAM 本体保持物理(共 比特);一个逻辑地址的 个物理比特当作 路物理查询流水进树(要求 ,不得超并行度),逻辑并行度 、逻辑查询时延 ( 为综合征提取深度);对照全编码 BB 的 比特、并行度 1、时延 ——查询级流水把编码开销从乘法因子降为加法因子。
算法层收益
把吞吐账乘到算法上(论文 7.3 节,渐近只保留对 的依赖):并行 Grover(Zalka 分段)总深度 ;并行 k-sum ;并行哈密顿模拟(量子行走)与并行 QSP(, 为多项式次数)类似。数值: 的基准上总深度最多降 10 倍——恰为 因子(论文 Fig 9,QSP 取 、)。合成基准同样显示:BB 在并行算法数稍增时即撞带宽墙,而 Fat-Tree 可按”处理/查询比”调节并行算法数,把利用率钉在 1 附近。
硬件设想与局限
硬件面向超导腔-transmon 混合平台:路由器量子比特由腔编码、transmon 耦合输入腔实现原生 CSWAP(1 μs 量级),分束器(beam splitter)实现节点内相邻路由器的局域 SWAP(125 ns)。连接性是主要约束,论文的关键观察是 Fat-Tree 只需双平面近邻连接即可实现:模块化方案——节点做成独立模块、同轴电缆加可调耦合器互连,同轴线可弯折,模块内无走线交叉;片上方案——连接图可分解为两个边不相交平面子图,thickness-2 双层芯片加 TSV(through-silicon via)硅通孔互连,父子节点交替占面避免同面交叉。平台外推:囚禁离子 QCCD(quantum charge-coupled device),以离子芯片替换模块、QCCD 链路互连。
局限清单:量子比特翻倍( 对 );不保真度常数因子劣化(+25%);单查询时延 +25%;经典换页预算压到 8.25 μs 常数;全并行变体 D-Fat-Tree 需 比特;收益依赖独立查询流与 FIFO 供给。与 虚拟 QRAM 与系统架构 同出耶鲁 Ding 组体系:虚拟化按时间换空间(分页复用 比特查询大地址空间),胖树按空间换吞吐(恒定复制买 路并行),加上 量子数据中心 的系统图景,共同构成 QRAM 的”系统层”叙事。
数值算例: 与
约定:层计(每层记 1)与加权计(快门按 折算,对应 CLOPS)分列;不保真度界按 与 计,取 、(假设值,比例沿用论文实验参数);速率为 ,总线宽 1。
| 账目 | () | () |
|---|---|---|
| 路由器 FT / BB | / (比值 1.99) | / (比值 2.0000) |
| 量子比特 FT / BB | / | / |
| 二分带宽 FT / BB | / 条线 | / 条线 |
| 查询并行度 FT / BB | / | / |
| 单查询时延 FT(层计/加权) | / | / |
| 单查询时延 BB(层计/加权) | / | / |
| 路总时延 FT / BB(加权) | / () | / () |
| 稳态摊销时延 FT / BB | / | / |
| 最大查询速率 / 带宽 FT | /s | /s(与 无关) |
| 最大查询速率 / 带宽 BB | /s | /s |
| 时空体积每查询 FT / BB | / () | / () |
| 经典换页预算 FT / BB | / | / |
| 不保真度界 FT / BB | / | / |
三条读数:其一,拓扑开销恒为两倍(路由器比 1.99→2.0000,随 收敛于 2),不随规模恶化;其二,吞吐与时空体积优势随 线性增长(;带宽 ),大规模下 Fat-Tree 的相对收益只会更大;其三,噪声界的相对劣化钉死在 25%,绝对值却随 爬升——、 已到 0.2,意味着大规模共享查询必须叠加蒸馏或纠错才能交付,单靠器件韧性到不了密码分析规模。
讨论:换了什么,没换什么
没换的:全部渐近账与 BB 同型—— 比特、 单查询时延、 不保真度;干预与能量口径也不变:路径独立性仍要求外部控制覆盖全部 节点(见 成本口径:激活门、干预与能量 推导三),胖树的复制甚至把节点数翻倍,对 Jaques–Rattew 式批判不构成回应——它优化的是吞吐,不是”每次查询动多少硬件”。
换了的:常数与并行度。三个 单价(比特 ×2、时延 +25%、不保真度 +25%)买来 路查询级流水,把共享场景的总时延从 压到 、带宽从 抬到 、时空体积从 压到 。适用边界同样清楚:收益属于独立查询流(或可分段并行的算法);经典侧要承受常数换页预算;布图要多一层平面;要更高并行度得付 (D-Fat-Tree)。在 评价指标:六维打分卡 的口径下,Fat-Tree 动的是”带宽/吞吐”维度,其余维度对 BB 的相对位置原样保留——这也是它适合作共享 QRAM 基线而非通用替代的原因。